Software Engineer

Alexis Alulema

Ingeniero de Software · Builder

Ingeniero de Software con más de 20 años convirtiendo problemas complejos en soluciones escalables — en software, cloud, IA y hardware.

MCP Conversa con este sitio desde tu asistente de IA

Pruébalo en vivo

Proyectos de IA reales que puedes levantar bajo demanda — cada uno con su propio entorno efímero.

Ver todos los proyectos →
Demo en vivo

Planificador de Viajes (Cadena de Agentes)

Escribe un pedido de viaje y mira cómo una cadena de agentes especializados se pasa el trabajo en tiempo real hasta entregar un itinerario día a día verificado contra tu presupuesto. Un orquestador en LangGraph controla el flujo; un Qwen 2.5 local solo redacta la prosa, mientras las decisiones tipadas y la aritmética resuelven el resto. Si el plan se pasa del presupuesto, un agente de resolución de conflictos lo renegocia sin intervención humana. LLM local (Qwen 2.5 vía Ollama), sin API keys; datos en vivo de clima, lugares y tipo de cambio desde fuentes abiertas.

PythonFastAPILangGraph
Probar el demo en vivo →
Demo en vivo

Agentic Racing

Seis autos idénticos corren un circuito cerrado en el navegador. Cada auto es un agente de dos capas: un piloto que conduce cada frame, y un jefe de equipo LLM independiente que lee la telemetría en vivo y radía una estrategia — atacar, defender, conservar — al estilo de la radio de equipo en F1, en pantalla. La carrera nunca espera al modelo: una heurística fija toma el control apenas está lento, apagado, o responde un JSON inválido. Totalmente autohospedado: un llama3.2:3b local detrás de un proxy con su propio circuit breaker, rate limit y control de concurrencia.

Unity WebGLPythonFastAPI
Probar el demo en vivo →
Demo en vivo

Chatbot RAG sobre Posts del Blog

Un chatbot interactivo de generación aumentada por recuperación que responde preguntas usando mis posts del blog como base de conocimiento. Totalmente autohospedado: búsqueda vectorial semántica (pgvector) con embeddings multilingües y un LLM Qwen 2.5 local servido por Ollama — sin APIs de LLM externas.

PythonFastAPIpgvector
Probar el demo en vivo →
10 min de lectura

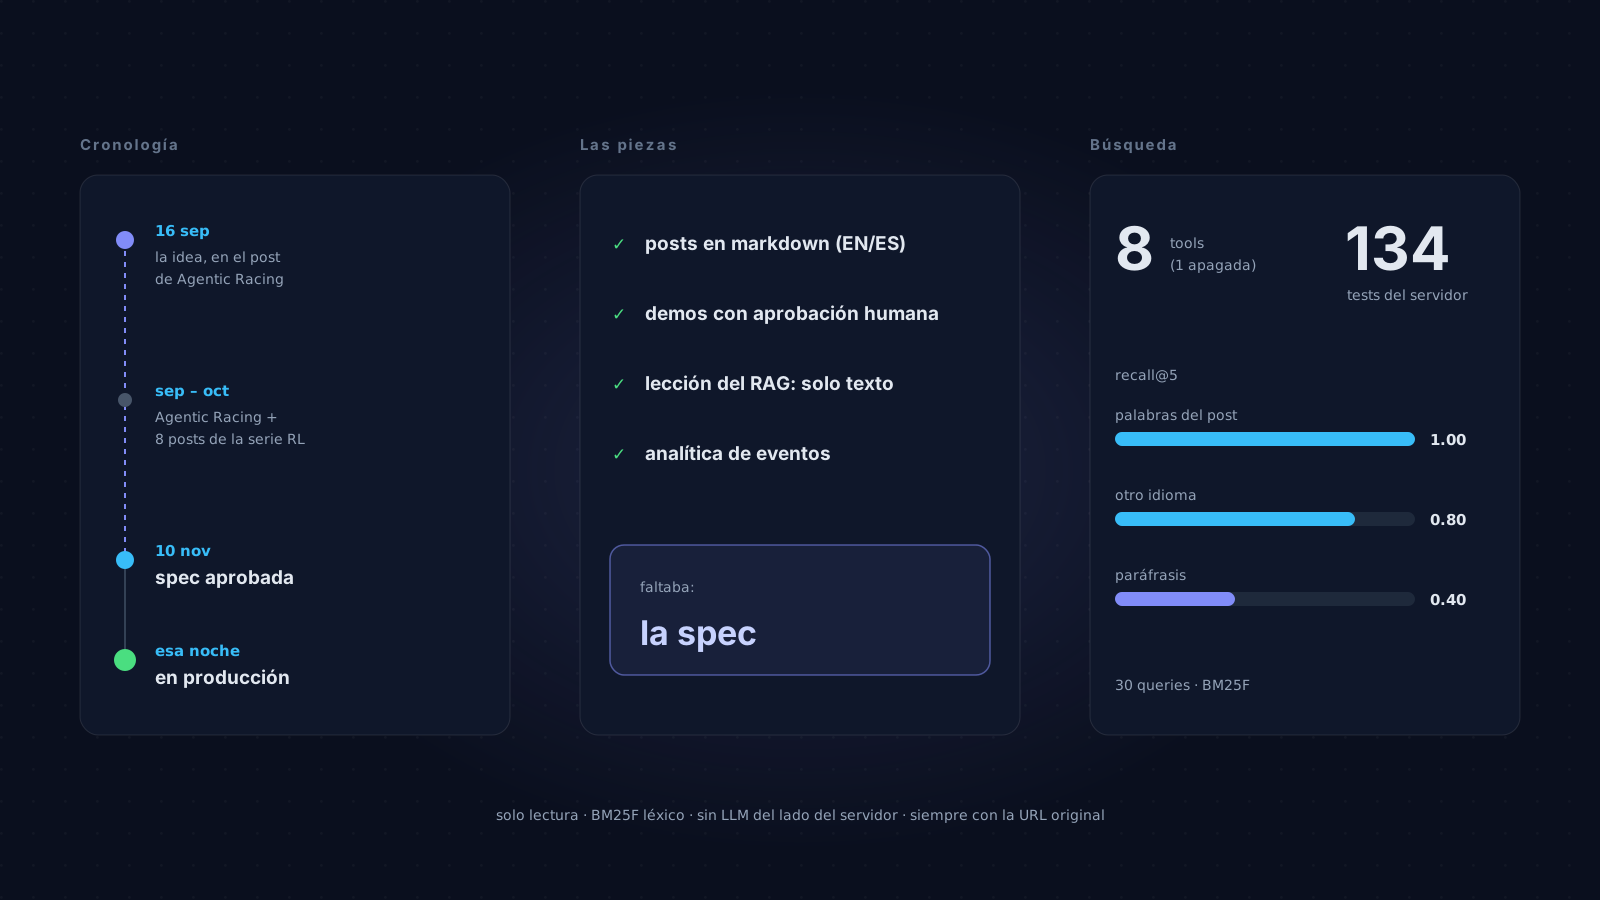
El servidor MCP que esperó casi dos meses (y salió en una noche)

Este blog ahora también es un servidor MCP de solo lectura: cualquier asistente de IA puede buscar y leer los posts y revisar los demos, citando siempre la URL original. La idea la tenía desde septiembre y casi todas las piezas ya existían, pero los demos, sobre todo Agentic Racing, iban primero. Cuando por fin terminé la spec, el servidor estuvo en producción esa misma noche. Este post cuenta por qué tardé, qué faltaba de verdad y cómo quedó la búsqueda: recall@5 de 1.00 con las palabras del post y 0.40 con paráfrasis.

mcpagentsllmraginformation-retrievalpython
16 min de lectura

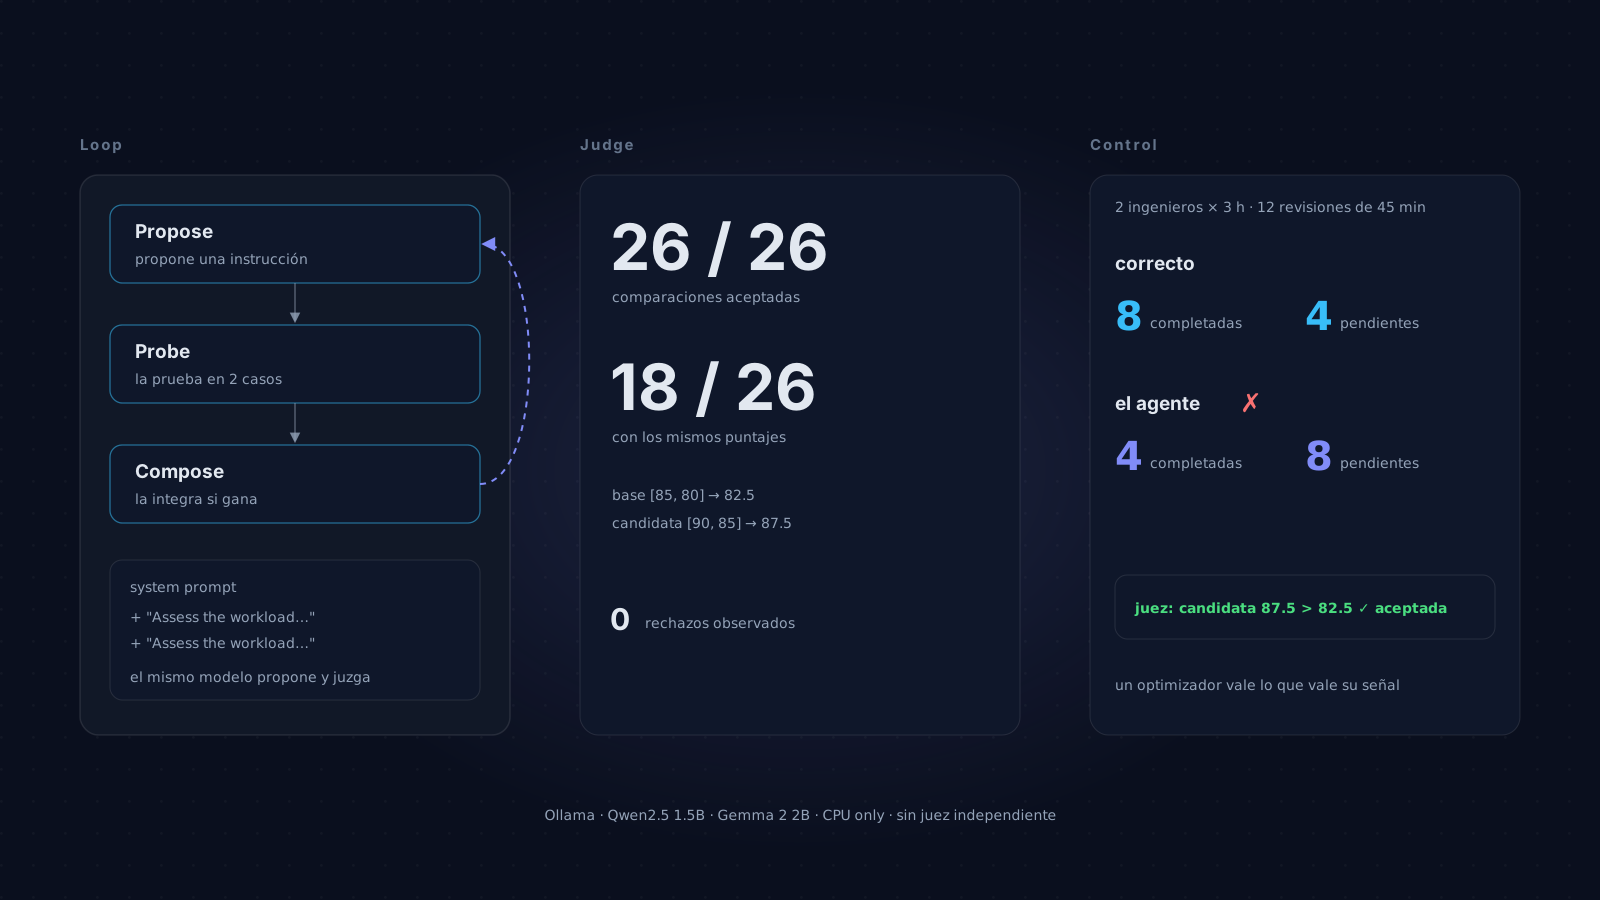
Harness²: un agente que mejora sus propias instrucciones (y un juez que siempre dijo que sí)

Llevé a un demo en vivo la idea central de Harness², de Google Research: mejorar un agente cambiando su harness de ejecución, no el modelo, en un ciclo Propose → Probe → Compose. Con modelos de 1.5B y 2B en CPU y el mismo modelo como juez, las 26 comparaciones que registré aceptaron el cambio propuesto, 18 de ellas con exactamente los mismos puntajes, y el juez premió respuestas con la aritmética invertida. Este post cuenta qué construí, cómo lo medí, por qué sin un verificador independiente un optimizador no tiene cómo saber si mejoró, y en qué condiciones usaría Harness² en mis próximos proyectos.

agentsllmllm-evaluationprompt-engineeringollamapythonfastapi
16 min de lectura

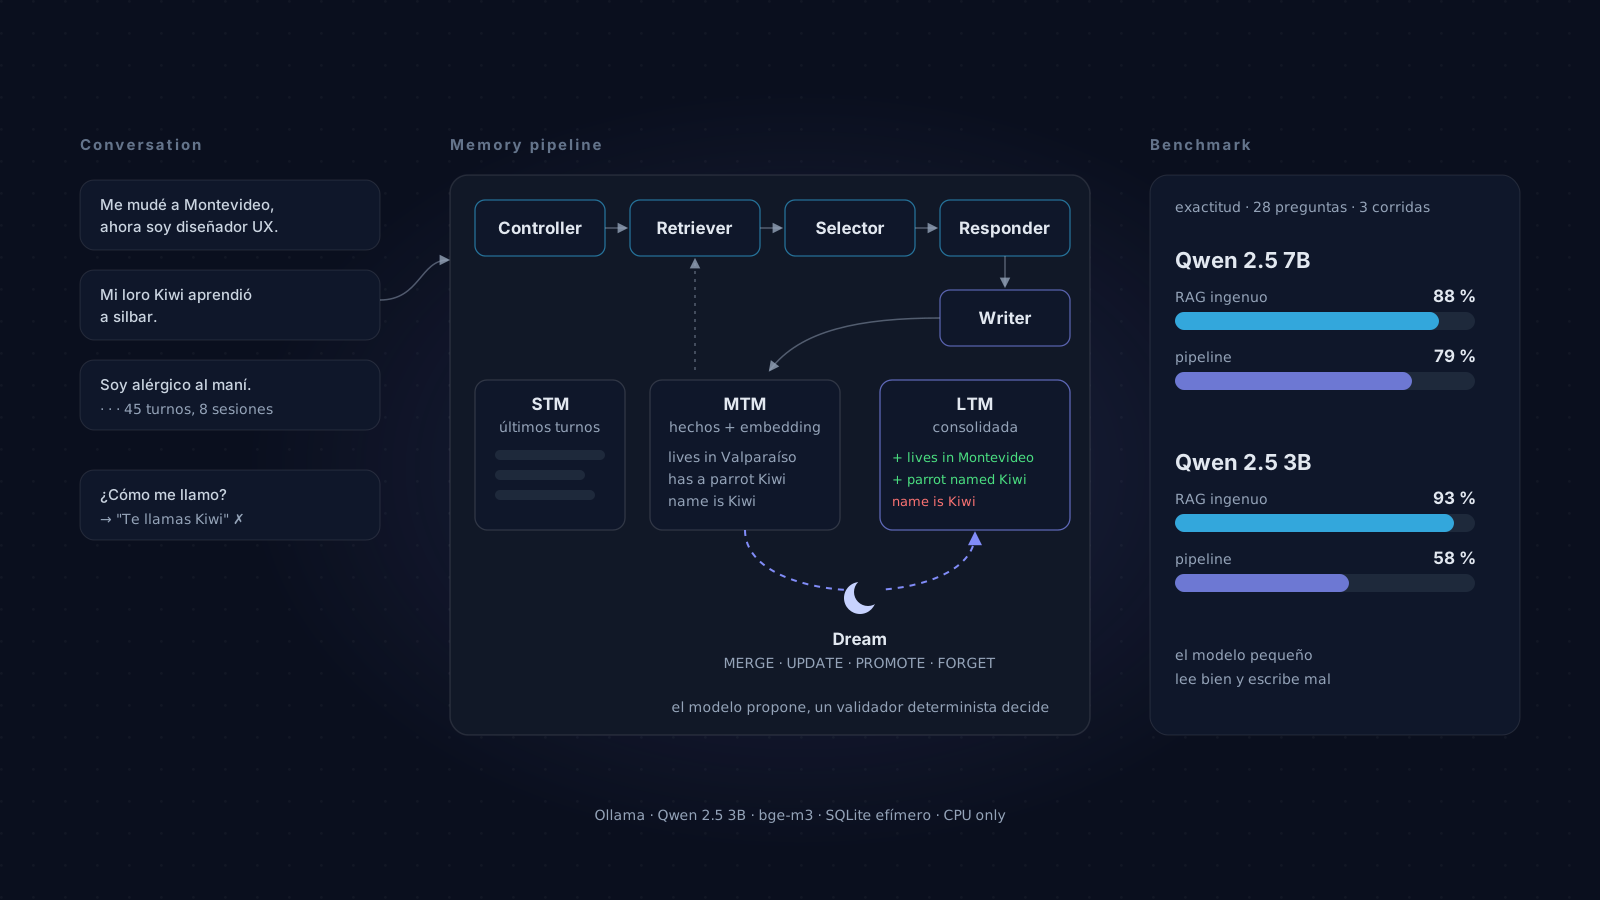
El agente que sueña: memoria en tres niveles con un modelo pequeño (y un RAG ingenuo que le ganó)

Llevé a un demo la arquitectura de memoria de LightMem: un agente que guarda hechos mientras conversa y que, cuando le pides que "sueñe", consolida su memoria —fusiona, actualiza, promueve y olvida— con un diff visible. Todo local, con modelos de 3B y 7B. Lo medí contra un RAG ingenuo con tres corridas por condición, y perdió: 79 contra 88 % con 7B, 58 contra 93 % con 3B. Este post cuenta qué construí, dónde se rompe y por qué, con modelos pequeños, la mejor memoria resultó ser la que menos reescribe.

agentsllmmemoryragollamapythonfastapiembeddings