Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir (este artículo)
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema
Introducción
Cuando pensamos en enseñar a conducir a una persona, la solución parece relativamente sencilla: explicamos las reglas, mostramos ejemplos, dejamos que practique y corregimos sus errores.
Pero ¿cómo hacemos algo parecido con un agente de inteligencia artificial?
Un agente no sabe inicialmente qué significa “girar”, “frenar”, “ir rápido” o incluso “conducir bien”. No podemos simplemente decirle:
“Toma esta curva a 80 km/h.”
Tenemos que construir un mundo en el que pueda observar, actuar, recibir una señal que indique si su comportamiento fue bueno o malo y volver a intentarlo.
Ese es el punto de partida del Reinforcement Learning (RL).
En este artículo voy a explicar las ideas fundamentales de RL utilizando Agentic Racing, un proyecto de simulación de carreras en Unity, como laboratorio práctico. La intención no es comenzar con las matemáticas de un algoritmo concreto, sino entender primero el problema que estamos intentando resolver.
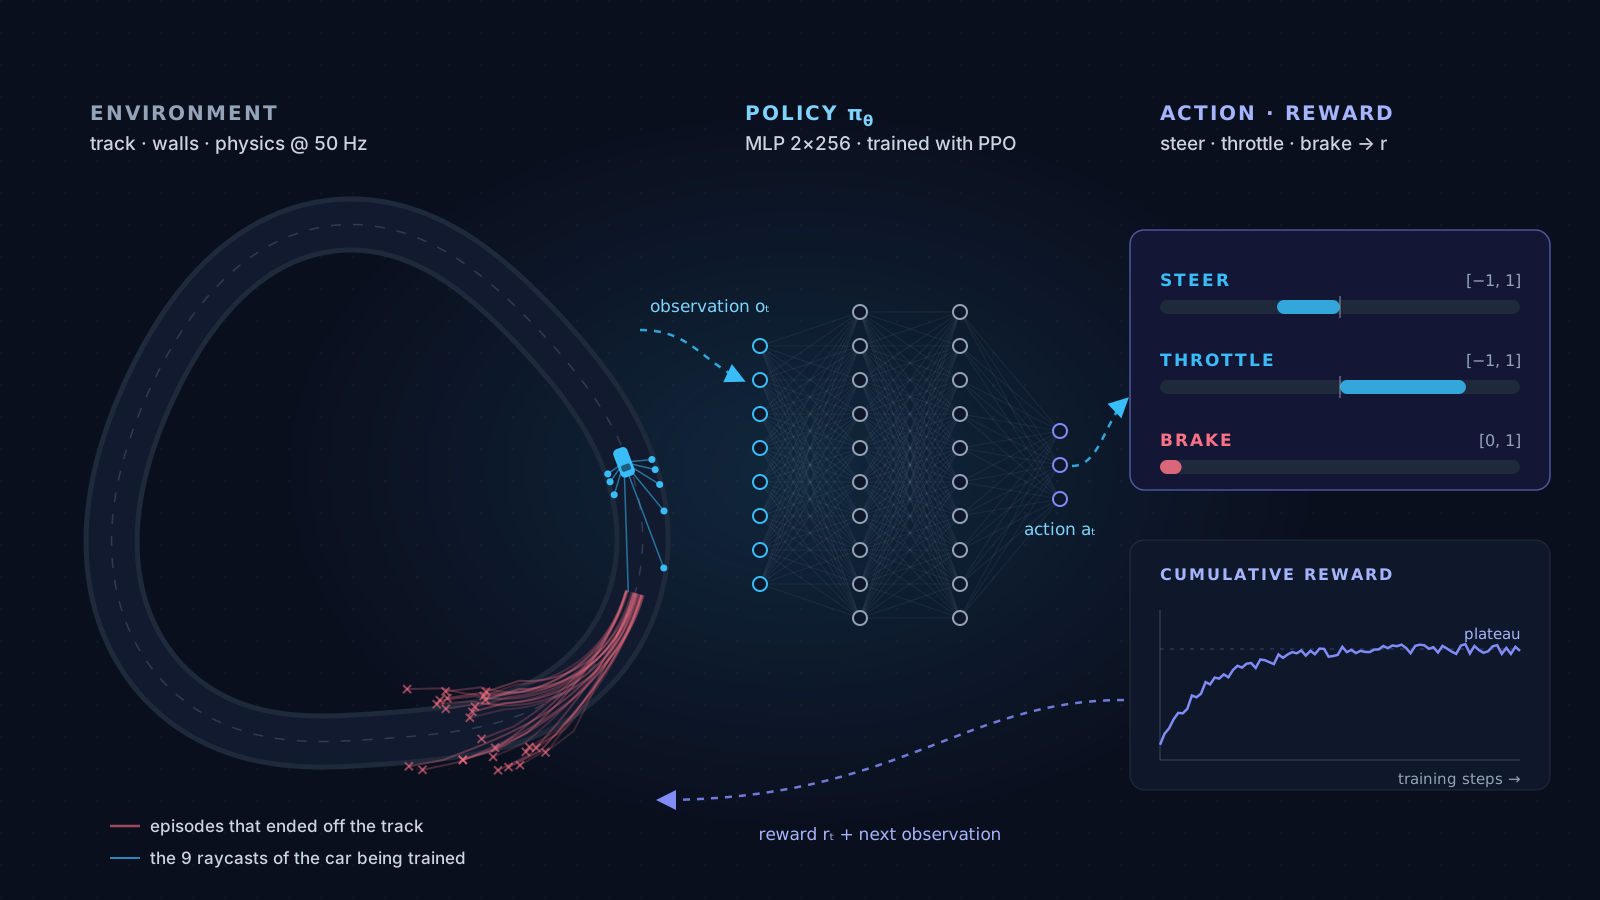
Antes de empezar, una advertencia honesta: en Agentic Racing el piloto RL nunca aprendió a dar una vuelta completa. Ocho corridas de entrenamiento con PPO se estancaron alrededor del 10–13% de una vuelta, y el demo terminó usando un piloto escrito a mano. Lo conté en detalle en Agentic Racing: un piloto que nunca aprendió a manejar. Lejos de restarle valor como laboratorio, eso lo vuelve más útil: cada concepto de este artículo tiene detrás un número real, una decisión de diseño concreta y, a veces, un fracaso que lo explica mejor que cualquier ejemplo de libro.
La pregunta fundamental es:
¿Cómo aprende un agente qué hacer cuando nadie le proporciona directamente la respuesta correcta?
1. El aprendizaje por refuerzo visto como un juego
La forma más sencilla de imaginar Reinforcement Learning es como una interacción repetida entre dos elementos:
- un agente, que toma decisiones;
- un entorno, que responde a esas decisiones.
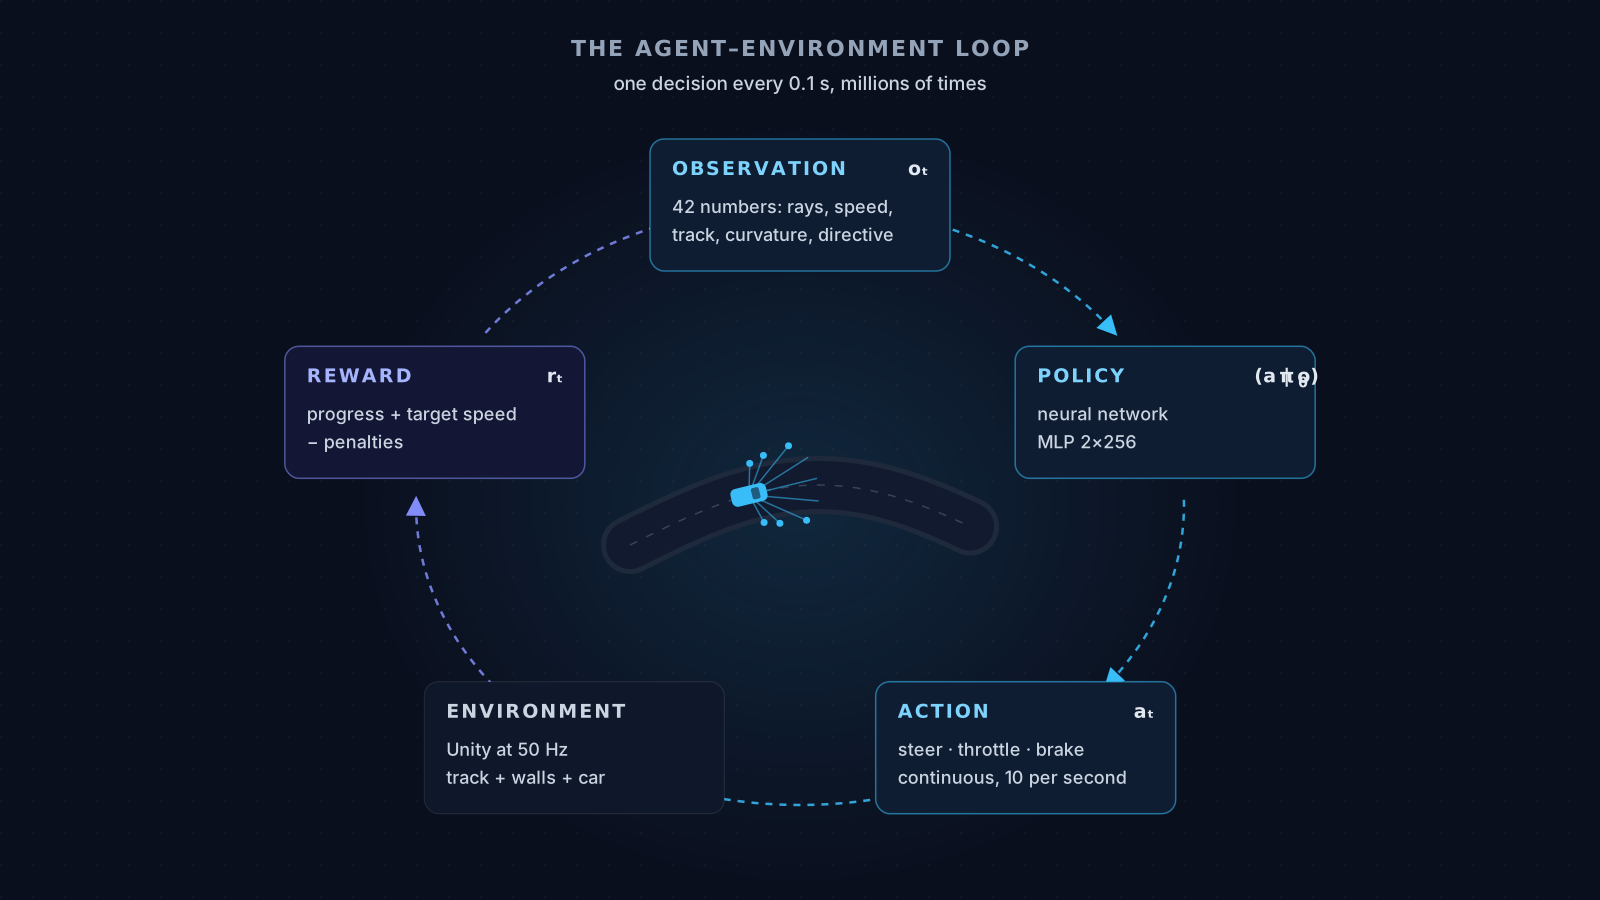
El agente observa el entorno, elige una acción y recibe las consecuencias de esa acción: una recompensa y una nueva observación.
Después vuelve a observar y decide nuevamente.
Y repite este proceso miles o millones de veces. En Agentic Racing, “millones” es literal: cada corrida de entrenamiento fue de 4 a 20 millones de pasos.
Esto es importante porque el agente no recibe la respuesta correcta en cada paso.
En aprendizaje supervisado podríamos tener:
entrada → respuesta correctaPor ejemplo:
imagen de una curva → "girar a la izquierda"En Reinforcement Learning, en cambio, tenemos:
observación → acción → consecuencia → recompensaEl agente tiene que descubrir qué acciones tienden a producir mejores resultados.
2. Nuestro ejemplo: un automóvil que quiere aprender a conducir
En Agentic Racing tenemos un problema muy concreto:
Queremos que un automóvil aprenda a conducir dentro de un entorno de carreras simulado.
Esto convierte conceptos bastante abstractos de Reinforcement Learning en algo mucho más fácil de visualizar.
Nuestro agente está dentro de un automóvil. Tiene cierta información sobre lo que ocurre a su alrededor, puede controlar el volante, el acelerador y el freno, y recibe señales que le indican si su comportamiento está ayudando o perjudicando su objetivo.
En el proyecto, estas piezas tienen nombre propio. El entorno de entrenamiento es una
TrainingArena: un circuito generado a partir de una semilla, con muros invisibles en los bordes.
El agente es un RaceAgent, una clase de ML-Agents
(el toolkit de RL de Unity). Las acciones las ejecuta un CarController, que convierte volante,
acelerador y freno en fuerzas sobre un Rigidbody. Y la física la resuelve el motor de Unity
50 veces por segundo:
                 ┌──────────────────────────────┐
                 │  TrainingArena               │
                 │  circuito (seed) + muros     │
                 └──────────────┬───────────────┘
                                │ observaciones (42 números)
                                ▼
                 ┌──────────────────────────────┐
                 │  RaceAgent (ML-Agents)       │
                 │  policy: red neuronal MLP    │
                 └──────────────┬───────────────┘
                                │ acciones: steer, throttle, brake
                                ▼
                 ┌──────────────────────────────┐
                 │  CarController               │
                 │  fuerzas sobre el Rigidbody  │
                 └──────────────┬───────────────┘
                                │
                                ▼
                 ┌──────────────────────────────┐
                 │  Física de Unity (50 Hz)     │
                 │  posición, velocidad, rumbo  │
                 └──────────────┬───────────────┘
                                │
                                ▼
                 ┌──────────────────────────────┐
                 │  TrackProgress               │
                 │  ¿cuánto avancé en la pista? │
                 └──────────────┬───────────────┘
                                │
                                ▼
                  recompensa + siguiente observación
Un detalle práctico: no entrenamos con un solo auto. En las corridas de entrenamiento, cada escena contenía 9 arenas, cada una con un circuito generado a partir de una semilla distinta, separadas 4 km entre sí para que los sensores de un auto no vean la pista de al lado. Y corríamos 4 procesos de esa escena en paralelo. Eran 36 autos alimentando una sola policy al mismo tiempo, recorriendo nueve trazados distintos para no aprender de memoria una única pista.
Y un detalle de contexto: en el diseño completo del proyecto, este piloto es solo la mitad del sistema. Encima de él hay un “jefe de equipo”, un LLM que razona sobre la carrera y le manda directivas. En este artículo nos quedamos con el piloto, que es donde vive el RL.
3. ¿Qué significa “estado”?
Antes de que el agente pueda decidir qué hacer, necesitamos describir de alguna manera la situación en la que se encuentra.
En Reinforcement Learning solemos hablar del estado, que representamos como:
donde representa el instante actual.
Conceptualmente, el estado del automóvil podría contener información como:
- posición respecto de la pista;
- orientación del automóvil;
- velocidad;
- proximidad de los límites;
- geometría de la pista;
- dirección de la próxima curva;
- progreso en la vuelta.
Pero aquí aparece una distinción importante.
Estado ≠ observación
El estado representa idealmente toda la información relevante del entorno.
El agente, sin embargo, puede no tener acceso directo a todo ese estado. Lo que recibe es una observación:
Es decir:
“Esto es lo que el agente puede ver o conocer en este momento.”
En un sistema de conducción autónoma real tendríamos cámaras, LiDAR, GPS, IMU, velocidad, etc. En un simulador tenemos la ventaja de poder elegir qué información le damos al agente.
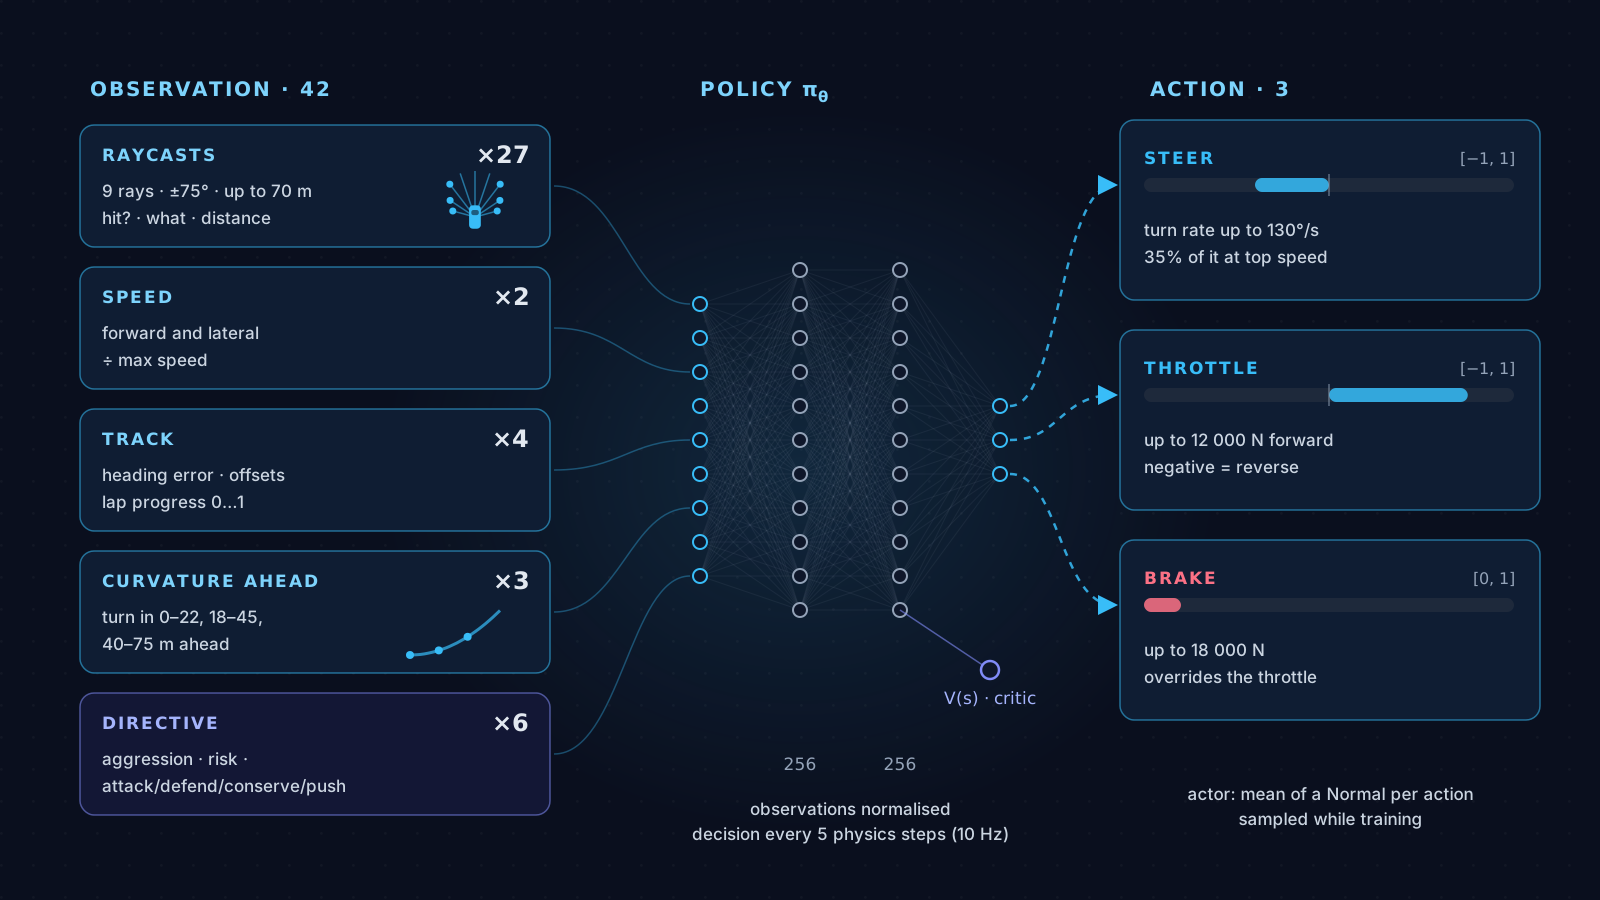
En Agentic Racing, el piloto recibe 42 números en cada decisión:
| Grupo | Cantidad | Qué contiene |
|---|---|---|
| Raycasts | 27 | 9 rayos en abanico de ±75°, de hasta 70 m, que detectan los muros del borde (3 valores por rayo: si chocó, contra qué y a qué distancia) |
| Velocidad | 2 | velocidad longitudinal y lateral, normalizadas por la velocidad máxima |
| Relación con la pista | 4 | error de rumbo respecto a la trazada ideal, desplazamiento lateral del auto y de la trazada ideal respecto al centro, progreso en la vuelta (0 a 1) |
| Curvatura por delante | 3 | cuánto gira la pista entre 0–22 m, 18–45 m y 40–75 m por delante |
| Directiva | 6 | agresividad, tolerancia al riesgo y el tipo de directiva (attack, defend, conserve, push) |
Igual de interesante es lo que no ve: su posición absoluta en el mapa, el resto del circuito más allá de 75 metros, los otros autos, la clasificación o los tiempos de vuelta. Es una observación parcial a propósito: ese contexto global es justamente lo que ve el jefe de equipo, y no el piloto.
Los últimos seis números merecen una explicación. Son los canales por los que el estratega le habla al piloto. Durante el entrenamiento nadie los escribe todavía, así que se aleatorizan en cada episodio. De esa forma la policy aprende a conducir distinto según la directiva que recibe, en lugar de aprender a ignorarla. Si se entrenara sin esos canales y se agregaran después, habría que reentrenar desde cero.
Esto nos lleva a una decisión de diseño fundamental.
Si damos demasiada información, el problema puede resultar artificialmente sencillo, o la policy puede apoyarse en datos que no tendrá cuando se use en serio.
Si damos demasiado poca, el agente quizá no tenga suficiente información para tomar buenas decisiones.
Agentic Racing lo vivió en carne propia. Las seis primeras corridas no tenían las tres observaciones de curvatura por delante. El agente solo “veía” con los raycasts, que entonces llegaban a 40 m: a 15 m/s eso es menos de tres segundos de anticipación. No veía venir las curvas. En la séptima se agregaron la curvatura por delante y los rayos de 70 m, junto con una nueva recompensa de velocidad. El crítico empezó a entender mucho mejor el mundo (lo veremos en la sección 9), pero la fracción de vuelta completada casi no se movió. Una mejor observación era necesaria, pero no suficiente.
Por eso:
Diseñar las observaciones también forma parte del problema de Reinforcement Learning.
4. ¿Qué puede hacer el agente?
Ahora necesitamos definir las acciones. Llamemos a una acción:
En Agentic Racing, el espacio de acciones es continuo y tiene tres dimensiones. La red no elige entre opciones como “izquierda” o “derecha”: produce tres números reales.
| Acción | Rango | Qué hace en el CarController |
|---|---|---|
steer | −1 a 1 | gira el auto con una velocidad angular de hasta 130°/s, que se reduce al 35% a velocidad máxima |
throttle | −1 a 1 | aplica hasta 12 000 N de fuerza hacia adelante; los valores negativos son reversa |
brake | 0 a 1 | aplica hasta 18 000 N de frenado y, mientras está activo, anula el acelerador (la red produce valores entre −1 y 1; para el freno solo cuenta la mitad positiva) |
Encima de eso hay un modelo de agarre lateral: cuando el auto gira, los neumáticos redirigen la mayor parte de la velocidad lateral hacia adelante en lugar de perderla. Más adelante veremos por qué ese detalle importó tanto.
El agente no decide en cada paso de física. Decide cada 5 pasos, o sea 10 veces por segundo, y repite la última acción entre una decisión y la siguiente.
El agente podría encontrarse, por ejemplo, ante una curva a la izquierda.
No queremos programar manualmente:
IF curve_is_left:
    steering = -0.42
    throttle = 0.71
Queremos que el agente aprenda una policy que descubra por sí misma qué acción conviene dadas sus observaciones.
5. La policy: la estrategia del agente
Aquí aparece uno de los conceptos más importantes de todo RL.
La policy es la estrategia que utiliza el agente para elegir acciones.
Matemáticamente podemos escribir:
o, cuando trabajamos explícitamente con observaciones:
La idea es:
“Dada esta situación, ¿qué debería hacer?”
En un agente basado en una red neuronal, la policy se implementa mediante una función parametrizada:
donde representa los parámetros (los pesos) de la red neuronal.
En nuestro caso, la red es un MLP pequeño: 2 capas ocultas de 256 neuronas, con las observaciones normalizadas. Como las acciones son continuas, la red no produce directamente “la” acción: produce el centro de una distribución normal para cada una de las tres acciones. Durante el entrenamiento la acción se muestrea de esa distribución, lo que le permite al agente probar variaciones. Por eso escribimos como una probabilidad y no como una función que devuelve un único valor.
Inicialmente, esa policy no sabe conducir. Sus parámetros no contienen mágicamente conocimiento sobre carreras.
Tenemos que conseguir que cambien de manera que las acciones que producen buenos resultados sean cada vez más probables.
Y aquí entra el elemento fundamental del aprendizaje por refuerzo.
6. La recompensa: decirle al agente qué nos importa
¿Cómo sabe el agente que una acción fue buena?
Le damos una recompensa. La recompensa en el instante se suele representar como:
Podemos pensar en ella como una señal numérica:
acción buena       → recompensa positiva
acción mala        → recompensa negativa
Pero esto es una simplificación. En un problema real de RL, diseñar la recompensa suele ser mucho más difícil.
Así quedó la función de recompensa del RaceAgent en la última corrida de entrenamiento (la
octava), después de siete versiones:
| Componente | Tipo | Valor | Para qué existe |
|---|---|---|---|
| Progreso | por metro | +0.02 | avanzar a lo largo de la pista |
| Velocidad objetivo | por segundo | hasta +0.25 | ir a la velocidad adecuada para la curva que viene |
| Lentitud | por segundo | hasta ~−0.1 | castigo extra solo si va muy por debajo de esa velocidad |
| Trazada ideal | por segundo | hasta +0.05 | ir alineado y cerca de la trazada ideal, solo si el auto se mueve |
| Cercanía al borde | por segundo | hasta −0.6 | crece a medida que el auto se acerca al muro |
| Golpe contra el muro | por evento | −0.1 | cada contacto con el borde |
| Detenido | por segundo | −0.3 | mientras el auto está parado |
| Fin del episodio por fallo | por evento | −1 | salirse de la pista, atascarse, ir en sentido contrario o no avanzar |
| Vuelta completa | por evento | +12, más hasta +8 | terminar la vuelta, con un bono mayor cuanto más rápido |
En cada paso, la recompensa es la suma de los componentes que aplican:
El componente más interesante es el de velocidad. En las primeras versiones, más velocidad siempre sumaba más recompensa, así que frenar para una curva era puro costo y el agente aprendió exactamente eso: no frenar nunca. La versión final calcula una velocidad objetivo según la curvatura que viene:
donde es el mayor cambio de rumbo de la pista en los próximos ~55 metros. La recompensa es máxima justo en esa velocidad y cae hacia ambos lados:
Con eso, frenar antes de una curva cerrada deja de ser puro costo: hay una zona donde frenar paga más que no frenar.
7. El agente no aprende de una recompensa aislada
Aquí aparece una de las ideas que inicialmente pueden resultar contraintuitivas.
Supongamos que el automóvil hace esto:
acelera
   ↓
se acerca a una curva
   ↓
frena
   ↓
gira
   ↓
mantiene la pista
   ↓
avanza mucho
La recompensa importante no aparece inmediatamente después de frenar. De hecho, en el instante en que frena, el auto avanza menos y gana menos recompensa de progreso. El beneficio llega segundos después, cuando sigue en pista en lugar de estrellarse.
Por eso no queremos que el agente simplemente pregunte:
“¿Esta acción me dio recompensa?”
Queremos que aprenda:
“¿Qué consecuencias futuras tuvieron mis acciones?”
Esto nos lleva al concepto de return.
8. Return: pensar en recompensas futuras
El return representa la recompensa acumulada que obtenemos a partir de un determinado momento.
Una formulación habitual es:
donde:
es el discount factor.
El parámetro controla cuánto valor damos a las recompensas futuras. Si es cercano a 1, el agente tiene en cuenta consecuencias más lejanas. Si es menor, presta relativamente más atención a las recompensas inmediatas.
Podemos verlo así:
ahora          futuro cercano       futuro lejano

 rₜ       +      γ rₜ₊₁       +       γ² rₜ₊₂
 │                 │                    │
peso 1           peso γ               peso γ²
En Agentic Racing usamos , y el descuento se aplica por decisión, es decir, cada 0.1 segundos. Eso da una idea muy concreta de cuánto “mira hacia adelante” el agente:
- una recompensa a 200 decisiones (20 segundos) pesa ;
- una recompensa a 900 decisiones (90 segundos, más o menos lo que dura una vuelta) pesa .
En otras palabras, la frenada que salva una curva dentro de dos segundos está muy dentro del horizonte del agente. El bono por terminar la vuelta, visto desde la salida, casi no existe. Por eso la recompensa necesita señales densas, como el progreso o la velocidad objetivo, que lleguen pronto.
Todo esto permite expresar algo muy importante:
Una acción puede ser mala a corto plazo pero buena a largo plazo.
Frenar antes de una curva reduce momentáneamente la velocidad, pero permite tomar mejor la curva y completar la vuelta más rápido. El agente tiene que aprender ese tipo de relación.
9. ¿Cómo sabemos si un estado es bueno?
Aquí aparece otro concepto fundamental: la función de valor.
La función de valor intenta estimar:
“Si estoy en este estado y continúo siguiendo esta policy, ¿cuánta recompensa futura espero obtener?”
                    estado
                      │
                      ▼
              ┌──────────────┐
              │     V(s)     │
              └──────┬───────┘
                     │
                     ▼
              valor esperado
Un estado como:
automóvil centrado
+ buena velocidad
+ entrando correctamente
  en una curva
podría tener un valor alto. Mientras que:
automóvil pegado al muro
+ orientación incorrecta
+ poca velocidad
podría tener un valor bajo.
La función de valor no dice directamente qué acción tomar. Dice algo más parecido a:
“¿Qué tan prometedora es esta situación?”
En PPO, esta función la aprende una segunda red, conocida como crítico, que se entrena junto
con la policy. ML-Agents reporta qué tan bien predice en una métrica llamada Value Loss. En las primeras corridas de
Agentic Racing esa pérdida subía a lo largo del entrenamiento (de 0.12 a 0.27 en la primera
corrida, hasta 0.52 en la sexta): el crítico no lograba anticipar lo que iba a pasar. Cuando el
agente empezó a recibir la curvatura de la pista por delante, la pérdida quedó estable en 0.22. Con
mejores observaciones (y una recompensa nueva en la misma corrida), el crítico por fin podía
distinguir un estado prometedor de uno condenado. Que el crítico entienda el mundo, sin embargo,
no garantiza que la policy aprenda a moverse bien en él.
10. Q(s,a): valorar una acción concreta
También podemos preguntar algo ligeramente diferente:
“¿Qué tan buena es esta acción concreta estando en este estado?”
Eso nos lleva a:
La diferencia conceptual es:
V(s)
│
└── ¿Qué tan bueno es estar aquí?

Q(s,a)
│
└── ¿Qué tan bueno es hacer esta acción aquí?
Por ejemplo:
Estado:
curva cerrada a la izquierda, a alta velocidad

Acción A:
seguir acelerando

Acción B:
frenar y girar

Q(s,A) → probablemente menor
Q(s,B) → probablemente mayor
Los valores exactos no los conocemos de antemano. El agente tiene que estimarlos a partir de su experiencia.
11. Advantage: ¿esta acción fue mejor de lo esperado?
Ahora podemos combinar las ideas anteriores.
El advantage se define como:
La interpretación es extremadamente útil:
“¿Esta acción es mejor o peor de lo que normalmente espero en este estado?”
Si , la acción es mejor que el promedio de lo que la policy suele hacer ahí.
Si , es peor.
En la práctica no conocemos ni exactamente. El advantage se estima a partir de las
recompensas que se observaron después de cada acción y de la predicción del crítico. Ese es el
papel del parámetro lambd: 0.95 de nuestra configuración, del que hablaremos en el próximo
artículo.
Esto resulta especialmente importante para algoritmos como PPO, que veremos en el siguiente artículo.
12. Entonces, ¿cómo aprende realmente la red?
Hasta ahora tenemos:
observación
     ↓
policy
     ↓
acción
     ↓
entorno
     ↓
recompensa
     ↓
experiencia
El proceso de aprendizaje consiste en utilizar esas experiencias para modificar los parámetros de la policy.
Al principio tenemos una policy prácticamente inútil:
observación
    ↓
"girar"
    ↓
sale de la pista
Después de muchas experiencias, queremos que las acciones que históricamente producen mejores resultados tengan mayor probabilidad.
En ML-Agents, ese ciclo tiene números concretos. Los 36 autos juntan experiencia hasta llenar un buffer de 20 480 decisiones. Con ese buffer, la red hace 3 pasadas en bloques de 2 048. Después la experiencia se descarta y se junta otra nueva con la policy actualizada. PPO es un algoritmo on-policy: solo aprende de la experiencia generada por su versión actual.
                 EXPERIENCIA

      ┌───────────────────────────────┐
      │ observación                   │
      │ acción                        │
      │ recompensa                    │
      │ siguiente observación         │
      └───────────────┬───────────────┘
                      │
                      ▼
                 aprendizaje
                      │
                      ▼
              actualizar policy
                      │
                      ▼
               nueva policy
                      │
                      ▼
                 más experiencia
                      │
                      └───────────► ...
El agente entra en un ciclo:
observar → actuar → recibir feedback → aprender → volver a actuar
13. El entrenamiento es diferente de la ejecución
Hay otra distinción importante.
Durante el entrenamiento queremos que el agente explore. Durante la ejecución de una policy entrenada queremos que tome decisiones útiles.
              TRAINING

      explorar → equivocarse
          ↓
      recibir reward
          ↓
      actualizar policy
          ↓
      volver a intentar
La exploración en Agentic Racing viene de dos lugares: las acciones se muestrean de una
distribución (no se toma siempre la más probable) y el algoritmo premia que esa distribución no se
cierre demasiado pronto, mediante un término de entropía (el parámetro beta de la
configuración). La entropía de la policy es una buena medida de cuánto está explorando. En la primera corrida bajó de
1.42 a 0.82 a lo largo de 20 millones de pasos: el agente fue volviéndose más seguro de sí mismo,
aunque, como veremos, no necesariamente de lo correcto.
Una vez entrenada, la policy se exporta a un archivo .onnx y corre sin el algoritmo de
entrenamiento. El plan era ejecutarla dentro del navegador con el motor de inferencia de Unity.
Esa parte se validó en el proyecto con un modelo de juguete, a 0.1 ms por inferencia. El problema
estuvo en otro lado.
El objetivo del entrenamiento no es evitar todos los errores. Los errores son precisamente una fuente de información. Si el automóvil gira demasiado pronto y se sale de la pista, esa experiencia contribuye a que la policy aprenda que ese comportamiento no es deseable.
Por supuesto, para que esto funcione necesitamos:
- un entorno razonablemente correcto;
- observaciones informativas;
- acciones bien definidas;
- una función de recompensa adecuada;
- un algoritmo de aprendizaje apropiado.
Y aquí aparece una lección importante de ingeniería:
Si el agente no aprende, no necesariamente significa que el algoritmo de RL esté mal.
El problema puede estar en cualquiera de las piezas del sistema.
14. El entorno también forma parte del problema
Este punto es especialmente importante en Agentic Racing.
Un algoritmo de RL puede ser matemáticamente correcto y aun así producir un agente que no aprende. ¿Por qué? Porque el agente aprende a partir del mundo que le hemos construido.
                    ┌──────────────┐
                    │ OBSERVATIONS │
                    └──────┬───────┘
                           │
                           ▼
                    ┌──────────────┐
                    │    POLICY    │
                    └──────┬───────┘
                           │
                           ▼
                    ┌──────────────┐
                    │    ACTIONS   │
                    └──────┬───────┘
                           │
                           ▼
              ┌────────────────────────┐
              │      ENVIRONMENT       │
              │                        │
              │ physics + track + car  │
              └────────────┬───────────┘
                           │
                           ▼
                         REWARD
                           │
                           └──────► LEARNING
Cada bloque puede convertirse en una fuente de problemas, y en Agentic Racing casi todos lo fueron:
Si la recompensa está mal diseñada, el agente encuentra una manera de maximizarla sin hacer la tarea. Esto se conoce como reward hacking. En la cuarta corrida, quedarse detenido terminaba el episodio con una penalización de −1. El agente aprendió la policy óptima para esa recompensa: aprovechar el impulso inicial, rodar unos 245 metros cobrando progreso (), detenerse y aceptar el −1. El resultado eran unos +4 por episodio, muy cerca del valor en el que se estancó la curva de entrenamiento. Morir rápido era la mejor estrategia disponible. La corrección fue que detenerse dejara de terminar el episodio y pasara a costar por cada segundo.
Si la recompensa empuja en la dirección equivocada, también. Premiar seguir la trazada ideal parecía razonable, pero en este proyecto la trazada ideal pasa pegada a los bordes en cada curva. Premiarla empujaba al auto contra los muros.
Si la física tiene un comportamiento inesperado, el agente aprende estrategias extrañas. El modelo de agarre lateral original borraba la velocidad lateral del auto en lugar de redirigirla. Resultado: girar con fuerza a 13 m/s frenaba el auto casi en seco. Cualquier giro agresivo era un frenazo, así que tanto el agente como el controlador de referencia “aprendieron” a no girar, que es lo mismo que no tomar curvas.
Si el mundo está roto, nada lo compensa. Las pistas generadas proceduralmente tenían tramos con geometría degenerada y curvas que ni un controlador escrito a mano podía tomar.
Por eso un proyecto de RL no consiste simplemente en:
instalar PPO
↓
entrenar
↓
tener un automóvil autónomo
15. La ficha técnica del piloto RL
Con todas las piezas sobre la mesa, así quedó definido el problema en las ocho corridas de entrenamiento:
| Pieza | En Agentic Racing |
|---|---|
| Framework | Unity ML-Agents 4.0.3 (paquete de Unity) y mlagents 1.1.0 (Python) |
| Algoritmo | PPO |
| Observación | 42 números: 27 de raycasts, más 15 de velocidad, relación con la pista, curvatura por delante y directiva |
| Acciones | 3 continuas: steer y throttle en [−1, 1], brake en [0, 1] |
| Frecuencia | física a 50 Hz, una decisión cada 5 pasos (10 por segundo) |
| Red | MLP de 2 capas × 256 neuronas, observaciones normalizadas |
| Hiperparámetros | , ; tasa de aprendizaje , y beta = 0.01 (0.005 en la primera corrida) como valores iniciales, con decaimiento lineal |
| Episodio | una vuelta; el auto aparece en un punto al azar del circuito, con ruido de rumbo (±10°) y de posición (±2 m), y ya rodando a 8 m/s |
| Fin del episodio | vuelta completa; más de 2 m fuera de la pista; 8 s detenido; 4.5 s en sentido contrario; menos de 8 m de avance en 5 s; o 4 000 pasos de física (~80 s) |
| Progreso | metros avanzados a lo largo de la línea central del circuito, medidos en cada paso |
| Paralelismo | 9 arenas por proceso × 4 procesos = 36 autos, sobre 9 circuitos procedurales distintos |
(Desde entonces el código cambió: hoy las arenas usan un único circuito fijo y el límite es de 6 000 pasos, porque una vuelta a ese circuito toma unos 95 segundos.)
Y así le fue. Ocho corridas, de 4 a 20 millones de pasos cada una, con siete versiones de la recompensa y varios arreglos de física. La fracción de vuelta que el auto completaba antes de que terminara el episodio quedó siempre alrededor del 10% (entre un 8 y un 13%). En la octava, el 91% de los episodios terminaron con el auto fuera de la pista.
Para separar los problemas de aprendizaje de los problemas del entorno, el proyecto usó un controlador escrito a mano, sin ningún aprendizaje, con la misma física y en las mismas pistas. Su mejor episodio llegó al 82% de una vuelta a 21 m/s, pero en promedio se atascaba casi tanto como el agente RL. Eso ya decía algo: si un controlador diseñado a mano tampoco podía con esas pistas, el problema no era solo del aprendizaje. La confirmación llegó al cambiar a un circuito fijo y limpio, sin generación procedural. Ahí ese controlador completó vueltas enteras sin un solo incidente.
16. ¿Qué ocurre al principio?
Imaginemos que comenzamos el entrenamiento con una policy que todavía no sabe conducir.
El comportamiento inicial es esencialmente caótico:
      🏎️
       \
        \
         → fuera de pista
En la primera corrida de Agentic Racing, durante los primeros 50 000 pasos, los episodios duraban unos cuatro segundos y la recompensa media era negativa (−1.1). El auto apenas arrancaba antes de salirse o detenerse.
El agente no tiene una representación humana de:
“Esta es una curva peligrosa.”
Solo tiene números. No piensa:
“Voy demasiado rápido.”
Tiene una observación que contiene determinados valores y debe aprender qué relación existe entre esos valores, las acciones y las consecuencias.
Después de suficientes experiencias queremos que aparezcan patrones como este:
observación:
curva cerrada + velocidad alta
            │
            ▼
        frenar
            │
            ▼
       girar mejor
            │
            ▼
      mantener pista
            │
            ▼
       más reward
Y esos patrones terminan codificados en los parámetros de la policy.
En Agentic Racing, ese patrón en particular nunca apareció. Al evaluar las policies de la tercera y la cuarta corrida, el freno promedio era 0.02 sobre 1: el agente prácticamente nunca frenaba. Había aprendido una de dos cosas. O se arrastraba a 7 m/s para poder girar sin frenar, o aceleraba a fondo y terminaba fuera de la pista o detenido poco después de la primera curva de verdad.
¿Por qué no lo descubrió? En la séptima corrida, ya con una recompensa que premiaba frenar antes de las curvas, la hipótesis fue un problema de exploración difícil. La maniobra completa de una curva (frenar, girar, volver a acelerar) es una secuencia coordinada de uno o dos segundos. El 97% de los episodios terminaban fuera de la pista a unos 200 metros de la salida, justo en esa primera curva. El agente llegaba hasta la curva una y otra vez, pero casi nunca daba por azar con la secuencia correcta, así que casi nunca vivía la experiencia que le habría enseñado que frenar valía la pena.
Esa hipótesis era cierta solo en parte. Más tarde aparecieron los problemas de física y de geometría de la pista de la sección 14, que hacían esa maniobra mucho más difícil de lo que debía ser.
17. ¿Estamos programando las reglas de conducción?
No exactamente. Esta es una diferencia fundamental entre un controlador tradicional y un agente aprendido.
En un sistema basado en reglas escribiríamos algo como esto, que es una versión simplificada del controlador de referencia que existe en el proyecto:
curva_por_delante = mayor cambio de rumbo en los próximos 60 m
velocidad_objetivo = lerp(40% de vmax, 10% de vmax, curva_por_delante / 45°)

IF velocidad < velocidad_objetivo:
    acelerar
ELSE IF velocidad > velocidad_objetivo + margen:
    frenar
steering = apuntar a un punto de la trazada, 12 a 36 m por delante
En Reinforcement Learning intentamos que el comportamiento surja del proceso de aprendizaje. Nosotros definimos:
- qué puede observar el agente;
- qué acciones puede realizar;
- qué consecuencias tiene cada acción;
- qué recompensas recibe;
- qué algoritmo utilizará para aprender.
Pero no especificamos manualmente las decisiones de conducción.
Eso es precisamente lo interesante, y también lo difícil. El controlador de reglas de arriba es el que hoy maneja los autos del demo. Los canales de directiva que el agente RL tenía en sus observaciones ahora modulan directamente esas reglas: más agresividad significa una velocidad objetivo más alta y frenar más tarde. Para demostrar la relación entre piloto y estratega, un piloto escrito a mano cuyo comportamiento cambia con la directiva cumplía el requisito. Llegar al mismo punto con RL habría requerido más iteraciones de las que el proyecto podía pagar. En el circuito fijo, donde la pista ya no es un obstáculo, es probable que PPO sí aprenda a dar vueltas, pero ese experimento quedó pendiente.
18. Del comportamiento individual a una policy
Después de suficientes interacciones, la red neuronal intenta aproximar una función:
Es decir:
“Dada esta observación, ¿qué acción debería producir?”
La red no almacena una lista explícita de reglas. En lugar de:
if curve then brake
if straight then accelerate
if left then steer left
aprende una función continua y parametrizada:
                    OBSERVATION (42)
                         │
                         ▼
                ┌─────────────────┐
                │                 │
                │  MLP 2 × 256    │
                │                 │
                └────────┬────────┘
                         │
             ┌───────────┼───────────┐
             ▼           ▼           ▼
         steering     throttle      brake
El reto está en conseguir que esa función mejore de forma estable.
Y aquí es donde entra nuestro siguiente algoritmo.
19. El siguiente paso: PPO
Hasta este punto hemos construido el mapa conceptual:
Agent
  │
  ├── observa
  │
  ├── elige una acción
  │
  ├── recibe reward
  │
  ├── acumula experiencia
  │
  ├── estima qué estados/acciones son buenos
  │
  └── mejora su policy
Pero todavía no hemos explicado cómo actualizamos matemáticamente la policy.
Una de las respuestas más conocidas es Proximal Policy Optimization (PPO), el algoritmo que usó Agentic Racing en todas sus corridas.
PPO introduce una idea especialmente interesante:
Queremos mejorar la policy, pero no queremos cambiarla demasiado de una actualización a la siguiente.
¿Por qué? Porque una actualización demasiado agresiva podría destruir comportamientos que ya funcionaban.
La intuición es:
Policy actual
     │
     │ pequeña mejora
     ▼
Policy nueva
     │
     │ pequeña mejora
     ▼
Policy nueva
     │
     ▼
...
en lugar de:
Policy actual
     │
     │ gran salto
     ▼
Policy completamente diferente
     │
     ▼
comportamiento inestable
PPO compara la probabilidad que la policy nueva y la vieja le asignan a cada acción, la pondera por
el advantage y deja de premiar los cambios que se alejan demasiado. El epsilon: 0.2 de nuestra
configuración define ese límite: una vez que la razón entre la probabilidad nueva y la vieja de una
acción se aleja más de un 20% de 1, alejarse más ya no mejora el objetivo.
El detalle matemático de este mecanismo será el tema del próximo artículo.
20. Pero Agentic Racing nos enseñó algo todavía más importante
Cuando construimos un sistema de RL real, el algoritmo es solo una pieza. Cambiar cualquiera de las otras (lo que el agente ve, lo que puede hacer, lo que se le premia, la física que experimenta) puede cambiar por completo el comportamiento aprendido.
Por eso, cuando un agente no aprende, la pregunta no debería ser solamente:
“¿Qué parámetro de PPO tengo que cambiar?”
También deberíamos preguntar:
“¿Qué está viendo el agente?”
“¿Qué puede hacer?”
“¿Qué reward está recibiendo?”
“¿Qué dinámica física está experimentando?”
“¿El entorno está proporcionando una señal de aprendizaje coherente?”
En Agentic Racing, las cinco preguntas tuvieron respuestas incómodas en algún momento: no veía las curvas venir, la recompensa tenía una salida fácil, la física convertía cada giro en un frenazo, y la pista misma tenía tramos imposibles. Ninguno de esos problemas se arreglaba tocando los hiperparámetros de PPO. Todas las corridas usaron PPO; lo que cambiaba entre una y otra era la recompensa, la percepción del agente o la física.
La lección que más me quedó: antes de gastar cómputo en un método sofisticado, valida que el entorno se pueda resolver con un método simple. Si un controlador escrito a mano no puede dar una vuelta, es poco probable que una recompensa le enseñe a una red neuronal a hacerlo.
21. El mapa mental completo
Podemos resumir todo lo visto hasta ahora de esta manera:
                       AGENT
                         │ observa
                         ▼
                    OBSERVATION
                         │
                         ▼
                      POLICY
                         │ elige
                         ▼
                      ACTION
                         │
                         ▼
                    ENVIRONMENT
                         │
             ┌───────────┴───────────┐
             ▼                       ▼
        NEW STATE                 REWARD
             └───────────┬───────────┘
                         ▼
                    EXPERIENCE
                         │
                         ▼
                 LEARNING ALGORITHM
                         │
                         ▼
                  UPDATED POLICY ──────► ...
Los conceptos matemáticos que iremos construyendo forman una cadena:
No necesitamos memorizar todas estas fórmulas todavía. Lo importante es entender qué pregunta responde cada una:
| Concepto | Pregunta |
|---|---|
| Observation | ¿Qué puede ver el agente? |
| Action | ¿Qué puede hacer? |
| Reward | ¿Qué tan buena fue la consecuencia inmediata? |
| Return | ¿Cuánta recompensa acumulada obtengo desde aquí? |
| Value | ¿Qué tan prometedora es esta situación? |
| Q-value | ¿Qué tan buena es esta acción en esta situación? |
| Advantage | ¿Esta acción es mejor o peor de lo esperado? |
| Policy | ¿Qué acción debería elegir? |
Con este mapa podemos empezar a estudiar algoritmos como PPO sin tratarlos como una colección de fórmulas desconectadas.
22. Una última idea: el agente aprende de experiencia, no de explicaciones
Quizá esta sea la idea más importante para llevarnos de este artículo.
Nosotros podemos mirar una curva y decir:
“Aquí hay que frenar.”
El agente no recibe esa explicación. Recibe datos, actúa, observa las consecuencias, obtiene reward y repite.
Millones de pequeñas interacciones pueden transformar una policy inicialmente inútil en una que produzca un comportamiento complejo.
Eso es lo fascinante de Reinforcement Learning:
No programamos directamente el comportamiento final. Diseñamos un proceso mediante el cual el agente puede descubrirlo.
Y Agentic Racing muestra la otra cara de esa frase: si el proceso está mal diseñado, el agente descubre otra cosa. Descubrió que detenerse pagaba más que seguir, que girar era peligroso y que frenar no servía de nada. Cada uno de esos aprendizajes era perfectamente racional dado el mundo y la recompensa que le dimos. El agente aprendió lo que le enseñamos, que no era lo que queríamos enseñarle.
En el próximo artículo vamos a abrir la caja de PPO: qué hace exactamente con todas esas experiencias y por qué su forma de actualizar la policy es tan estable.
Para continuar
Siguiente artículo de la serie (parte 2):
¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
En él construimos, paso a paso:
- Policy Gradient
- Actor-Critic
- Value Function
- Advantage
- GAE
- Probability Ratio
- Clipping
- PPO Objective
- El ciclo completo de entrenamiento
- Cómo todo esto aparece en Agentic Racing
Y, sobre todo, respondemos una pregunta:
¿Por qué PPO funciona mejor cuando le impedimos cambiar demasiado rápido de opinión?
El código del agente (RaceAgent.cs), la configuración de entrenamiento (race_ppo.yaml) y la
bitácora completa de las ocho corridas están en
github.com/alulema/agentic-racing.