Blog

Notas sobre desarrollo de software, machine learning e ingeniería.

27 min de lectura

¿Cómo le decimos a un agente qué queremos? Reward engineering explicado desde cero

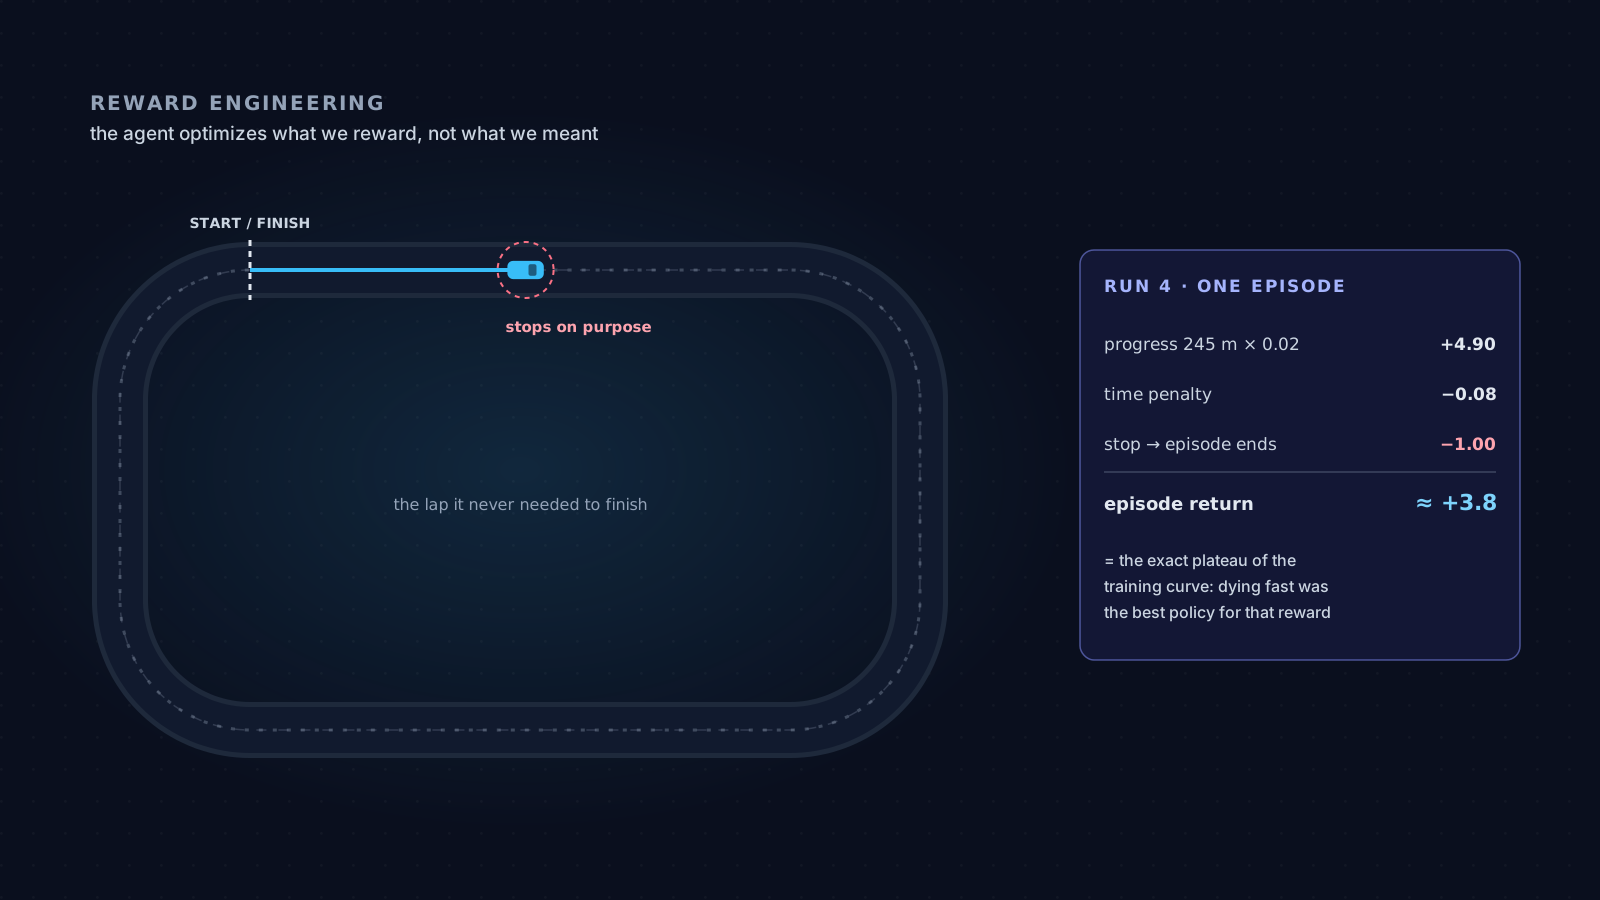
Sexta parte de la serie Reinforcement Learning desde cero con Agentic Racing. Cómo se traduce un objetivo humano a una recompensa, con la función real del piloto RL del proyecto como caso de estudio: escalas, unidades, recompensas densas y escasas, terminaciones que funcionan como premios, reward shaping, y por qué siete variantes de la recompensa no podían arreglar un problema que no era de recompensa.
reinforcement-learningmachine-learningagentsunity
21 min de lectura

¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema

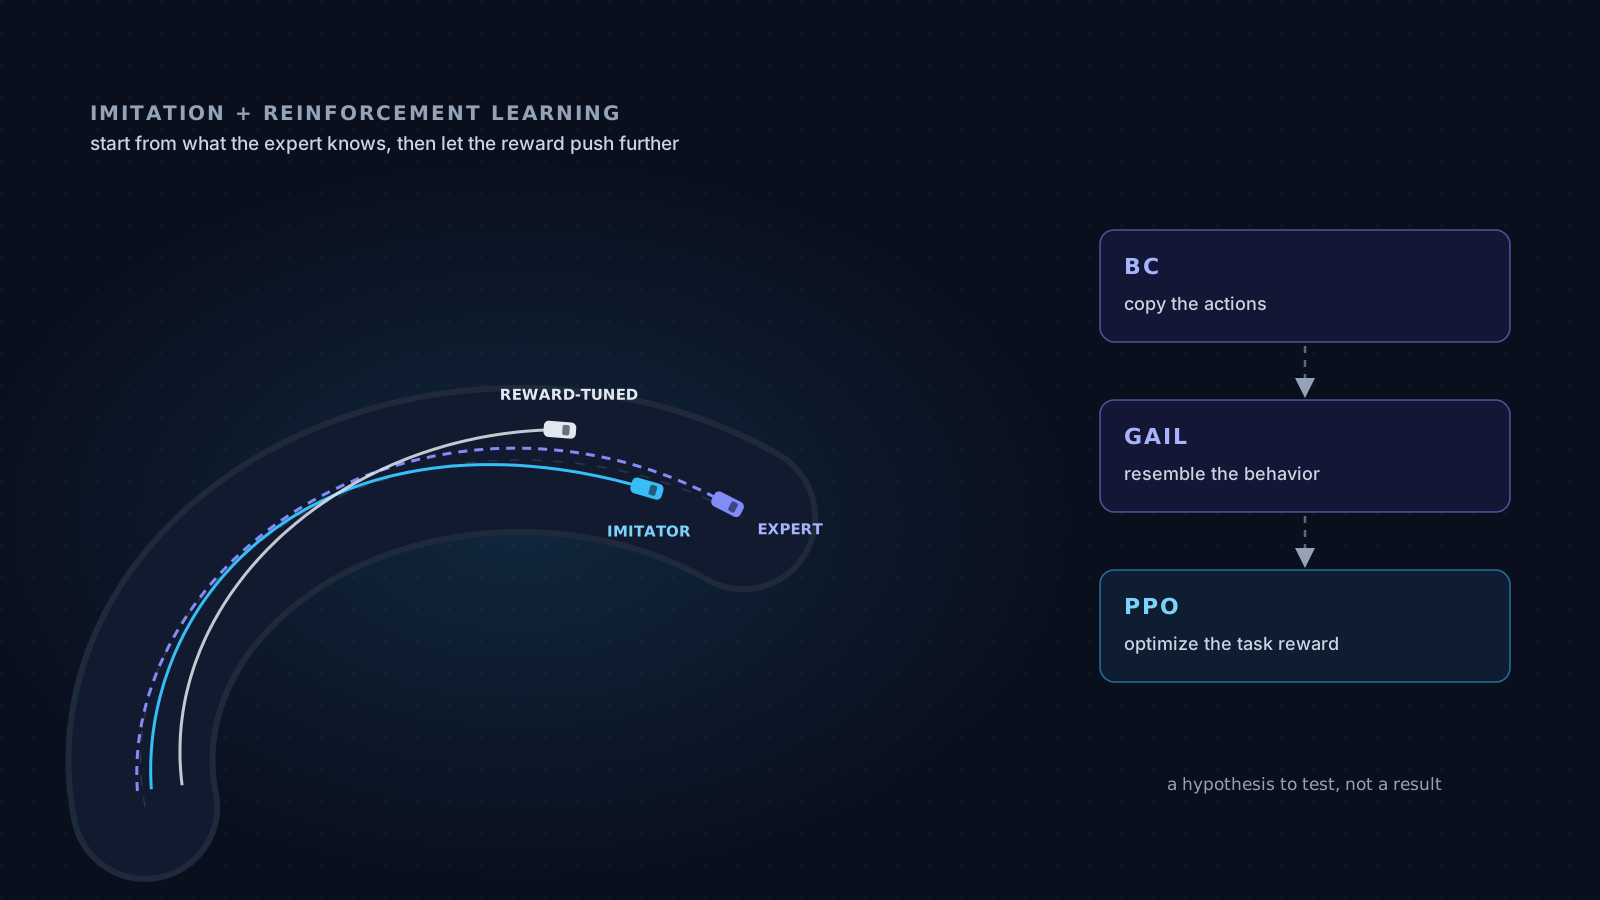
Quinta parte de la serie Reinforcement Learning desde cero con Agentic Racing. Cómo encadenar Behavioral Cloning, GAIL y PPO: qué hace ML-Agents de verdad cuando los combinas, cómo se haría un fine-tuning en dos corridas, por qué en este proyecto la recompensa de la tarea podría borrar justo lo que el demo necesita, y cómo diseñar un experimento que pueda demostrar que la combinación no funciona.

reinforcement-learningmachine-learningagentsunity
28 min de lectura

¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero

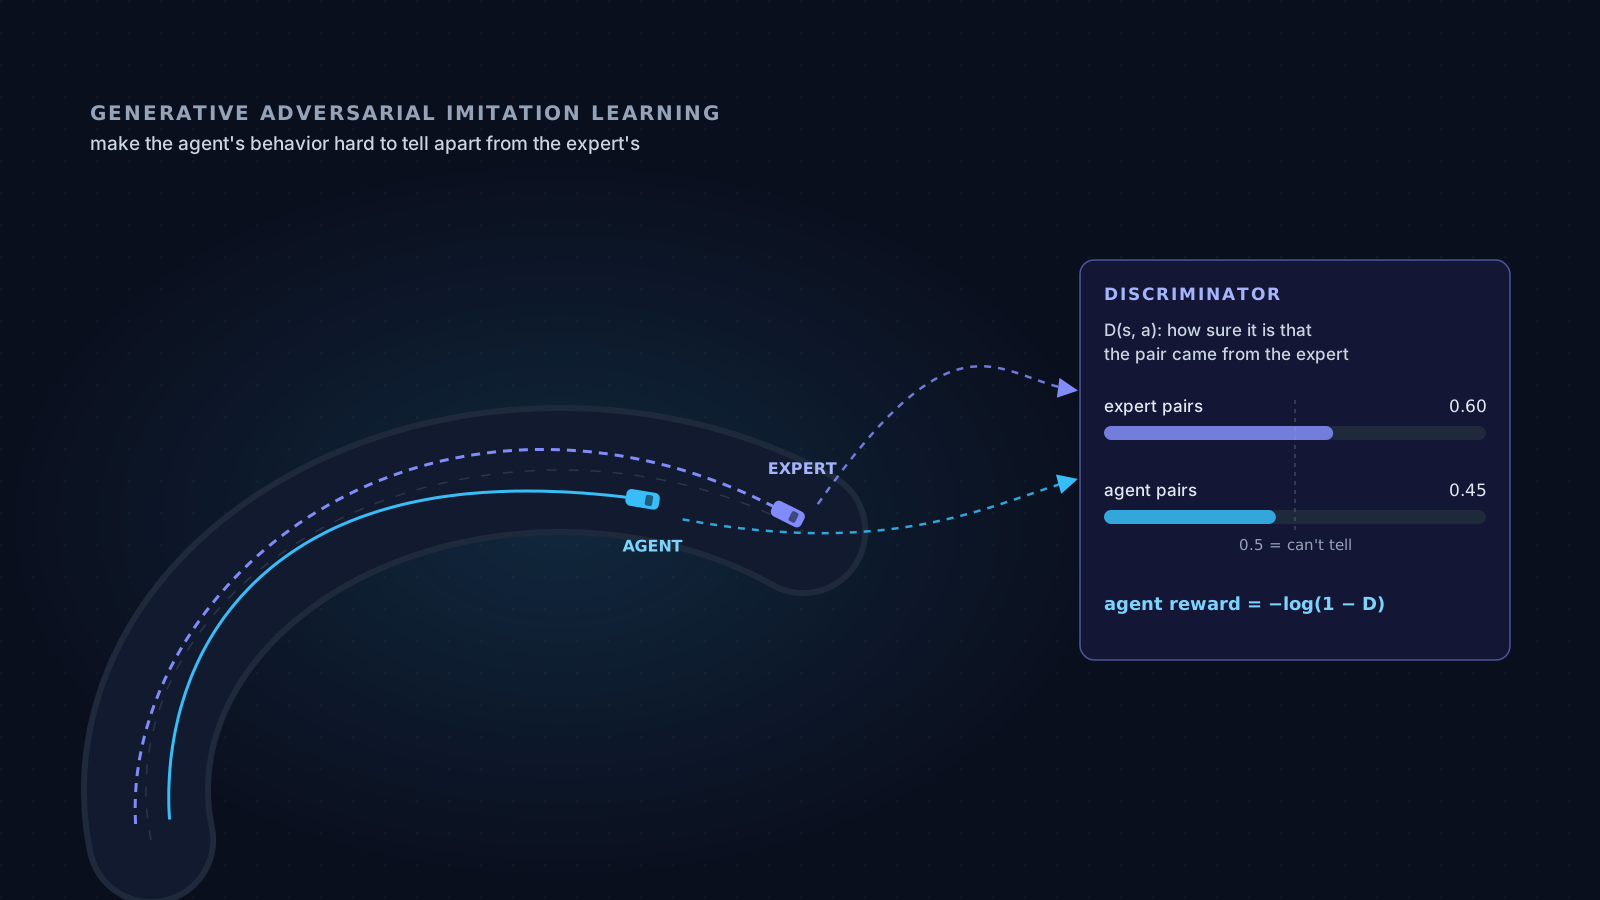
Cuarta parte de la serie Reinforcement Learning desde cero con Agentic Racing. Qué es GAIL, cómo un discriminador convierte la imitación en una recompensa aprendida, qué hace exactamente ML-Agents con ella, y qué habría pasado si el proyecto hubiera llegado a usar la configuración de GAIL que preparó para su piloto.

reinforcement-learningmachine-learningagentsunity
26 min de lectura

¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero

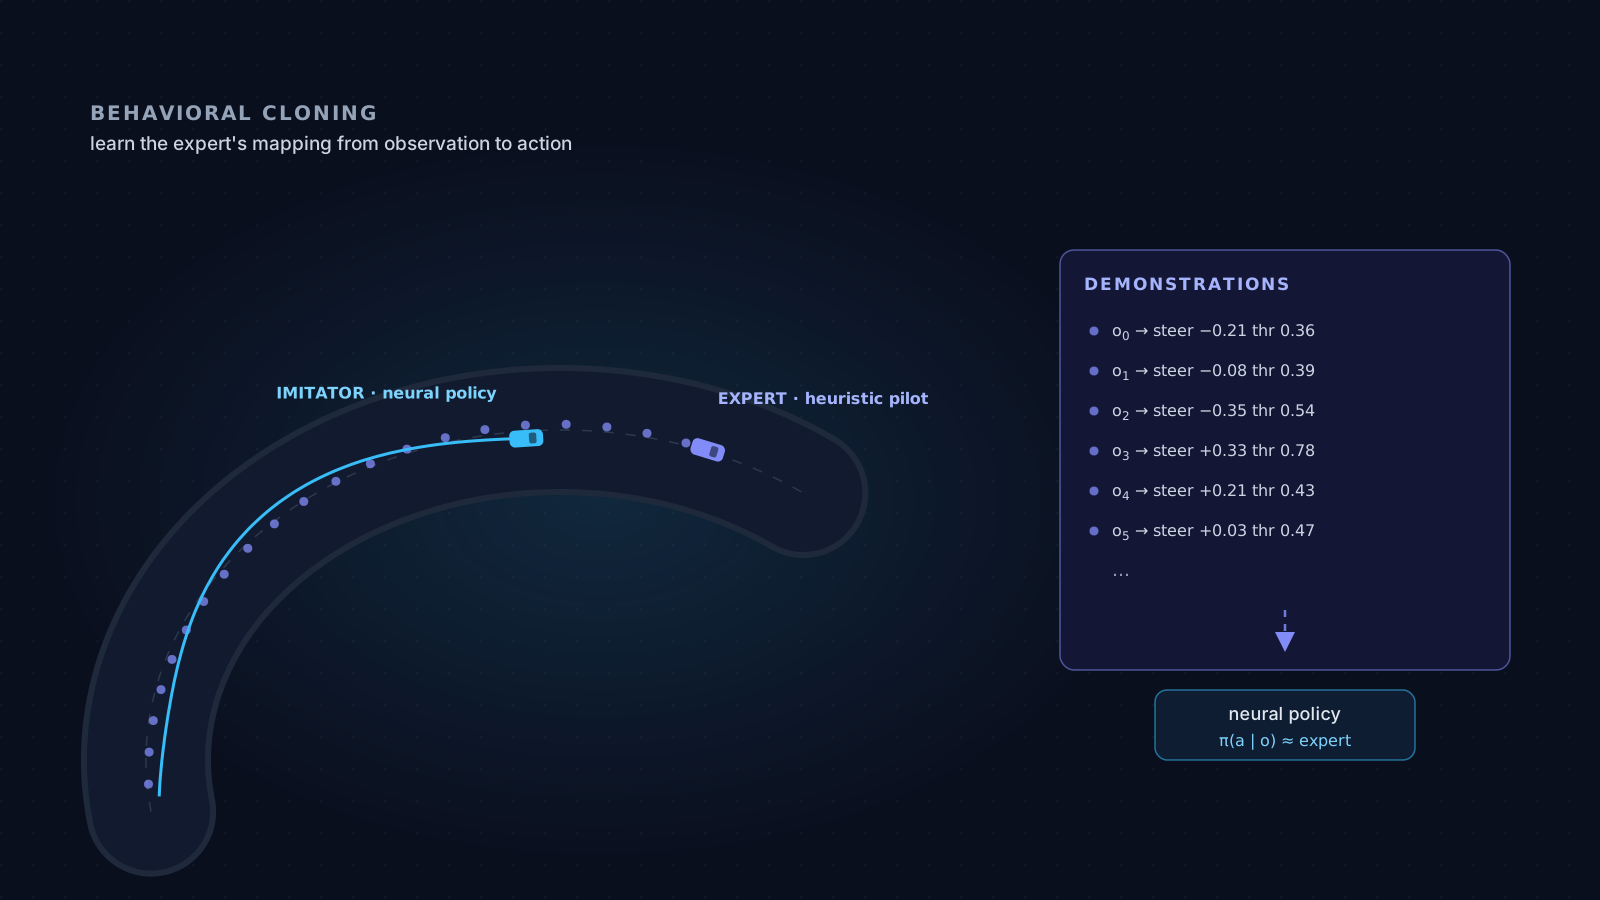
Tercera parte de la serie Reinforcement Learning desde cero con Agentic Racing. Qué es Behavioral Cloning, cómo lo implementa ML-Agents, por qué un pequeño error se convierte en uno grande, y qué pasó cuando el proyecto preparó todo para imitar a su piloto heurístico sin que la bitácora registre una sola demostración grabada.

reinforcement-learningmachine-learningagentsunity
22 min de lectura

¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero

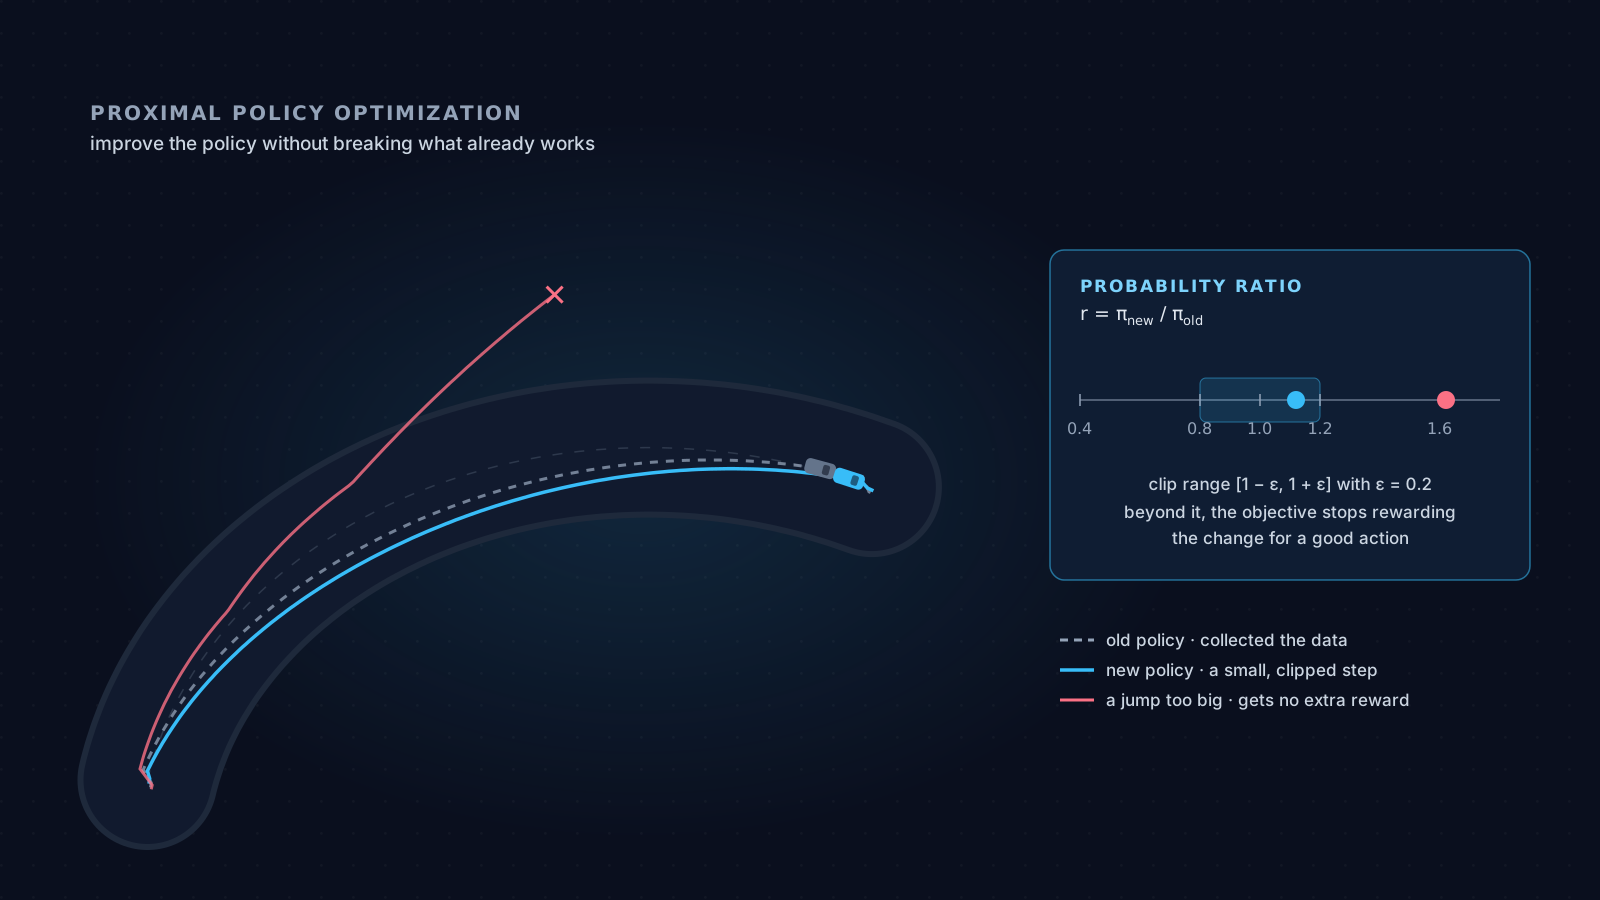
Segunda parte de la serie Reinforcement Learning desde cero con Agentic Racing. Abrimos PPO por dentro: policy gradient, la razón de probabilidades, el clipping, actor-critic y GAE, cada pieza conectada con la configuración real de ML-Agents del proyecto y con lo que pasó cuando PPO optimizó exactamente lo que le pedimos.

reinforcement-learningmachine-learningagentsunity
33 min de lectura

¿Cómo aprende un agente? Enseñando a un automóvil a conducir

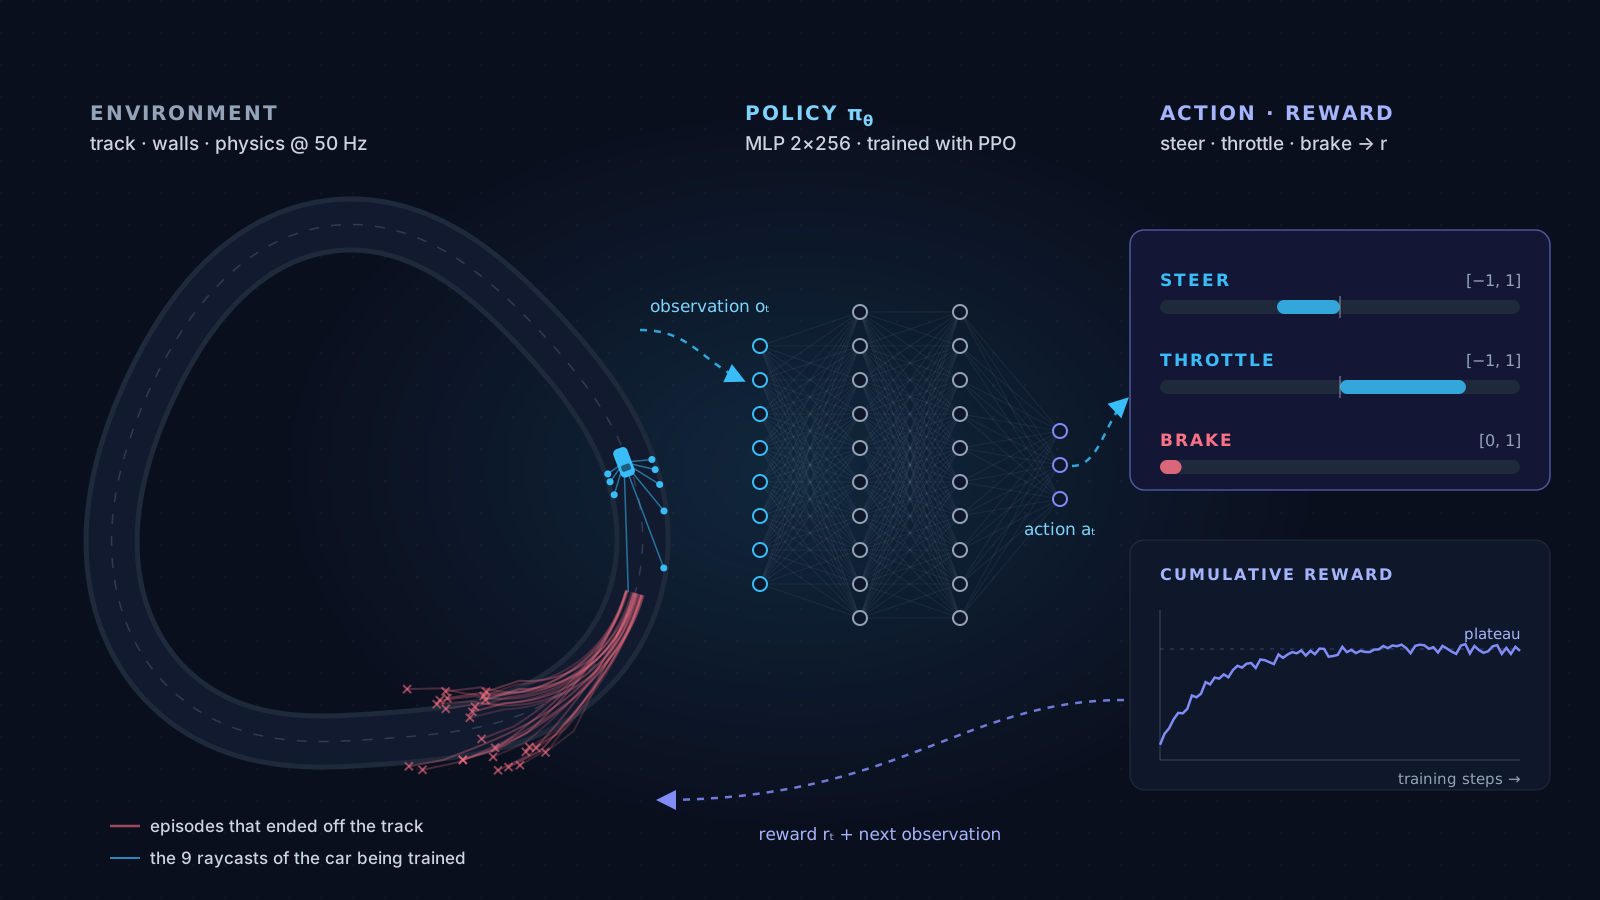
Primer artículo de una serie sobre Reinforcement Learning desde cero, usando Agentic Racing como laboratorio: estado, observación, acción, policy, recompensa, return, value, Q y advantage, explicados con el código real del piloto RL del proyecto, con sus números y con los fracasos que enseñaron más que cualquier ecuación.

reinforcement-learningmachine-learningagentsunity
12 min de lectura

Un planificador de viajes que razona sin generar: Chain-of-Agents con un modelo de 1.5B

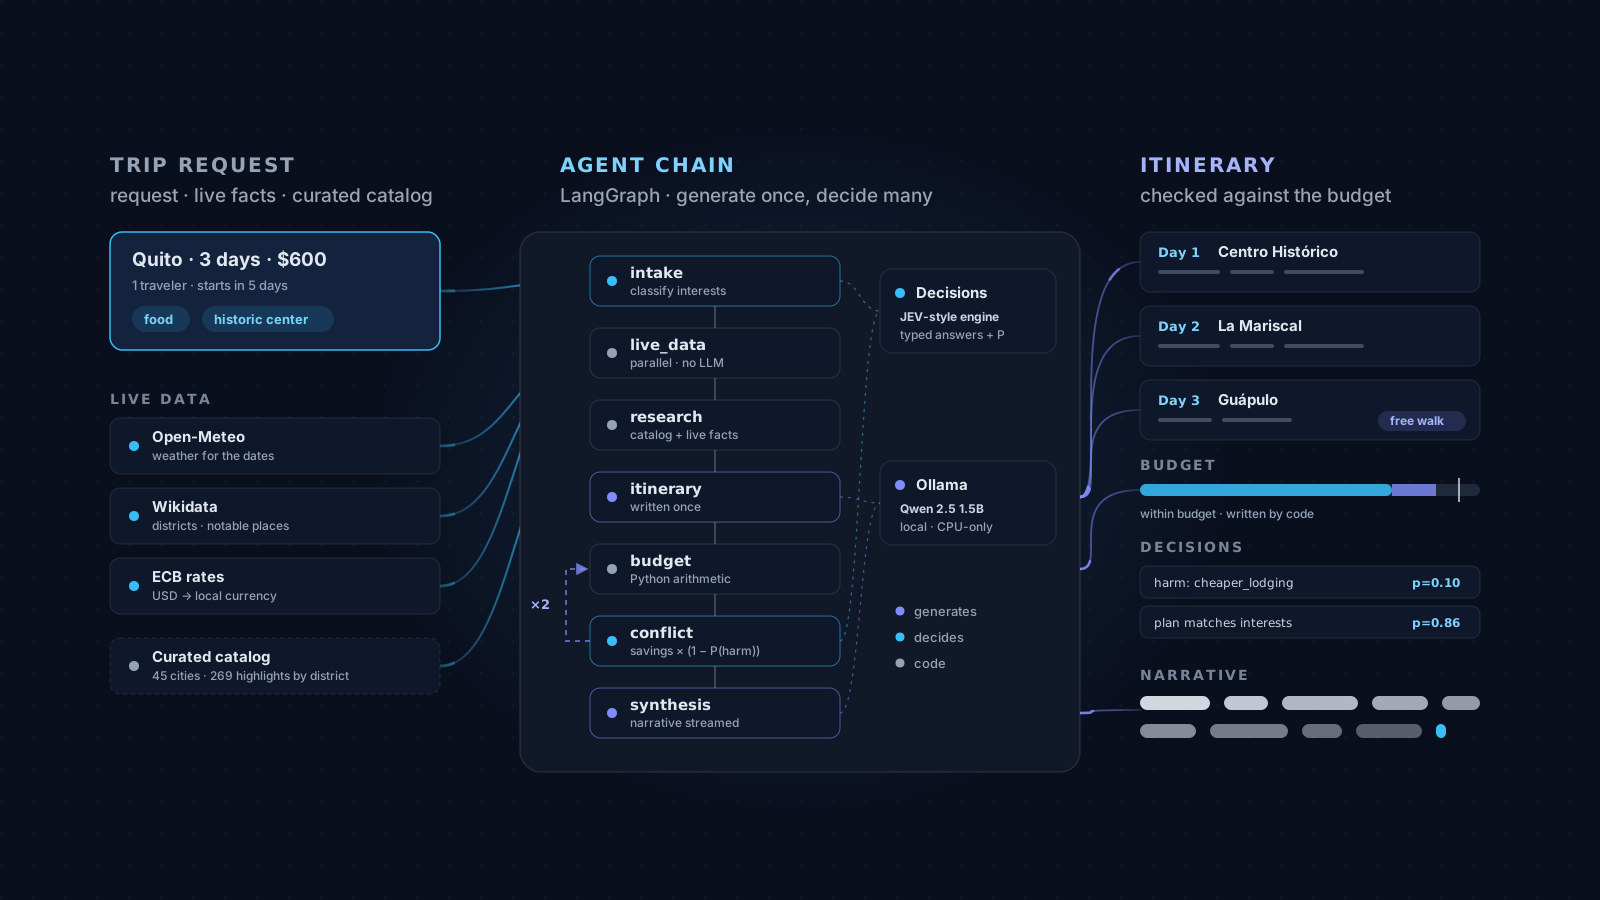
Tomé el patrón Chain-of-Agents del capítulo 7 de 30 Agents Every AI Engineer Must Build y lo llevé a un demo real: un modelo local de 1.5B que escribe solo lo indispensable, un motor de decisiones al estilo JEV que responde con probabilidades en vez de texto, y un ciclo de conflicto de presupuesto que se resuelve sin generar un solo token. Lo que funcionó, lo que el modelo inventó y cómo el código terminó escribiendo la parte honesta.

agentsllmlanggraphollamapythonfastapi
19 min de lectura

Agentic Racing: un piloto que nunca aprendió a manejar, un jefe de equipo que sí aprendió a razonar

Construí un demo de carreras donde un piloto reactivo obedece a un jefe de equipo LLM que razona por evento. Ocho intentos de entrenar el piloto con aprendizaje por refuerzo no funcionaron —la pista estaba rota antes que el algoritmo—, y medir cuánto aporta el estratega terminó siendo el experimento más interesante: siete corridas, sesgos de razonamiento reales y parcialmente corregibles, y una lección sobre confiar en el benchmark completo antes que en el test rápido de escritorio.

reinforcement-learningllmunityagentsollamapython
17 min de lectura

Veinte minutos de infraestructura (y después, nada)

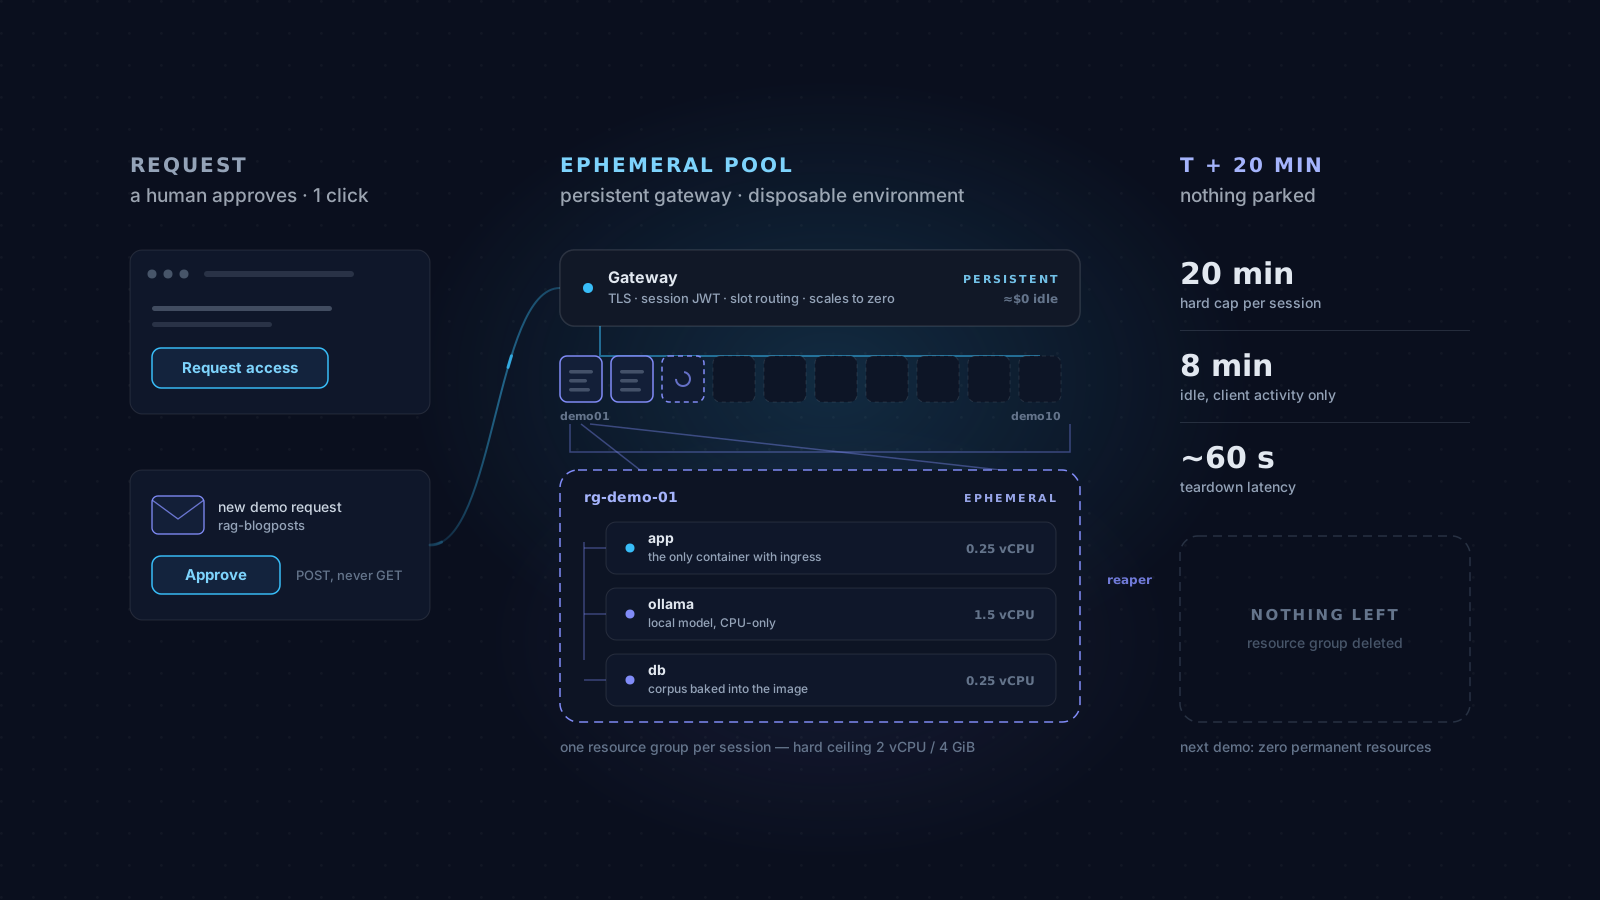
El demo detrás de cada tarjeta de proyecto de mi sitio no existe hasta que lo pides, y deja de existir veinte minutos después. Esta es la maquinaria detrás de ese botón: un entorno efímero por sesión, un pool de subdominios, un gateway, un reaper que hubo que rehacer, y los bugs que solo aparecieron en producción.

infrastructureazurecontainersgithub-actionscloudflaredevopsiac
17 min de lectura

Un chatbot RAG sobre mi propio blog (y el regreso después de tres años)

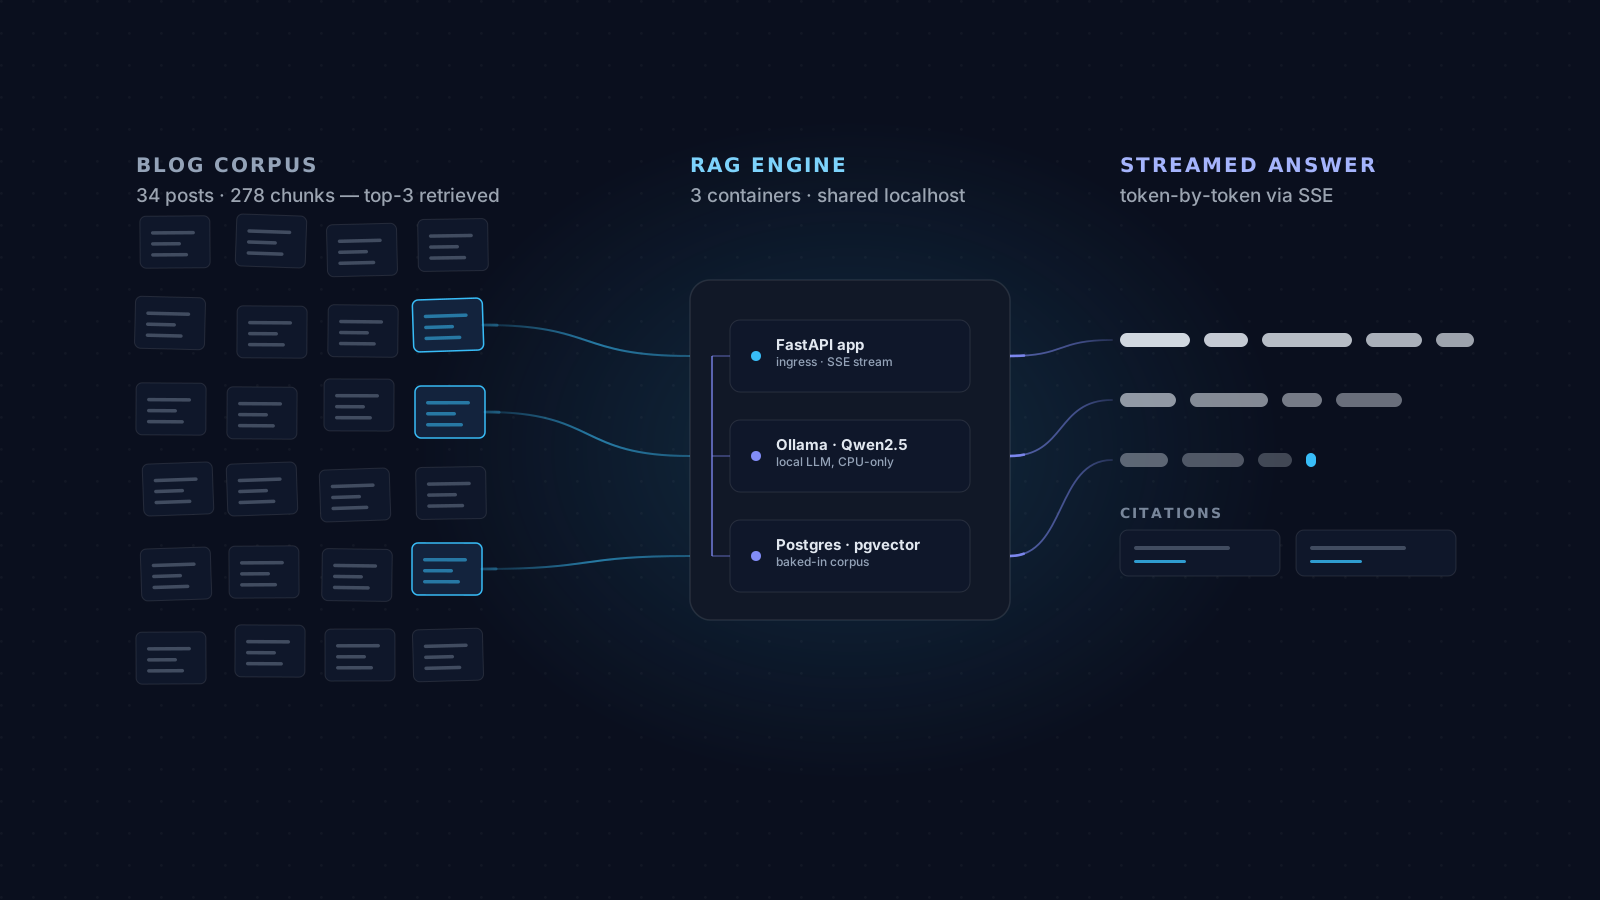
Volví a escribir construyendo algo: un chatbot RAG bilingüe sobre los posts de este blog, 100% local, $0 de API y desplegado como demo efímero. Arquitectura, calibración del umbral, performance en CPU y los bugs que enseñaron más que el happy path.

ragllmpythonfastapipgvectorollamaembeddingsdocker
4 min de lectura

Descomposición Cholesky para Regresión Lineal

beenhereActualización 10.2023Esta entrada ha sido actualizada con la versión de TensorFlow 2.12.1 y PyTorch 2.0.1 Ya han transcurrido varios años desde el inicio del auge del Deep Learning. He sido te…

pythonpytorchtensorflow
25 min de lectura

Temas Avanzados de Asyncio: Más Allá de lo Básico

Introducción ¡Hola, entusiastas de asyncio! Si han estado siguiendo mis publicaciones, recordarán que recientemente nos sumergimos en los conceptos básicos de la biblioteca asyncio de Python en mi ent…

asynchronous-programmingpython
12 min de lectura

Tutorial 'asyncio' para el programador con el tiempo en contra.

Introducción En el mundo en constante evolución de la programación en Python, entender la biblioteca asyncio se está volviendo cada vez más importante. asyncio permite la programación asíncrona, concu…

asynchronous-programming
16 min de lectura

Transformadores: ¿cómo funcionan internamente?

Tabla de contenidos Introducción Incrustación de Entrada (Input Embedding) Codificación Posicional (Positional Encoding PE) El Codificador Mecanismo de Auto-atención Mecanismo de Atención Multicabezal…

machine-learningpythontransformers
14 min de lectura

Funciones de Activación

beenhereActualización 09.2022Esta entrada ha sido actualizada con la versión de TensorFlow v2.10.0 y PyTorch 1.12.1 Tabla de Contenidos ¿Qué es una función de activación?Funciones de ActivaciónSigmoid…

activacionactivation-functionfuncion-de-activacioniamlpytorchtensorflow