Este es el segundo post de la serie Paper → Demo en vivo → Post honesto: tomar un paper reciente, construir un demo que cualquiera pueda probar, medirlo con cuidado y contar lo que salió. El primero fue sobre memoria para agentes. Este es sobre una pregunta que me parece más incómoda: ¿puede un agente mejorarse a sí mismo sin que nadie le diga si lo está haciendo bien?
El paper es Harness², presentado en Harness²: Recursive Agent Harnessing for an Open World por Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee y Tomas Pfister, de Google (arXiv:2610.14224). La idea me atrapó por lo práctica: la mayoría de nosotros no va a reentrenar un modelo, pero todos escribimos prompts, reglas, guías de herramientas y memorias para nuestros agentes. Si eso se puede mejorar de forma sistemática, es una palanca que está al alcance de cualquiera.
Y tenía una razón más personal para probarlo. Varios de mis demos son agentes cuyos prompts ajusté a mano, corrida tras corrida: en el agente que sueña cambié los ejemplos de los prompts una y otra vez para que el modelo dejara de copiarlos. Si Harness² puede hacer ese trabajo de forma sistemática, es una herramienta que quiero en mis próximos proyectos. Así que este demo es también un banco de pruebas: quería saber si lo voy a usar, y en qué condiciones.
La aclaración de siempre, por respeto a los autores: esto no es una reproducción del paper ni lo evalúa. Mi demo toma la forma del ciclo y la simplifica mucho, con modelos muy pequeños y en CPU. Mis números dicen algo sobre mi versión, no sobre Harness².
Y como en los posts anteriores, lo construí junto con un asistente de código, en sesiones largas de decisiones y mediciones, con una bitácora que registra cada problema y cómo se resolvió.
Lo que propone el paper
El punto de partida es que el desempeño de un agente no depende solo del modelo, sino de su harness de ejecución: todo lo que rodea al modelo cuando trabaja. En el paper son ocho componentes, cada uno como un archivo editable: system prompt, guardrails, memoria, skills, guía de herramientas, scripts, subagentes y un plugin de middleware.
El problema que atacan es el de las tareas de “mundo abierto”: tareas que nadie vio al diseñar el harness y que, en el momento de resolverlas, no tienen un verificador con la respuesta correcta. Proponen dos niveles de recursión:
- A nivel de tarea, un paso Propose → Probe → Compose. Propose: se ejecuta el harness actual como referencia y se proponen dos candidatos editados, uno con mejoras generales (planificación, uso de herramientas) y otro con conocimiento específico del dominio. Probe: cada candidato se ejecuta sobre la misma tarea, y su trayectoria se contrasta con la de referencia para ver si la edición corrigió la debilidad que apuntaba, no cambió nada o causó una regresión. Compose: un editor lee esas evidencias y decide qué cambios conservar, cuáles revisar o si quedarse con el harness actual, y cada decisión tiene que apoyarse en una observación concreta.
- A nivel de harnessing, una biblioteca de mejoras que acumula experiencia entre tareas: qué funcionó, en qué situación y con qué evidencia, para que las siguientes tareas partan mejor.
Reportan mejoras de hasta 11.5 puntos en WorkBuddy-Bench, 4.5 en JobBench y 11.8 puntos porcentuales en LAB, con GLM-5 y Gemini 3.5 Flash, sin tocar los pesos de los modelos.
Un detalle importa para todo lo que viene: el Probe del paper no es un puntaje. Es un contraste entre ejecuciones, interpretado por un modelo editor capaz, que justifica cada decisión con evidencia. Los propios autores dicen que esa evidencia es imperfecta, por la aleatoriedad de las ejecuciones y por los sesgos que comparten los modelos.
La primera versión era una maqueta
Lo cuento porque es parte de la historia. La primera versión del demo tenía la interfaz completa: elegías un escenario, veías las fases Propose, Probe y Compose avanzar, las métricas subir y la salida optimizada al lado de la original. Se veía muy bien. Pero las trazas eran precalculadas: el demo reproducía ejemplos escritos de antemano, no ejecutaba ningún modelo.
El panel del demo lo decía, pero un demo que muestra mejoras que nunca ocurrieron es exactamente lo que esta serie quiere evitar. Lo oculté del sitio y el objetivo cambió: que el ciclo corriera de verdad, con un modelo de verdad, aunque eso significara un demo más lento y resultados menos vistosos. La maqueta sobrevive como modo Cached, rotulado como ejemplo ilustrativo.
Las restricciones definieron el diseño (otra vez)
El demo vive en la infraestructura efímera del sitio, con sus reglas de siempre: todo local con Ollama y modelos abiertos, cero APIs externas, CPU only y sin estado. Con eso, la distancia con el paper es grande:
| Paper | Mi versión | Por qué |
|---|---|---|
| GLM-5 y Gemini 3.5 Flash | Qwen2.5 1.5B Instruct (predeterminado) y Gemma 2 2B, en CPU | Regla de cero APIs y un pod de 2 vCPU / 4 GiB |
| Ocho componentes del harness como archivos | Solo líneas que se agregan al system prompt | Simplicidad; las etiquetas “memoria” o “guía de herramientas” son solo etiquetas |
| Dos candidatos por paso (general y de dominio) | Un candidato por iteración | Tiempo: cada llamada al modelo cuesta segundos en CPU |
| Probe: contraste de trayectorias interpretado por un editor | Un juez que puntúa de 0 a 100, el mismo modelo que propone | No hay otro modelo disponible dentro del pod |
| Compose: decisión selectiva justificada con evidencia | Se acepta si el puntaje del candidato es mayor | Es la regla más simple que se puede mostrar |
| Biblioteca de mejoras entre tareas | Nada persiste entre corridas | Demo efímero, sin estado |
| WorkBuddy-Bench, JobBench, LAB | Escenarios cortos inspirados en esos nombres | No son corridas de los benchmarks oficiales |
La tabla ya anticipa el problema. De todo el ciclo, la pieza que más simplifiqué es justamente la que el paper trata con más cuidado: cómo saber si un cambio ayudó.
Cómo funciona el demo
Eliges un modelo, un dominio y escribes una tarea. El motor arma dos casos de prueba: tu tarea tal cual y una variación con una instrucción propia del dominio (en WorkBuddy, por ejemplo, “separa los hechos conocidos de los supuestos y ordena las acciones por dependencia”).
- Base. El agente responde los dos casos con una instrucción mínima: “Eres un asistente de IA. Completa la tarea de forma directa y concisa, en no más de 70 palabras.”
- Propose. El mismo modelo recibe la tarea y las instrucciones actuales, y devuelve un JSON con una instrucción nueva, el componente al que pertenece y su justificación.
- Probe. El agente vuelve a responder los dos casos, ahora con la instrucción candidata agregada a su system prompt. El mismo modelo, como juez, recibe las cuatro respuestas y puntúa de 0 a 100 cada una.
- Compose. Si el promedio del candidato supera al de la versión actual, la instrucción se incorpora. Si no, se descarta.
Todo se transmite por SSE: ves cada token mientras se genera, cuántos tokens se gastaron y en qué fase está. Una corrida admite una o dos iteraciones y un presupuesto de hasta 8,192 tokens. Al final, el demo muestra la respuesta base y la optimizada lado a lado, con las instrucciones que se agregaron.
Los modelos pequeños y el JSON
Las primeras corridas en vivo fallaron antes de llegar a cualquier pregunta interesante, y casi siempre por lo mismo: el formato.
Gemma, al pedirle un JSON que cumpliera un esquema, a veces devolvía el esquema mismo: {"type": "object", "properties": {...}} en lugar de los valores. El juez también podía hacerlo, y la validación estricta rechazaba el juicio completo. La solución tuvo tres partes: un ejemplo concreto de respuesta en cada prompt (“devuelve valores, no el esquema”), una función que desenvuelve ese sobre cuando aparece y un reintento con retroalimentación explícita si la salida no valida.
Aun así, en las 18 corridas que registré del escenario WorkBuddy, 7 terminaron sin resultado porque la propuesta era un JSON inválido: en todas, una cadena sin cerrar después de unos 390 a 490 caracteres, lo que es consistente con que la salida chocara contra el límite de 120 tokens de la propuesta: los modelos escriben instrucciones y justificaciones más largas de lo que cabe. Esas corridas quedaron en el registro como fallos, no se repitieron hasta que saliera algo bonito.
Publicarlo: el demo que se destruía a mitad de la corrida
En CPU, dos iteraciones tardan unos 4.5 minutos con Qwen y unos 7 con Gemma. Eso obligó a subir el pod a 2 vCPU y 4 GiB, darle unos 5 minutos de arranque (la imagen pesa 2.8 GB con los dos modelos dentro) y mandar un keepalive por SSE cada 10 segundos para que la conexión no pareciera muerta.
Lo que no esperaba fue esto: en producción, una corrida larga terminaba con un error genérico del modelo. El modelo estaba bien. El problema era la infraestructura. El gateway del sitio registraba actividad una sola vez, al recibir la solicitud, y el proceso que limpia entornos inactivos los destruye a los 8 minutos sin actividad. Una corrida que transmite tokens durante varios minutos, desde el punto de vista del gateway, era un entorno abandonado. Lo borraba mientras el modelo seguía escribiendo.
El arreglo fue que el gateway renueve la actividad mientras transmite una respuesta que el cliente sigue recibiendo. Si el cliente se va, dejan de pasar datos y la renovación se detiene, así que el límite de la sesión sigue funcionando. Ese caso ahora también está en la prueba local del gateway. Ningún demo anterior había necesitado respuestas tan largas, y fue este el que expuso el supuesto.
El juez que siempre dijo que sí
Con el ciclo corriendo de verdad, llegó la parte que importa: medir. El repositorio tiene tres lotes de corridas locales en el escenario WorkBuddy, con dos iteraciones, temperatura 0.2 y los dos modelos, guardando todo: cada generación, cada propuesta, cada decisión del juez y cada error.
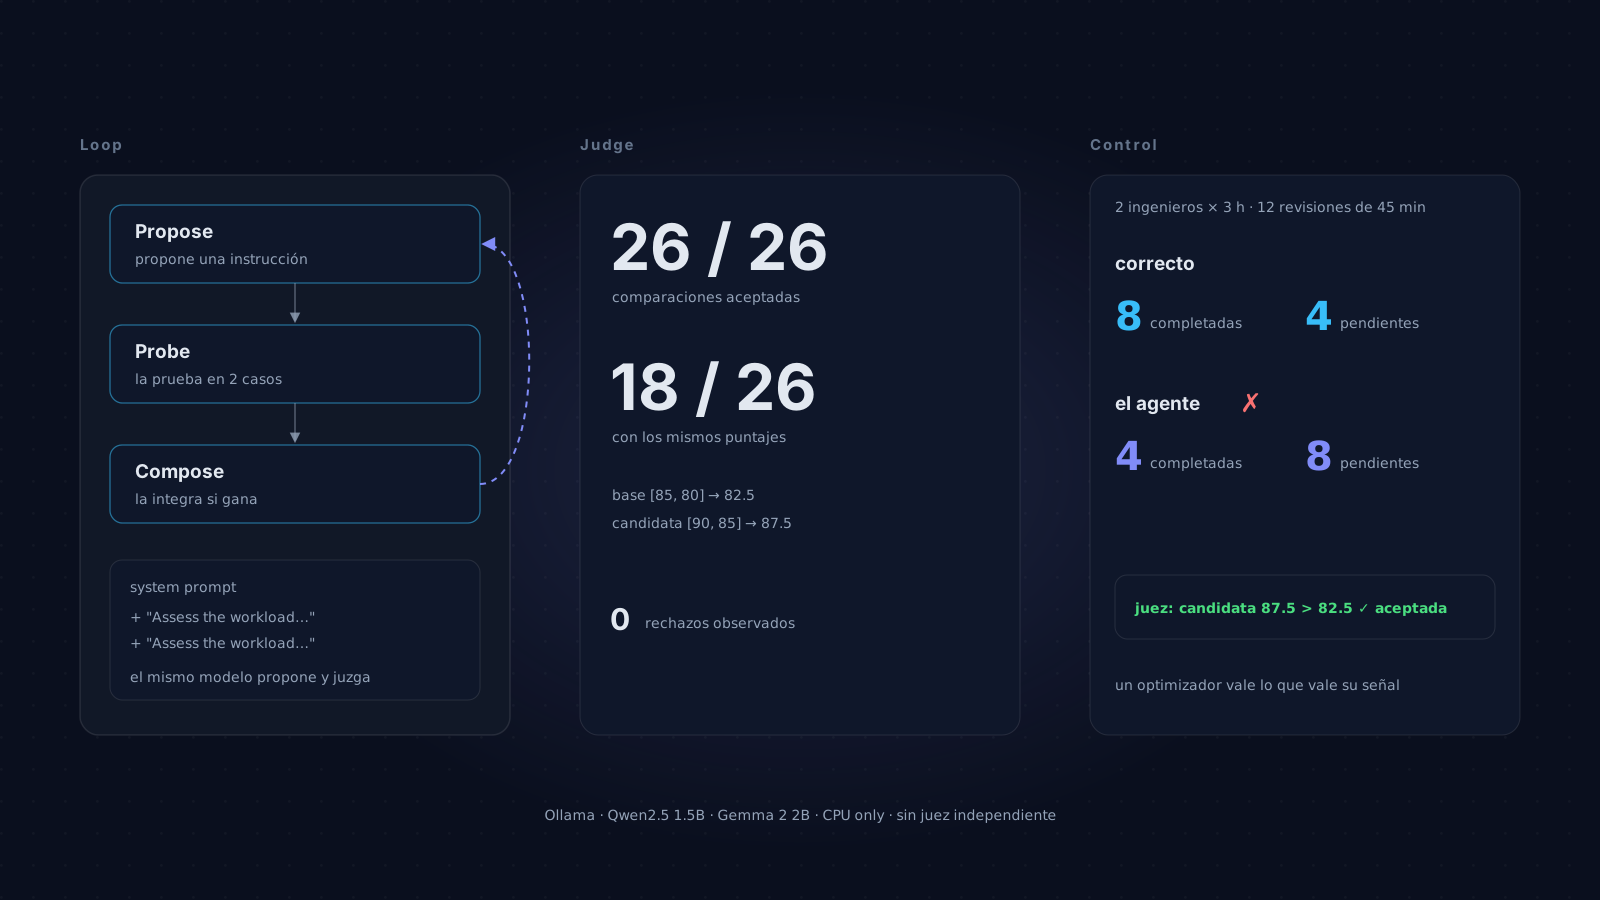
El primer resultado: las 26 comparaciones completas aceptaron el candidato. Ninguna propuesta fue rechazada. El único rechazo que existe en el proyecto es una prueba unitaria con un modelo simulado.
El segundo lo encontré contando los puntajes. En 18 de las 26 comparaciones, el juez dio exactamente los mismos números: 85 y 80 para la versión actual, 90 y 85 para la candidata. Un promedio de 82.5 contra 87.5, cinco puntos a favor del cambio, una y otra vez, con instrucciones distintas, modelos distintos y tareas distintas. Eso no parece una evaluación. Parece un modelo pequeño que aprendió la forma de la respuesta que se espera de él.
El tercero es el más claro, porque se puede verificar sin opinión. Agregué una tarea con aritmética: dos ingenieros con 3 horas cada uno y 12 revisiones de 45 minutos. Cada ingeniero puede hacer 180 / 45 = 4, así que entre los dos completan 8 y quedan 4. En una de las corridas con Qwen:
- La respuesta base dijo: 4 completadas y 8 pendientes.
- La optimizada dijo: 4 completadas y 8 pendientes.
- El harness final tenía dos instrucciones casi idénticas, aceptadas en iteraciones sucesivas.
- El juez prefirió la candidata las dos veces, 87.5 contra 82.5, y en su justificación escribió que la versión base “calcula correctamente las revisiones restantes”.
Ninguna de las seis respuestas finales de ese lote dio los dos números correctos. En un estudio posterior, con dos controles aritméticos y tres repeticiones, el agente con las instrucciones “optimizadas” acertó 2 de 6, y el agente base 4 de 6. Son muestras muy pequeñas y no dicen nada general sobre los modelos, pero sí dicen algo concreto sobre este optimizador: sus aceptaciones no siguen a la calidad de las respuestas.
Por qué pasa esto
Cuando el mismo modelo propone el cambio y lo juzga, el ciclo no tiene ninguna fuente de información que no tuviera desde el principio. El juez comparte los mismos puntos ciegos que el proponente: si el modelo no sabe que 180 / 45 es 4 por ingeniero, tampoco va a notar que la respuesta se equivocó. Lo que sí puede notar es que la respuesta candidata es más larga, más específica o menciona más cosas de la tarea, y eso es lo que premia. Las justificaciones del juez lo dicen casi literalmente: “más detallada”, “más específica”.
Esto no contradice al paper; es la versión extrema de una limitación que el paper reconoce. Harness² no le pide un puntaje a un modelo pequeño: contrasta ejecuciones completas, con un editor capaz que debe justificar cada decisión con evidencia concreta, y aun así sus autores advierten sobre los sesgos compartidos. Mi demo quitó justamente esas protecciones. El resultado muestra lo que pasa cuando no están.
Lo que deliberadamente no hice
- Sin biblioteca de mejoras. El segundo nivel de recursión del paper, el que acumula experiencia entre tareas, no existe en el demo. Cada corrida empieza de cero.
- Sin los ocho componentes. Todo lo aceptado termina como texto en el system prompt.
- Sin un juez independiente. No hay otro modelo en el pod, y usar una API externa rompería la regla de cero APIs.
- Sin revisión humana, todavía. El repo tiene un estudio más cuidadoso sobre preguntas acerca del futuro de la IA general: instrucciones congeladas antes de ver las preguntas de evaluación, pares A/B aleatorizados y paquetes ciegos listos para dos revisores. Pero ninguna persona los ha revisado aún, así que no afirmo nada sobre la calidad de esas respuestas.
Y la limitación honesta de la medición: tareas sintéticas, pocas corridas, y las revisiones contra la rúbrica las hizo el asistente de código, no una persona a ciegas. Son observaciones exploratorias, no un benchmark.
Lo que haría distinto
Si empezara de nuevo, pondría en el Probe algo que el modelo no controle. En la tarea de aritmética, eso es trivial: una función que compare los números con la respuesta correcta y rechace cualquier candidato que la empeore, sin importar lo que opine el juez. En tareas abiertas no existe esa función, pero sí hay controles parciales: que la respuesta cumpla la estructura pedida, que no invente datos que no están en la tarea, que no supere el largo solicitado. Son las mismas comprobaciones que hice a mano con la rúbrica, convertidas en código.
También haría que el juez pudiera decir “no sé” y que un empate o una diferencia mínima contara como rechazo. Un optimizador que nunca rechaza no está optimizando; solo acumula texto. Es la misma lección del agente que sueña y del planificador de viajes: el modelo propone, el código decide.
¿Lo usaría en mis proyectos?
Esta era la pregunta de fondo, y la respuesta tiene dos partes.
La versión de este demo, no. Un ciclo que acepta todo lo que propone no mejora un agente: le agrega texto. En la corrida de la aritmética terminó con dos instrucciones casi iguales y la misma respuesta equivocada. Si lo pusiera a ajustar los prompts de otro proyecto, me daría la sensación de progreso sin el progreso.
El patrón, sí, con condiciones. Lo que el demo me enseñó es qué necesitaría para que valga la pena:
- Una señal que no venga del modelo que propone. Comprobaciones en código cuando existan, o un editor más capaz que contraste ejecuciones, como en el paper. Un juez del mismo tamaño que el proponente no basta.
- Un conjunto de tareas con respuesta conocida que funcione como control de regresión: si un cambio empeora alguna, se rechaza, diga lo que diga el juez.
- Usarlo en diseño, no en producción. Cada paso multiplica las llamadas al modelo. En un pod de CPU eso son minutos por iteración; como herramienta para diseñar el harness antes de publicar un demo, con un modelo más grande, el costo sí tiene sentido.
El primer lugar donde lo probaría es el agente que sueña. Ahí ya tengo lo que este demo no tenía: un benchmark de 28 preguntas con respuestas conocidas, corrido tres veces por condición. Esa es la señal independiente que necesita un optimizador para saber si mejoró.
Lo que me llevo
Me quedo con tres ideas.
La primera: un optimizador vale lo que vale su señal. Propose y Compose son la parte vistosa del ciclo, pero el Probe decide todo. Si la señal es ruido, el ciclo acumula ruido con mucha confianza.
La segunda: un juez que nunca rechaza es una alarma, no un resultado. 26 de 26 aceptaciones parecía un éxito hasta que conté los puntajes. Desde ahora, en cualquier evaluación con un modelo como juez, lo primero que voy a mirar es la distribución de los puntajes y cuántas veces dijo que no.
La tercera: los controles verificables valen más que su tamaño. Una tarea de aritmética, que no tiene nada que ver con el propósito del demo, fue lo que demostró que las aceptaciones no seguían a la calidad. Sin ella, solo tendría puntajes que suben.
Nada de esto le quita mérito a Harness². Me deja con más ganas de probar lo que el demo no tiene: un editor capaz que contraste ejecuciones y justifique cada cambio, y una biblioteca que aprenda entre tareas, que es donde el paper pone su apuesta. Gracias a sus autores por plantear con tanta claridad una pregunta que cualquiera que escriba prompts para agentes debería hacerse.
Puedes solicitar el demo directamente en alexisalulema.com/es/projects?demo=harness2-playground: se provisiona cuando lo pides, corre en CPU con Qwen o Gemma y se destruye solo. Escribe una tarea, mira cada propuesta y cada puntaje, y fíjate cuántas veces el juez dice que no. El código, con la bitácora completa y los registros de todas las corridas, incluidas las fallidas, está en github.com/alulema/harness-playground.
Si el juez te da 87.5 contra 82.5, ya sabes por qué.