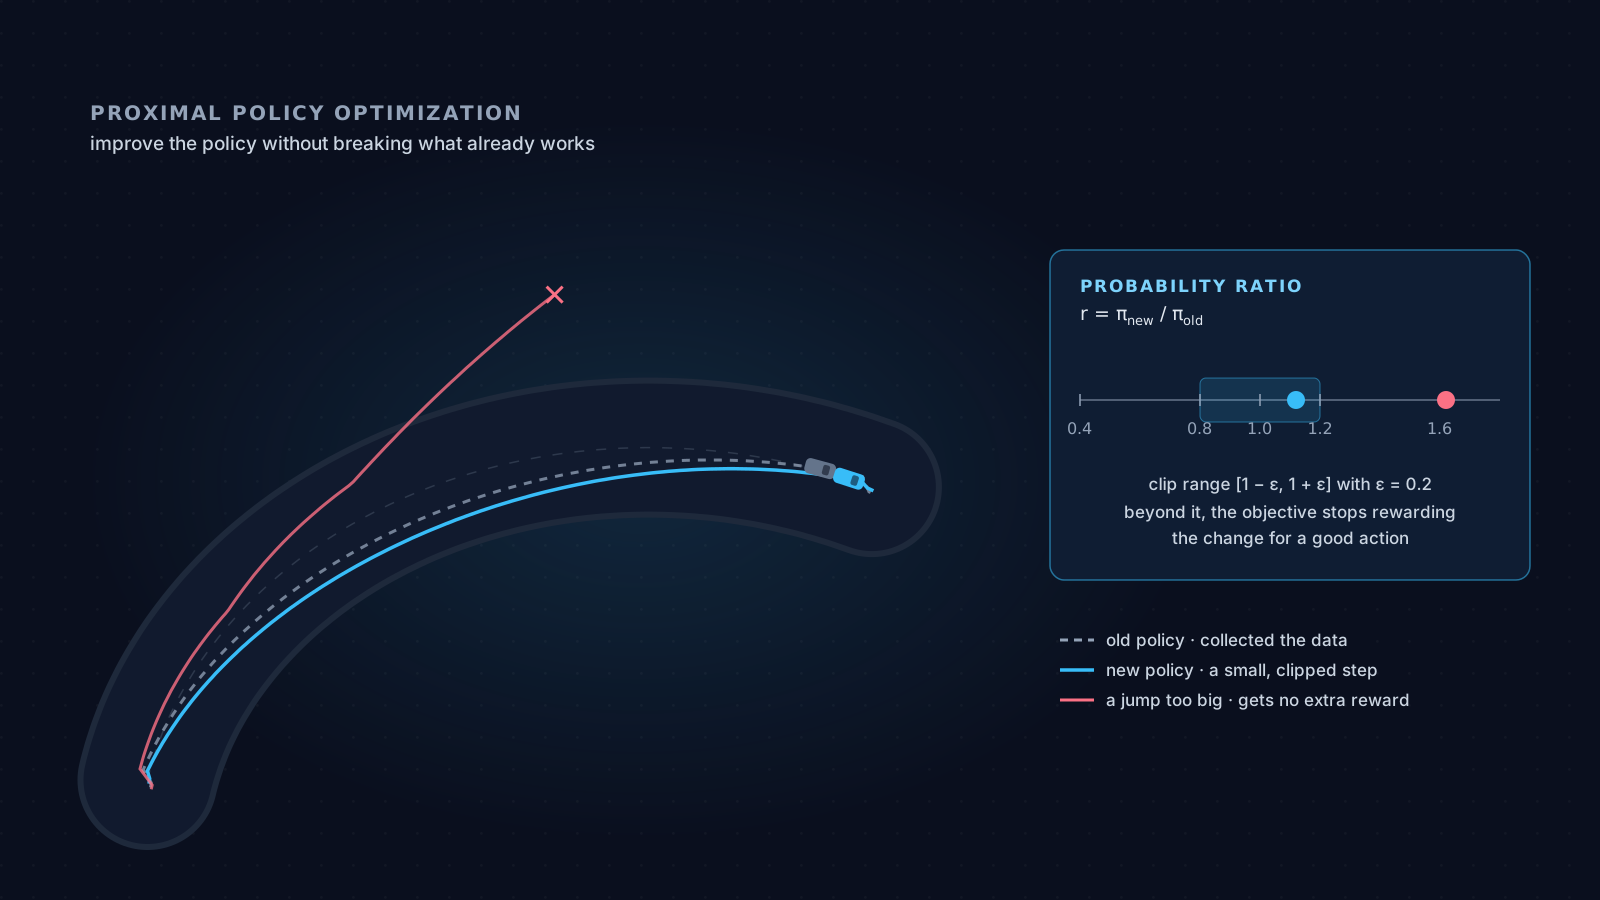
Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero (este artículo)
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema
Dónde nos quedamos
La primera parte terminó con un mapa conceptual: el agente observa, elige una acción, recibe una recompensa, acumula experiencia y estima qué estados y acciones son buenos. Lo que faltaba era la última flecha: cómo se usa esa experiencia para mejorar la policy.
Y terminó con una pregunta:
¿Por qué PPO funciona mejor cuando le impedimos cambiar demasiado rápido de opinión?
Este artículo responde esa pregunta. Imagina un piloto virtual que ya aprendió algo útil (mantenerse en pista en las rectas, tomar alguna curva suave) pero todavía comete errores. Queremos que mejore sin que una actualización del entrenamiento destruya lo que ya funciona.
Proximal Policy Optimization (PPO) es un algoritmo que actualiza la policy (la estrategia que decide qué acción tomar) controlando cuánto cambia en cada actualización. Proximal significa cercano: la policy nueva no debería alejarse demasiado de la que generó las experiencias con las que está aprendiendo.
Como en la parte 1, cada idea va acompañada de lo que realmente hace el entrenador de Unity ML-Agents (versión 1.1.0 del paquete de Python) y de cómo estaba configurado en Agentic Racing. Y, como en la parte 1, con una advertencia honesta: en este proyecto el piloto RL nunca aprendió a dar vueltas completas de forma consistente. Eso no le quita valor al ejemplo. Ver qué optimizó PPO cuando no aprendió lo que queríamos es una de las mejores formas de entender qué optimiza.
1. Un repaso de treinta segundos
De la parte 1 necesitamos tres piezas.
La policy es una función parametrizada que asigna probabilidades a las acciones:
donde es el estado (en la práctica, la observación del agente), es una acción y
son los pesos de la red neuronal. En Agentic Racing, son 42 números (raycasts, velocidad,
relación con la pista, curvatura por delante y la directiva del estratega) y son tres acciones
continuas: steer, throttle y brake. Como las acciones son continuas, la red produce el centro
de una distribución normal para cada una, y la acción se muestrea de esa distribución.
El advantage compara una acción con lo que normalmente se espera en ese estado:
- : la acción fue mejor de lo esperado.
- : fue peor de lo esperado.
- : estuvo cerca de lo esperado.
Y el crítico es la parte del sistema que estima , el retorno esperado desde un estado.
Con eso alcanza.
2. Policy gradient: empujar las probabilidades en la dirección correcta
La idea más directa para mejorar una policy es esta: subir la probabilidad de las acciones que salieron mejor de lo esperado y bajar la de las que salieron peor. Eso es lo que hacen los métodos de policy gradient. Su forma más conocida estima el gradiente del rendimiento así:
No hace falta seguir la derivación para entender la intuición:
- indica en qué dirección mover los pesos para que la acción sea más probable en el estado .
- (el gorro indica que es una estimación) decide el sentido y el tamaño del empujón: si la acción salió mejor de lo esperado, la hacemos más probable; si salió peor, menos.
Esto funciona, pero tiene dos problemas prácticos.
El primero: el tamaño del paso. es una estimación ruidosa. Si damos un paso demasiado grande en la dirección del gradiente, la policy puede cambiar tanto que empieza a hacer cosas que nunca había probado y para las que nuestras estimaciones no dicen nada. Un mal paso puede deshacer en una actualización lo que costó millones de pasos aprender.
El segundo: la experiencia es cara. En Agentic Racing, cada actualización necesita 20 480 decisiones. A 10 decisiones por segundo, son unos 34 minutos de conducción simulada, repartidos entre los 36 autos que entrenan en paralelo. Usar esa experiencia para un solo paso de gradiente y tirarla sería un desperdicio. Queremos reutilizarla varias veces.
Pero en cuanto damos el primer paso de gradiente, la policy ya no es la que recogió esa experiencia. Necesitamos una forma de medir cuánto se alejó. Ahí entra la razón de probabilidades.
3. La razón de probabilidades: ¿cuánto cambió la policy?
PPO compara la policy que estamos optimizando con la que recogió las experiencias:
- : la probabilidad de esa acción no cambió.
- : la policy nueva le asigna a esa acción una probabilidad un 20% mayor.
- : la probabilidad es un 20% menor.
Con acciones continuas, como en nuestro auto, en lugar de probabilidades se comparan densidades de
probabilidad, pero la idea es la misma. En el código de ML-Agents se calcula a partir de logaritmos,
que es numéricamente más estable: r_theta = torch.exp(log_probs - old_log_probs).
Un detalle que conviene no perder de vista: esta razón compara probabilidades de acciones. No significa que el auto haya mejorado un 20% en velocidad, seguridad o tiempo de vuelta.
Con esta razón, el objetivo de policy gradient se puede reescribir como . Al inicio de la actualización y los gradientes de ambas formas coinciden. A medida que la policy cambia, corrige el hecho de que estamos evaluando acciones elegidas por una policy anterior. Solo corrige las acciones, no los estados: las situaciones en las que se encontró el auto siguen siendo las que produjo la policy vieja. Esa es otra razón para no alejarse demasiado. Eso permite reutilizar el mismo lote de experiencia durante varias pasadas.
Pero también abre la puerta al problema del tamaño del paso: si maximizamos sin límite, el optimizador va a querer empujar hacia arriba sin freno en cada acción con advantage positivo. Necesitamos un freno.
4. Clipping: quitarle el incentivo a cambiar demasiado
El objetivo clipped de PPO es este:
Tiene tres partes:
- mide cuánto cambió la probabilidad de una acción.
- estima si esa acción fue mejor o peor de lo esperado.
cliprecorta la razón al intervalo en uno de los dos términos, y elminse queda con el más pesimista de ambos.
En Agentic Racing, empezaba en 0.2, así que el intervalo era:
La forma más clara de entenderlo es ver qué pasa en los cuatro casos posibles:
| Caso | Ejemplo | ¿Qué término gana el min? | Efecto |
|---|---|---|---|
| Acción buena () que ya subió mucho | el recortado: | el objetivo deja de crecer; no hay más incentivo para subirla | |
| Acción buena () que bajó | el sin recortar: | el gradiente sigue empujando para subirla de nuevo | |
| Acción mala () que ya bajó mucho | el recortado: | el objetivo deja de mejorar; no hay más incentivo para bajarla | |
| Acción mala () que subió | el sin recortar: | el gradiente sigue empujando para bajarla |
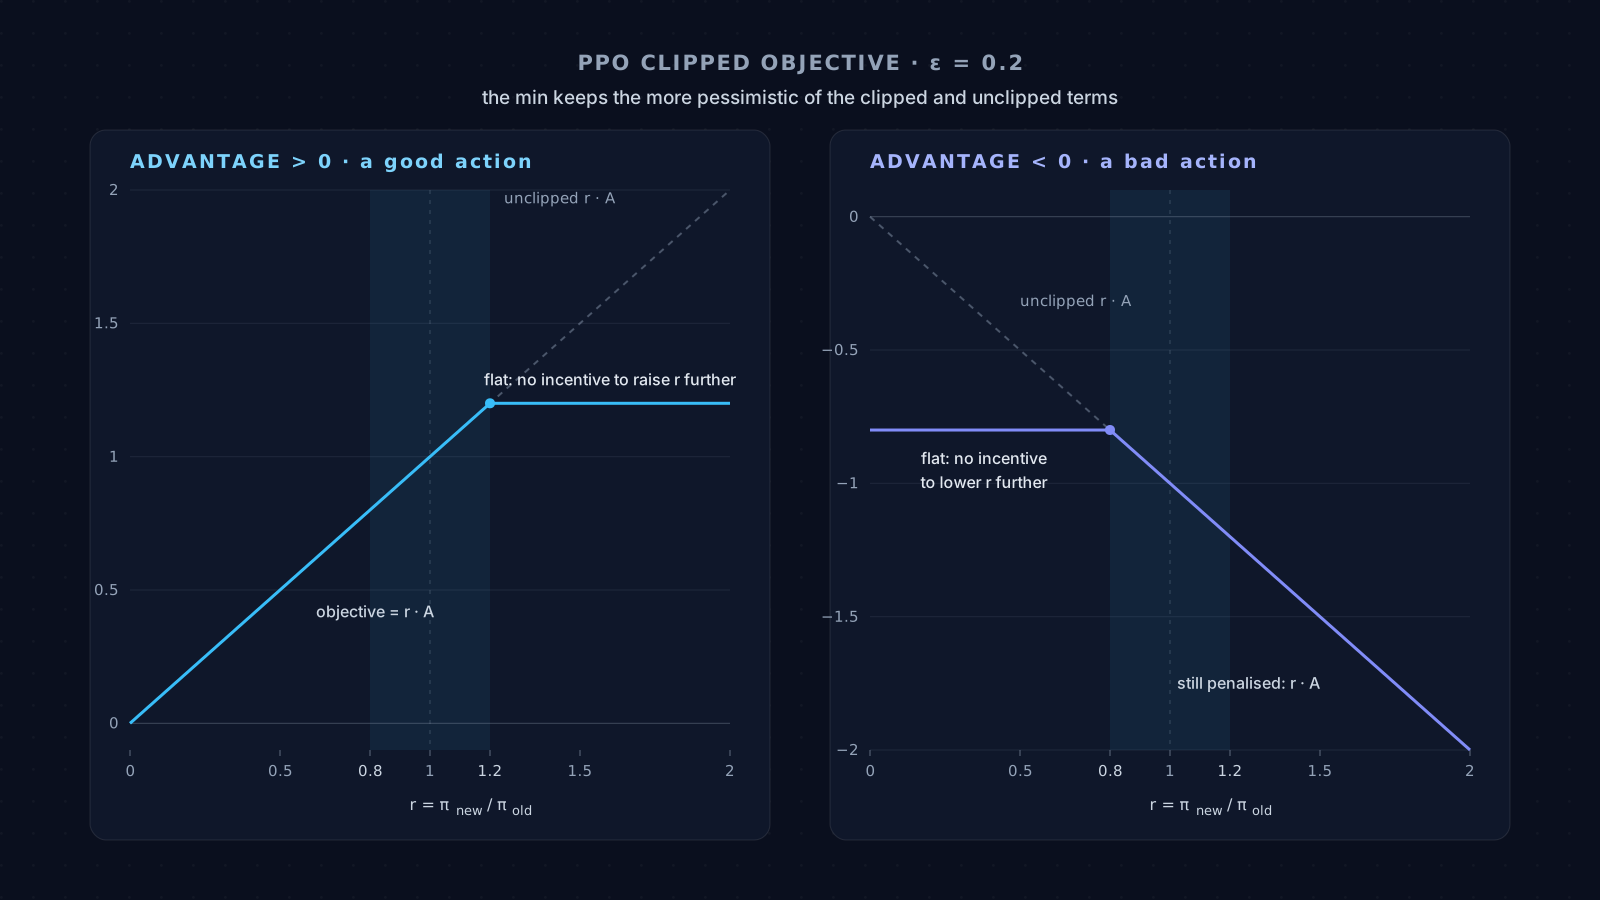
El patrón es asimétrico a propósito. PPO deja de premiar los cambios que se alejan demasiado en la dirección “buena”, pero no deja de castigar los cambios que van en la dirección equivocada. Es una cota pesimista: el objetivo nunca es más optimista que la versión sin recortar.
Y esta es la respuesta a la pregunta con la que terminó la parte 1. PPO funciona mejor cuando le impedimos cambiar demasiado rápido de opinión porque las estimaciones del advantage solo son confiables cerca de la policy que generó los datos. Si la policy se aleja mucho, empieza a tomar decisiones en situaciones que nadie midió, con advantages calculados para otra policy. El clipping mantiene cada actualización en la zona donde los datos todavía dicen algo cierto. Así se puede reutilizar el lote varias veces sin que una estimación ruidosa arrastre a la policy lejos de lo que ya funcionaba.
Un matiz importante: el clipping no prohíbe que salga del intervalo . Elimina el beneficio que el objetivo le atribuye a ciertos cambios extremos, según el signo del advantage, pero la razón todavía puede pasar de ese límite durante una actualización. Es un mecanismo práctico de optimización, no una garantía absoluta de que cada actualización sea pequeña.
En ML-Agents, la implementación sigue la ecuación muy de cerca (la pérdida se minimiza, por eso el signo negativo):
r_theta = torch.exp(log_probs - old_log_probs)
p_opt_a = r_theta * advantage
p_opt_b = torch.clamp(r_theta, 1.0 - epsilon, 1.0 + epsilon) * advantage
policy_loss = -1 * masked_mean(torch.min(p_opt_a, p_opt_b), loss_masks)
Un detalle que la ecuación no muestra: con acciones continuas, ML-Agents calcula y recorta una
razón por cada dimensión de la acción. En nuestro auto son tres razones (steer, throttle y
brake), cada una con su propio recorte, que después se promedian, en lugar de una sola razón para
la acción conjunta.
5. Actor-Critic: una red decide y otra estima
Las implementaciones habituales de PPO usan un esquema actor-critic:
- El actor es la policy: recibe la observación y decide qué acción tomar.
- El crítico estima , el retorno esperado desde el estado actual.
El crítico sirve para calcular si las experiencias fueron mejores o peores de lo esperado. No es infalible: si sus estimaciones están mal, los advantages también lo estarán, y el actor aprenderá de señales equivocadas.
En ML-Agents, con la configuración por defecto, el actor y el crítico son dos redes separadas con la misma forma. En Agentic Racing eran dos MLP de 2 capas de 256 neuronas cada una. Las dos se entrenan juntas, con una única función de pérdida:
- es el objetivo clipped de la sección anterior, con el signo cambiado.
- es el error del crítico al predecir el retorno. En ML-Agents también se recorta con el mismo : si la predicción nueva se aleja más de de la anterior, el error se calcula con la versión más pesimista, así que alejarse más no reduce la pérdida.
- es la entropía de la policy, y su peso. Restarla premia que la policy no se vuelva demasiado segura demasiado pronto, para que siga explorando. En Agentic Racing, fue 0.005 en la primera corrida y 0.01 desde la segunda, siempre como valor inicial.
La parte 1 mostró este crítico en acción. En las primeras corridas, su error (la métrica
Value Loss de ML-Agents) subía a lo largo del entrenamiento: no lograba anticipar lo que iba a
pasar. En la séptima corrida, cuando el agente empezó a ver la curvatura de la pista por delante, quedó
estable en 0.22, aunque esa misma corrida también cambió la recompensa de velocidad.
6. TD error y GAE: estimar el advantage
Queda una pregunta: ¿de dónde sale ?
Una señal habitual es el error de diferencia temporal (TD error):
Aquí es la recompensa (no confundir con la razón de la sección 3; la notación habitual usa la misma letra para las dos), es el factor de descuento y son las estimaciones del crítico. responde una pregunta concreta: “después de esta acción, ¿las cosas salieron mejor o peor de lo que el crítico esperaba?”.
Un solo mira apenas un paso hacia adelante. Sumar muchos mira más lejos pero acumula más ruido. PPO suele usar Generalized Advantage Estimation (GAE), que combina ambos extremos:
controla el peso de las recompensas futuras y cómo se combinan los TD errors a lo largo del tiempo. Con solo cuenta el paso inmediato (poco ruido, pero depende mucho de que el crítico acierte). Con cuenta todo lo que pasó después (menos dependencia del crítico, pero mucho más ruido).
En Agentic Racing, y , así que el factor de la suma es . Eso tiene una lectura concreta:
- el peso de un TD error se reduce a la mitad cada ~12 decisiones, o sea, cada ~1.2 segundos;
- la mayor parte del advantage de una acción se decide por lo que pasa en los dos o tres segundos siguientes.
Es interesante compararlo con la parte 1, donde vimos que el return mira unos 20 segundos hacia adelante. Las dos cosas son compatibles: GAE mira poco hacia adelante de forma explícita, pero cada incluye , y en esa estimación del crítico ya está resumido todo el futuro más lejano. Por eso un crítico que no entiende el mundo arruina los advantages, por bien diseñado que esté el resto.
En la práctica, ML-Agents calcula la suma sobre las experiencias disponibles. Cuando una trayectoria se corta antes de terminar el episodio (por ejemplo, al alcanzar el límite de pasos), usa la estimación del crítico del último estado para no fingir que el futuro vale cero. Y antes de optimizar, normaliza los advantages del lote (media 0, desviación 1), así que lo que importa es qué acciones salieron mejor que las demás de ese mismo lote, no el valor absoluto.
7. El ciclo de entrenamiento de PPO
Con todas las piezas, el ciclo completo queda así:
- Usar la policy actual para interactuar con el entorno.
- Recoger trayectorias: observaciones, acciones, recompensas y las probabilidades que la policy les asignó.
- Estimar valores con el crítico y advantages con GAE.
- Optimizar durante varias épocas sobre el lote, en minibatches.
- En cada minibatch, calcular la razón entre la policy nueva y la anterior.
- Aplicar el objetivo clipped.
- Actualizar actor y crítico con la pérdida combinada.
- Tirar el lote y repetir con experiencias nuevas.
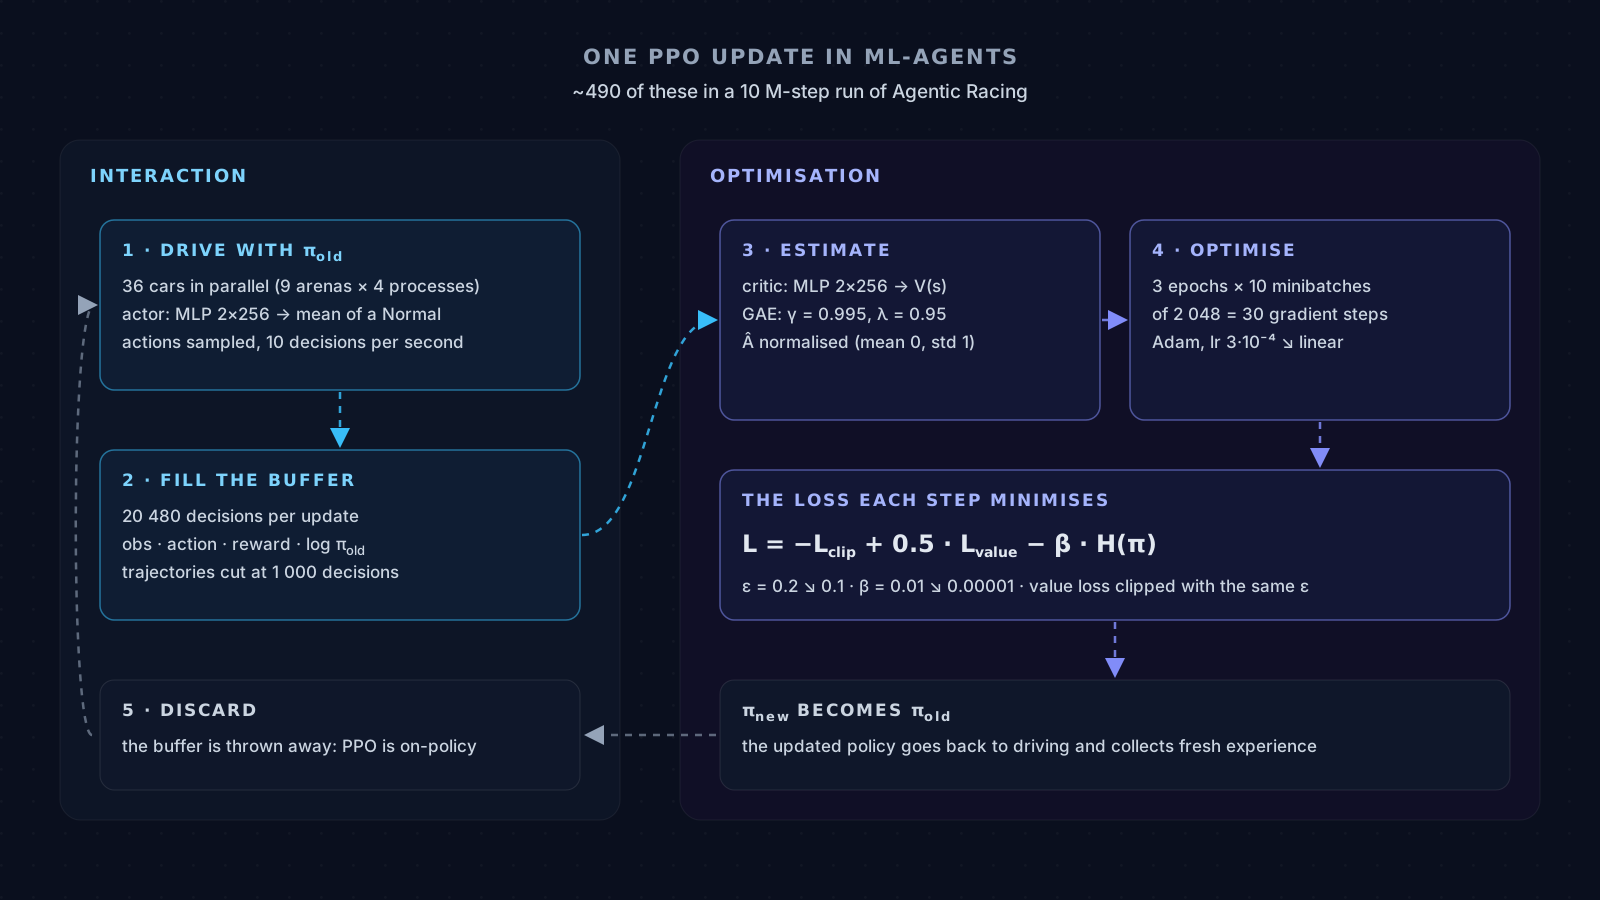
PPO es un método on-policy: aprende de experiencias generadas por su versión actual o por una muy reciente. Puede reutilizar el lote durante algunas épocas (para eso existe la razón y el clipping), pero no está diseñado para reutilizar indefinidamente cualquier experiencia histórica, como hacen los métodos off-policy.
En Agentic Racing, el ciclo tenía estos números:
| Paso | Valor en race_ppo.yaml | Qué significa |
|---|---|---|
| Recolección | buffer_size: 20480 | cada actualización usa 20 480 decisiones, juntadas por 36 autos |
| Optimización | num_epoch: 3, batch_size: 2048 | 3 pasadas por el lote, en 10 minibatches: 30 pasos de gradiente por actualización |
| Clipping | epsilon: 0.2, linear | empieza en 0.2 y baja linealmente hasta 0.1 al final del entrenamiento |
| Tasa de aprendizaje | learning_rate: 3.0e-4, linear | baja linealmente hasta casi cero |
| Entropía | beta: 1.0e-2, linear | baja linealmente hasta 0.00001 |
| GAE | gamma: 0.995, lambd: 0.95 | el horizonte de la sección anterior |
| Trayectorias | time_horizon: 1000 | se cortan cada 1 000 decisiones como máximo; como los episodios duraban como mucho 800, en la práctica el crítico solo completaba el resto cuando se agotaba el tiempo |
| Duración | max_steps: 10000000 | algo menos de 490 actualizaciones de la policy en una corrida de 10 millones de pasos |
Los tres schedules lineales hacen lo mismo en distintas perillas: al principio del entrenamiento la policy puede cambiar más y explorar más; al final, los cambios se vuelven cada vez más pequeños. Es otra forma de “no cambiar de opinión demasiado rápido”, esta vez a lo largo de toda la corrida.
8. Lo que PPO hizo en Agentic Racing
Volvamos a la historia de la parte 1 con estas piezas en la mano. Ocho corridas, de 4 a 20 millones de pasos, y la fracción media de vuelta se quedó siempre alrededor del 10% (entre un 8 y un 13%). ¿Falló PPO?
No exactamente. Las curvas de entrenamiento muestran que PPO hizo su trabajo: optimizó, de forma estable, exactamente el objetivo que le dimos.
Convergió, y rápido. En la primera corrida, la recompensa media pasó de −1.1 a 3.35 en los primeros ~1.85 millones de pasos y después quedó plana durante los 18 millones restantes. En la octava, la recompensa quedó plana desde los ~2.7 millones de pasos. El patrón se repitió en casi todas: una subida estable y una meseta. La excepción fue la tercera, que no llegó a aplanarse en sus 4 millones de pasos; con más entrenamiento, la cuarta volvió a la misma meseta. Hubo ruido, pero no colapsos: el tipo de inestabilidad que PPO intenta evitar nunca fue el problema.
Encontró lo que la recompensa premiaba. En la cuarta corrida, detenerse terminaba el episodio con una penalización fija (−1) que salía más barata que seguir arriesgando, y el agente aprendió a avanzar unos 245 metros (justo hasta la primera curva de verdad), detenerse y cobrar. Eso no es un fallo de PPO; es PPO funcionando. El agente encontró una forma de maximizar la recompensa y la refinó de manera estable. El problema era el objetivo, no el optimizador.
Se volvió seguro de sí mismo. En la primera corrida, con , la entropía de la policy bajó de 1.42 a 0.82. Al duplicar en la segunda, se quedó en 1.27, pero la policy final no mejoró. El término frena el proceso, pero no lo impide: a medida que la policy encuentra algo que funciona, deja de explorar alternativas. Cuando lo que “funciona” es un óptimo local (como en la tercera corrida, que aprendió a arrastrarse a 7 m/s para poder girar sin frenar), el agente se queda ahí.
Esto sugiere una lectura que vale la pena explicitar. La virtud de PPO (cambios pequeños, mejoras graduales cerca de lo que ya hace la policy) tiene un costo cuando la conducta buena está lejos de la actual. La maniobra completa de una curva (frenar, girar, volver a acelerar) es una secuencia coordinada de uno o dos segundos que la policy tendría que encontrar por exploración. Un método de policy gradient solo puede reforzar lo que la policy ya prueba de vez en cuando, y PPO, con su clipping, vuelve esos pasos todavía más prudentes. Si casi nunca prueba la secuencia correcta, ningún policy gradient la va a inventar.
Esa es una hipótesis razonable, pero no la única causa: como contó la parte 1, había además problemas de física y de geometría de pista que hacían la maniobra mucho más difícil de lo que debía ser.
9. Cuando PPO no aprende, el problema puede no ser PPO
Que el entrenamiento se ejecute no demuestra que el agente esté aprendiendo la tarea. Cuando progresa poco, conviene revisar de forma sistemática. Así respondió Agentic Racing a cada una de estas preguntas:
| Pregunta | En Agentic Racing |
|---|---|
| Observaciones: ¿contienen información suficiente? | Las seis primeras corridas no veían la curvatura de la pista por delante; los raycasts llegaban a 40 m. Se agregaron tres observaciones de curvatura y rayos de 70 m en la séptima. |
| Acciones: ¿permiten controlar el vehículo? | Tres acciones continuas. El freno anula el acelerador mientras está activo, y la policy casi nunca lo usó (freno medio de 0.02 en las evaluaciones). |
| Recompensa: ¿incentiva lo que queremos? | No siempre. La recompensa de velocidad lineal hacía que frenar fuera puro costo, y la de detenerse abría una salida fácil (corrida 4). |
| Física: ¿las consecuencias son coherentes? | No al principio. El modelo de agarre lateral borraba la velocidad lateral en lugar de redirigirla, y cada giro fuerte frenaba el auto casi en seco. |
| Dificultad: ¿el entorno es resoluble? | Las pistas procedurales tenían curvas que ni un controlador escrito a mano podía tomar. En un circuito fijo y limpio, ese controlador completó vueltas enteras. |
| Configuración: ¿los hiperparámetros son razonables? | Razonables, pero mejorables. La primera corrida usó 20 millones de pasos y convergió en ~1.85 millones: cerca del 90% del cómputo no aportó nada. |
| Evidencia: ¿medimos la tarea o solo el entrenamiento? | La recompensa media subía; la fracción de vuelta no. Hizo falta un evaluador aparte (fracción de vuelta, motivo de fin de episodio, freno medio) para ver lo que pasaba de verdad. |
Conviene separar tres preguntas, porque cada una necesita evidencia distinta:
- ¿El entrenador se ejecuta como esperamos? Logs limpios, observaciones del tamaño correcto, episodios que terminan por los motivos esperados.
- ¿La señal de aprendizaje contiene información útil? Recompensa, value loss y entropía que se comportan de forma interpretable, sin salidas fáciles.
- ¿Mejora el comportamiento en la tarea? Métricas propias de la tarea (en este caso, fracción de vuelta y tiempo por vuelta) en pruebas independientes del entrenamiento.
Agentic Racing respondía “sí” a la primera durante casi todo el proyecto, “a medias” a la segunda y “no” a la tercera. La curva de recompensa, por sí sola, nunca lo habría dicho.
10. PPO no es la única herramienta
Si aprender desde cero resulta difícil, puede ayudar partir de las demostraciones de un experto:
- Behavioral cloning (BC): aprende a imitar pares observación → acción grabados del experto, como aprendizaje supervisado.
- Generative Adversarial Imitation Learning (GAIL): entrena un discriminador que distingue el comportamiento del agente del del experto, y usa esa señal como recompensa adicional mientras el agente sigue aprendiendo con RL.
- PPO: optimiza la policy con las recompensas del entorno.
ML-Agents permite combinarlos en la misma configuración. Agentic Racing llegó a prepararlo: el evaluador del proyecto podía grabar demostraciones del controlador escrito a mano, y la configuración de entrenamiento tuvo bloques de BC y GAIL (con pesos de 0.5 y 0.15). Pero la última corrida, la octava, se hizo con PPO limpio, sin ese andamiaje, para tener una lectura clara de si el algoritmo por sí solo alcanzaba con el agarre ya corregido y las pistas suavizadas.
Combinar demostraciones con RL puede ayudar con el problema de exploración de la sección 8: el agente no necesita descubrir por azar la secuencia frenar–girar–acelerar si alguien se la muestra. Pero no garantiza mejores resultados, y no compensa un entorno roto: imitar a un experto en una pista imposible sigue llevando a la misma pared.
Conclusión: mejorar sin destruir lo que ya funciona
PPO propone una manera práctica de actualizar una policy reduciendo el incentivo a que los cambios extremos dominen la optimización. La razón , el advantage y el objetivo clipped son el núcleo de la idea; el esquema actor-critic y GAE sirven para estimar qué acciones salieron mejor o peor de lo esperado.
La respuesta a la pregunta de la parte 1 es, en una frase: porque las estimaciones solo valen cerca de la policy que generó los datos. El clipping mantiene cada actualización en esa zona, y eso permite reutilizar la experiencia sin que una estimación ruidosa arrastre a la policy hacia algo peor.
Pero Agentic Racing muestra el otro lado de esa estabilidad. PPO optimizó con mucha estabilidad el objetivo que le dimos, incluso cuando ese objetivo premiaba detenerse. Para que un agente de conducción aprenda, el algoritmo es solo una pieza: también importan las observaciones, las acciones, la recompensa, la física, la dificultad del entorno y la forma en que medimos el progreso.
No basta con implementar PPO: hay que diseñar experimentos que permitan descubrir por qué el agente aprende, o por qué no lo hace.
Siguiente en la serie: la parte 3, “¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero”, desarrolla la idea de la sección 10: partir de las demostraciones de un experto.
Si llegaste directo a este artículo, la parte 1 explica los conceptos base con el mismo proyecto, y Agentic Racing: un piloto que nunca aprendió a manejar cuenta la historia completa del proyecto, incluido el jefe de equipo LLM que terminó siendo el centro del demo.
Referencias
- Schulman, J. et al. (2017). Proximal Policy Optimization Algorithms.
- Schulman, J. et al. (2015). High-Dimensional Continuous Control Using Generalized Advantage Estimation.
- OpenAI Spinning Up. Proximal Policy Optimization.
- Unity Technologies. Unity ML-Agents Toolkit, en
particular el optimizador de PPO (
ml-agents/mlagents/trainers/ppo/optimizer_torch.py) y la funciónget_gae(ml-agents/mlagents/trainers/trainer/trainer_utils.py) del release demlagents1.1.0. - La configuración de entrenamiento (
training/config/race_ppo.yaml), el agente (RaceAgent.cs) y la bitácora de las ocho corridas están en github.com/alulema/agentic-racing.