Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema (este artículo)
Dónde nos quedamos
Llevamos cuatro preguntas:
| Parte | Pregunta | Respuesta corta |
|---|---|---|
| 1 | ¿Puede un agente aprender por prueba y error? | sí, con una recompensa; y encontrará cualquier atajo que esa recompensa deje abierto |
| 2 | ¿Cómo mejoramos la policy sin destruirla? | PPO: actualizaciones recortadas, cerca de la policy anterior |
| 3 | ¿Podemos enseñarle mostrando qué hace un experto? | BC: aprendizaje supervisado sobre pares ; frágil fuera de las demostraciones |
| 4 | ¿Podemos hacer que se comporte como el experto? | GAIL: un discriminador convierte la imitación en una recompensa aprendida |
La parte 4 terminó con la siguiente:
¿Podemos combinar todas estas ideas?
La versión más concreta de esa pregunta es esta: ¿podemos usar las demostraciones de un experto para arrancar con una policy útil, y después dejar que el reinforcement learning la mejore?
La advertencia de siempre, esta vez más grande
En Agentic Racing no se ejecutó ninguna combinación. BC y GAIL se configuraron para la octava corrida y se quitaron antes de lanzarla; nunca se grabó una demostración; no existe ninguna policy entrenada con imitación, ni un fine-tuning posterior. Este artículo, entonces, no reporta un pipeline: diseña el experimento que el proyecto no llegó a correr, con lo que el repositorio sí tiene (el experto, el grabador, el evaluador, la configuración que se escribió) y con lo que dice el código de ML-Agents sobre cómo se combinarían las piezas.
Como en las partes anteriores, cada tabla de resultados es una plantilla con ”?”, no un resultado.
1. Por qué combinar: el caso de Agentic Racing
La motivación no es abstracta. En las partes 1 y 2 vimos lo que pasó con PPO solo: ocho corridas sobre pistas procedurales, y la policy se quedó alrededor del 10% de la vuelta (entre un 8 y un 13%). En la octava, la más cuidada, el 91% de los episodios terminó con el auto fuera de la pista y solo un 4% con la vuelta completa.
Mientras tanto, el experto, el piloto heurístico de la parte 3, sí conduce. Cuando el proyecto pasó a un circuito fijo (un rectángulo de esquinas redondeadas de unos 2 km), el experto lo recorrió sin salirse ni trabarse, y una vez conectadas las directivas a su manejo, todos los autos de evaluación completaban la vuelta entera (siempre desde arranques limpios, como graba el evaluador al experto).
Esa asimetría es exactamente el caso que justifica combinar:
PPO solo:  aprende de la recompensa, pero no encuentra cómo dar la vuelta
Experto:   da la vuelta, pero no aprende nada
La hipótesis es que las demostraciones le ahorren a PPO la parte más difícil de la exploración (llegar a conducir una vuelta) y que después la recompensa haga el resto. Es una hipótesis razonable. Pero también hay una explicación rival que nadie descartó: el circuito fijo hizo el problema mucho más fácil, y PPO solo nunca se probó sobre él. Quizás ya no necesita ayuda. Volveremos a eso.
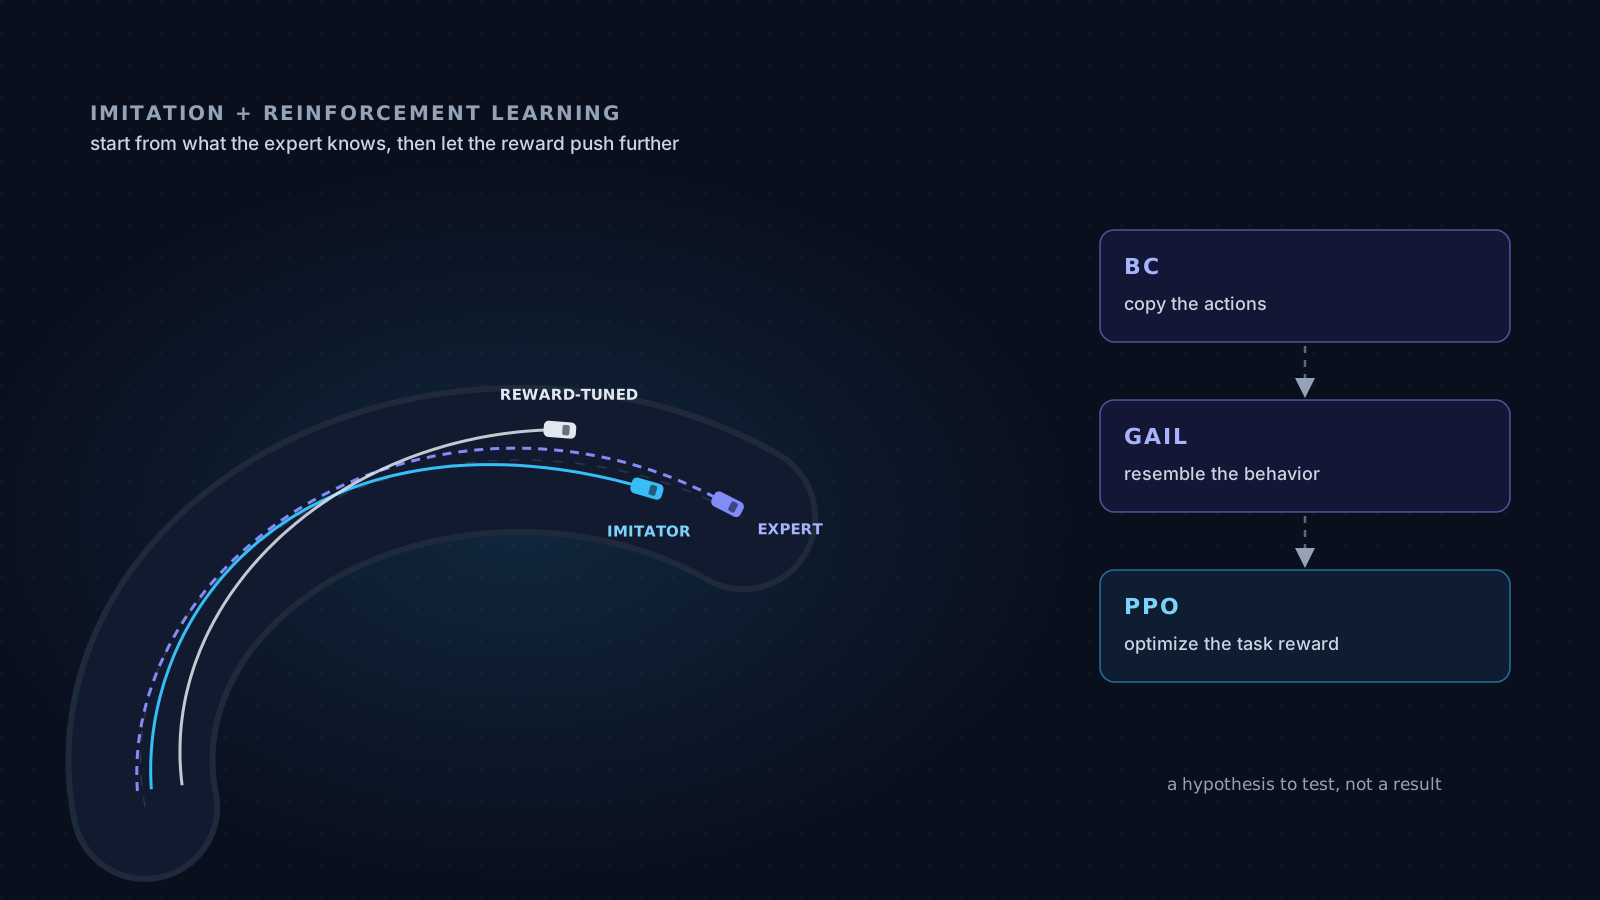
2. La cadena intuitiva: BC → GAIL → PPO
La forma natural de imaginar la combinación es una cadena de etapas:
experto → demostraciones → BC → policy inicial → GAIL → fine-tuning con PPO → evaluaciónCada etapa respondería una pregunta distinta:
BC:   "empieza copiando lo que hace el experto"
GAIL: "refina el comportamiento para que se parezca al del experto"
PPO:  "ahora optimiza la recompensa de la tarea"
Es una buena forma de ordenar el razonamiento. Pero, como vimos al final de la parte 4, no es lo que hace ML-Agents cuando pones los tres en una configuración. Y la diferencia importa para diseñar el experimento.
3. Lo que ML-Agents hace de verdad: todo a la vez
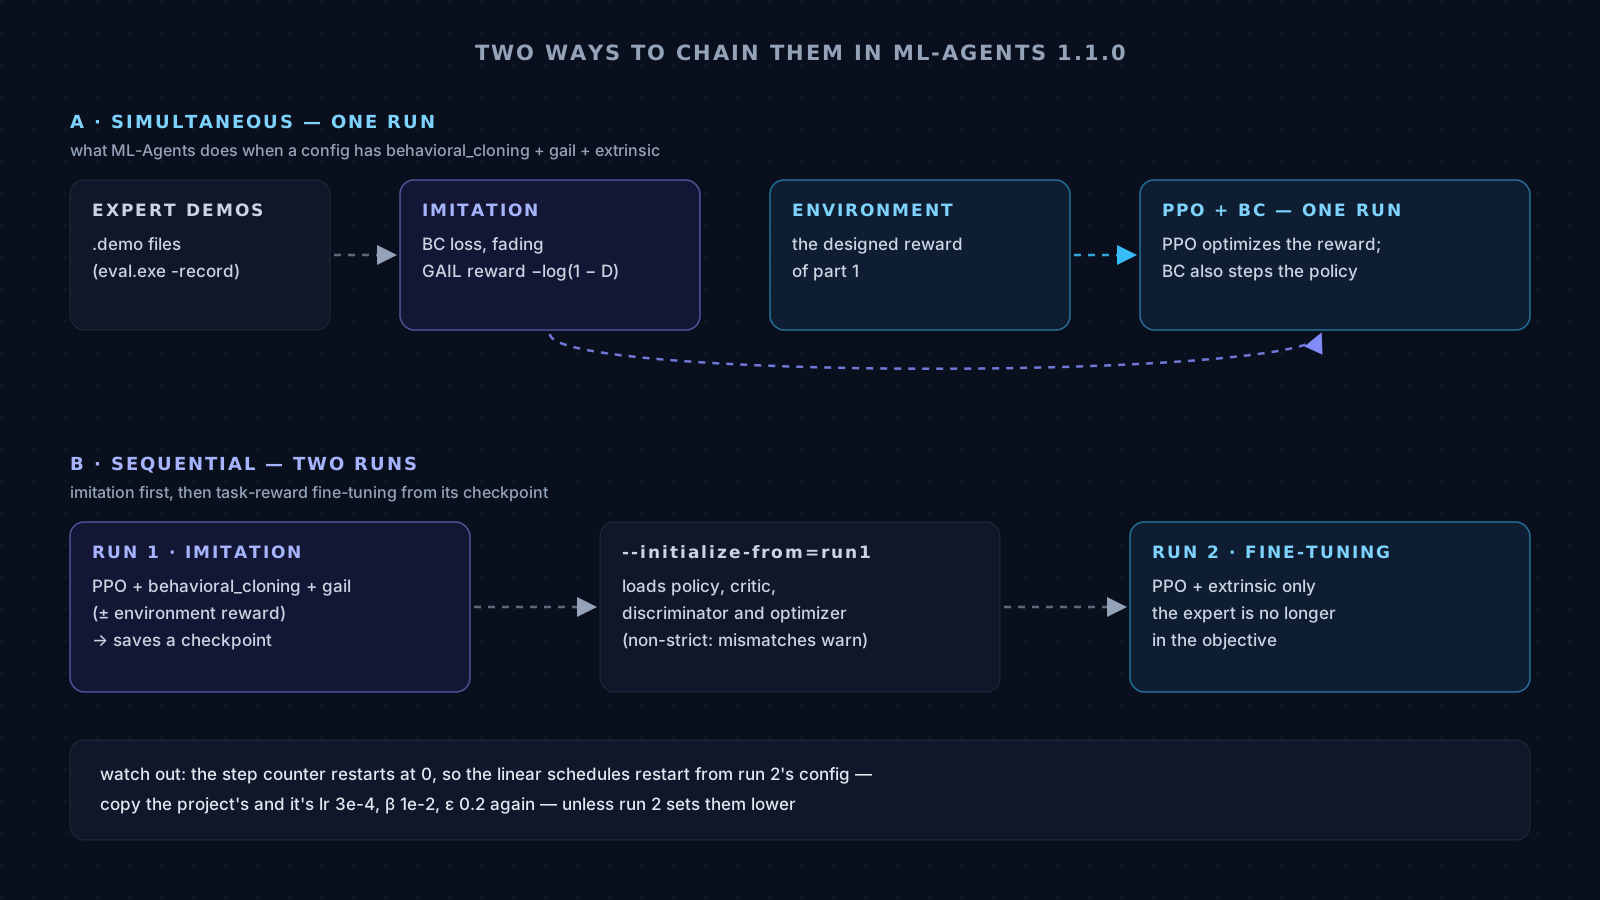
En ML-Agents 1.1.0 no hay etapas. Hay una sola corrida de PPO a la que se le enchufan dos fuentes adicionales de conocimiento:
- BC es una pérdida supervisada que se aplica después de cada actualización de PPO, con una tasa de
aprendizaje que se apaga a lo largo de
steps(parte 3). - GAIL es una señal de recompensa más, con su propia cabeza en el crítico, que dura toda la corrida (parte 4).
- PPO es el único algoritmo de RL: el que optimiza la recompensa.
Ojo con un detalle: BC no es solo “información” para PPO. Tiene su propio optimizador y da sus propios pasos de gradiente sobre los pesos de la policy, después de cada actualización de PPO. Así que, mientras BC está activo, dos optimizadores tiran de la misma red: PPO hacia más recompensa, BC hacia las acciones del experto. GAIL, en cambio, no toca la policy: solo cambia la recompensa que PPO ve.
La configuración que se preparó para la octava corrida era exactamente eso: recompensa del entorno con peso 1.0, GAIL con 0.15 y BC con 0.5 durante los primeros 2 millones de pasos. No es una cadena: es una mezcla cuyo balance cambia con el tiempo, porque BC se apaga y GAIL no.
Una precisión sobre BC. La documentación de ML-Agents dice que BC “puede usarse solo o como
pre-entrenamiento”, pero en el código de 1.1.0 BC siempre es un módulo que corre dentro de un
entrenador de RL (PPO, SAC o POCA): no hay un entrenador que haga solo BC, sin interactuar con el entorno. Un BC “puro”, como el de
la parte 3, habría que escribirlo aparte (ML-Agents trae un lector de archivos .demo que serviría como
punto de partida).
4. La versión secuencial: dos corridas
Si queremos la cadena de verdad, con una etapa de imitación y después una de fine-tuning, ML-Agents lo permite con una opción de línea de comandos:
mlagents-learn imitacion.yaml   --run-id=imit
mlagents-learn finetuning.yaml  --run-id=ft --initialize-from=imit
La segunda corrida arranca desde el checkpoint de la primera. Leyendo el código que hace esa carga, hay tres detalles que conviene conocer antes de interpretar nada:
- Carga más que la policy. Carga todos los módulos registrados: la policy, el crítico, el optimizador de PPO y los pesos de cada proveedor de recompensa, incluido el discriminador de GAIL si la segunda corrida también lo usa. (No guarda ni carga el optimizador propio de BC ni el del discriminador: esos arrancan de nuevo.)
- Tolera diferencias. La carga no es estricta: si la segunda configuración ya no tiene GAIL, los pesos de su cabeza en el crítico se ignoran; lo que falta queda con su inicialización nueva; y si una pieza no encaja, se deja un aviso en el log y se carga lo que se pueda o se reinicia. Por ejemplo, al quitar GAIL el crítico cambia de forma, y el optimizador de PPO no puede cargar su estado anterior: arranca de nuevo. Eso es cómodo, pero también significa que un error de configuración no detiene la corrida: hay que leer el log.
- El contador de pasos vuelve a cero. Y con él, todos los schedules lineales de la parte 2: vuelven
al valor inicial que diga la configuración de la segunda corrida y decaen a lo largo de sus propios
max_steps. Si se copia la configuración del proyecto, eso significa tasa de aprendizaje , y 0.2. Para un fine-tuning eso es justo lo contrario de lo que queremos: después de aprender a imitar, la segunda corrida empieza con una tasa de aprendizaje y una presión de entropía tan altas como al inicio de la primera. Si no se bajan a mano en la segunda configuración, el fine-tuning puede empezar deshaciendo lo que la imitación construyó.
5. Dos arquitecturas que vale la pena comparar
Con eso, las dos opciones concretas son:
Arquitectura A — simultánea, una corrida
demostraciones ─┬─► BC (se apaga) ─────────┐
                └─► GAIL (recompensa) ─────┤
recompensa del entorno ────────────────────┴─► PPO ─► policy
Es la que se preparó para Agentic Racing. Ventaja: una sola corrida, y la recompensa del entorno está presente desde el principio, así que la imitación nunca se optimiza sola. Riesgo: el balance entre señales lo decide la escala de cada una, no solo el peso escrito en la configuración (sección 7).
Arquitectura B — secuencial, dos corridas
corrida 1: PPO + BC + GAIL ──checkpoint──► corrida 2: PPO + solo recompensa del entornoVentaja: separa con claridad qué aporta cada etapa, porque se puede evaluar el checkpoint intermedio. Riesgo: al quitar la imitación, nada impide que la policy se aleje del experto. Eso puede ser bueno (encontrar algo mejor) o malo (olvidar habilidades útiles). Y como vimos en la parte 1, PPO solo con esta recompensa ya encontró una vez una salida fácil: en la cuarta corrida aprendió a detenerse a propósito.
Ninguna es superior de antemano. Hay que probarlas.
6. ¿Qué significa que una policy sea “mejor”? En este proyecto, no es solo el tiempo
Antes de comparar, hay que decidir qué medimos. Lo obvio sería medir conducción: vueltas completas, tiempo por vuelta, salidas de pista. Pero en Agentic Racing hay algo más importante, y es lo que más cambia el diseño del experimento.
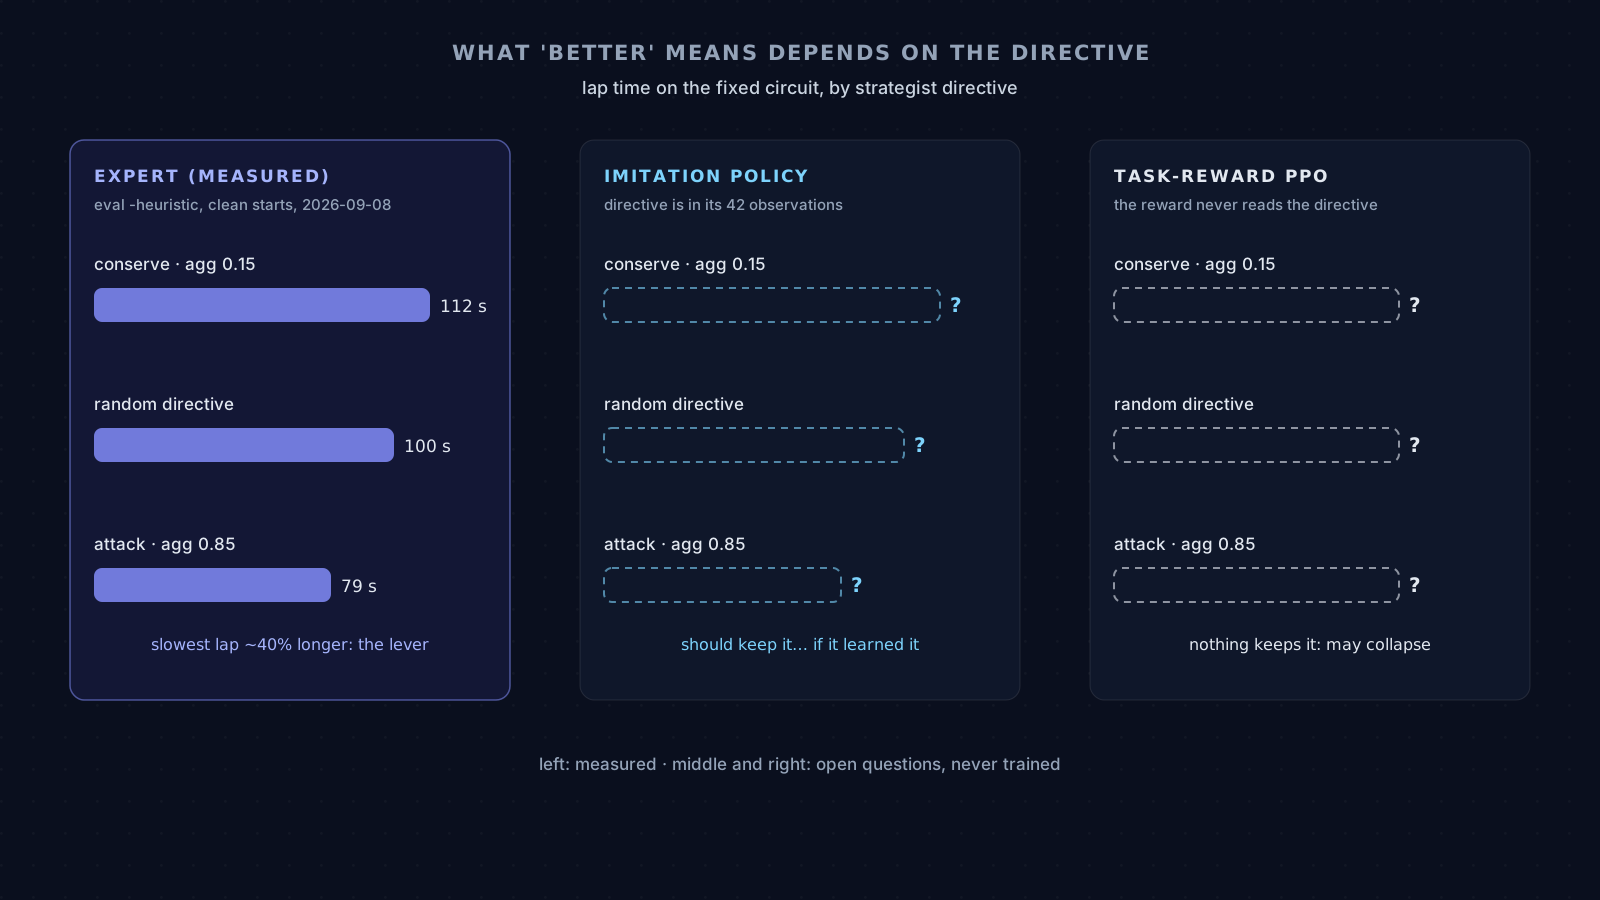
El piloto del demo no existe para ser rápido. Existe para obedecer al estratega. En el vector de 42 observaciones hay 6 canales de directiva (agresión, tolerancia al riesgo y el tipo de directiva: atacar, defender, conservar, empujar), y durante el entrenamiento se sortean al azar en cada episodio, justamente para que la policy aprenda a conducir distinto según lo que diga el estratega.
El experto sí lo hace. Medido sobre el circuito fijo:
| Directiva forzada | Tiempo por vuelta |
|---|---|
| conservar, agresión 0.15 | 112 s |
| aleatoria por episodio | 100 s |
| atacar, agresión 0.85 | 79 s |
La vuelta más lenta tarda unos 33 s más que la más rápida, cerca de un 40% más: esa es la palanca real que tiene el estratega LLM sobre la carrera.
Ahora miremos la recompensa de la tarea. Sus términos son los de la parte 1: progreso, velocidad objetivo, trazada, bordes, salidas, vuelta completa. Y la velocidad objetivo que premia depende de la curvatura de la pista, no de la directiva. Ningún término de la recompensa lee los canales de directiva.
Eso tiene una consecuencia incómoda:
- Una policy que imite al experto tiene una razón para responder a la directiva: el experto lo hace, y la directiva está en sus observaciones.
- Una policy que optimice solo la recompensa no tiene ninguna. Para ella, los 6 canales son ruido. Lo más rentable es conducir de la forma que más recompensa da, sea cual sea la directiva.
Es decir, en la arquitectura B, el fine-tuning con la recompensa de la tarea podría mejorar el tiempo por vuelta y, al mismo tiempo, borrar justo lo que el demo necesita: que el auto conduzca distinto cuando el estratega dice “ataca” que cuando dice “conserva”. Nadie lo midió, así que es una pregunta, no un hallazgo. Pero es la pregunta más importante del experimento.
Por eso, en este proyecto, la evaluación necesita tres familias de métricas, no dos:
Conducción
- fracción de vuelta, vueltas completas y tiempo por vuelta;
- motivos de fin de episodio: salida de pista, auto detenido, sin progreso;
- recuperación desde arranques con ruido.
Imitación
- parecido de trayectorias y de distribución de acciones con el experto, en especial el freno;
- velocidad por tramo y comportamiento en las cuatro curvas.
Respuesta a la directiva
- tiempo por vuelta con cada directiva forzada;
- la diferencia entre “atacar” y “conservar”, comparada con la del experto.
El evaluador del proyecto (eval.exe) ya cubre buena parte de la primera familia: fracción de vuelta,
motivos de fin de episodio y velocidades, y evalúa las policies entrenadas desde arranques con ruido (al
experto lo evalúa siempre desde arranques limpios). El tiempo por vuelta solo lo reporta directamente en
su modo de población, así que habría que agregarlo. También permite forzar una directiva en todos los
autos, así que la tercera familia sale casi gratis. La segunda habría que construirla.
7. El peso de cada señal
En la parte 4 hicimos la cuenta: con el discriminador indeciso, GAIL con peso 0.15 paga unos 0.10 por decisión, y la recompensa diseñada, conduciendo bien, unos 0.07. El 0.15 parecía chico y no lo era.
La propia documentación de ML-Agents va en la misma dirección. Recomienda mantener el peso de GAIL por debajo de 0.1 cuando las demostraciones no son óptimas y hay recompensa del entorno, para que el agente se enfoque en la recompensa y no en copiar; su ejemplo de referencia que combina las tres cosas (PushBlock) usa 0.01. Y advierte del sesgo de supervivencia que vimos en la parte 4: una recompensa siempre positiva por paso empuja al agente a alargar el episodio, y puede tapar la recompensa de la tarea. Si el agente parece ignorar la recompensa del entorno, la indicación es bajar el peso de GAIL.
Así que el peso de GAIL no es un detalle de configuración: es una de las variables del experimento. Como mínimo, habría que probar el 0.15 planeado y un valor del orden que recomienda la documentación.
8. Diseñar un experimento reproducible
Con todo lo anterior, el experimento de la parte 4 se amplía así:
| Variante | Qué entrena | En ML-Agents |
|---|---|---|
| A. PPO desde cero | recompensa del entorno | extrinsic, una corrida |
| B. BC puro | solo demostraciones | código propio: no hay entrenador de BC sin entorno |
| C. GAIL + entorno | imitación como recompensa | gail + extrinsic, una corrida |
| D. Simultánea | BC + GAIL + entorno | la configuración preparada para la octava corrida |
| E. Secuencial | D, y después fine-tuning | segunda corrida con --initialize-from, solo extrinsic |
Y, para cada una:
| Métrica | A | B | C | D | E |
|---|---|---|---|---|---|
| Vueltas completas | ? | ? | ? | ? | ? |
| Tiempo por vuelta | ? | ? | ? | ? | ? |
| Salidas de pista | ? | ? | ? | ? | ? |
| Parecido con el experto | ? | ? | ? | ? | ? |
| Diferencia atacar / conservar | ? | ? | ? | ? | ? |
| Recuperación desde arranques con ruido | ? | ? | ? | ? | ? |
Para que esa tabla signifique algo, cada variante tiene que competir en condiciones comparables:
- El mismo presupuesto de interacción. E recibe los pasos de D más los de su segunda corrida; hay que comparar a igualdad de pasos totales, o al menos reportarlos. Y las demostraciones también cuestan: el grabador corre por defecto 300 s de simulación con el experto, en todas las arenas a la vez, y esos pasos no aparecen en el contador de pasos de PPO.
- Varias semillas.
mlagents-learnacepta--seed; con una sola corrida por variante no hay forma de distinguir un efecto del azar. Reportar media y dispersión, no la mejor corrida. - El mismo entorno y las mismas demostraciones. El mismo build, la misma física, el mismo conjunto
de
.demopara todas las variantes que los usen. - Las mismas reglas de evaluación. Mismo número de episodios, mismos arranques, mismo criterio para elegir el checkpoint (el último, o el mejor según una métrica fijada de antemano, nunca el que “se ve mejor”).
- Una prueba de generalización honesta. Las demostraciones saldrían todas del circuito fijo, que es la pista por defecto. El generador de pistas procedurales sigue en el código; evaluar ahí, sin haber entrenado ahí, diría si la policy aprendió a conducir o memorizó un circuito.
El proyecto ya tiene un precedente de este tipo de rigor. En el experimento del estratega LLM contra el estratega heurístico, se corrieron series de 18 carreras con la parrilla rotada, se reportó la media con su desviación estándar, y el primer resultado fue contrario a lo esperado. Se publicó así. La misma disciplina aplicaría aquí.
9. Cómo leer los resultados (cuando existan)
Sin números, lo que sí se puede escribir de antemano es qué significaría cada patrón:
- Si A ya completa vueltas en el circuito fijo, la motivación original de la imitación desaparece. Lo que quede por medir es si la imitación enseña algo que PPO no: la respuesta a la directiva.
- Si B conduce bien desde arranques limpios pero falla desde arranques con ruido, es el problema de errores acumulativos de la parte 3, tal como se esperaba.
- Si C o D mejoran la duración de los episodios pero no las vueltas completas, sospechar del sesgo de supervivencia de GAIL antes que celebrar.
- Si E mejora el tiempo por vuelta pero la diferencia entre atacar y conservar se encoge, ganó en la métrica equivocada para este demo.
- Si las diferencias entre variantes son menores que la dispersión entre semillas, el resultado honesto es “no hay efecto detectable”.
Un experimento útil no es el que demuestra que la arquitectura funciona. Es el que está diseñado para poder revelar que no funciona.
10. ¿Y si el experto no es perfecto?
No lo es. El experto frena según una regla fija, una velocidad objetivo calculada a partir de la curva que viene, y tiene comportamientos de recuperación que dependen de temporizadores que la policy no ve (parte 3). Ninguna técnica de imitación, por sí sola, está diseñada para superarlo: BC aprende sus decisiones, GAIL aprende a parecerse a él.
Para superarlo hace falta una señal que diga “esto es mejor”, y esa señal es la recompensa. Ahí está el atractivo de la arquitectura B. Pero “mejor según la recompensa” solo es “mejor” si la recompensa mide lo que queremos, y la sección 6 mostró que en este proyecto no mide lo más importante. Antes de un fine-tuning, habría que decidir si la recompensa necesita un término que premie respetar la directiva. Eso ya no es combinar algoritmos: es volver a diseñar el objetivo, el problema de la parte 1.
11. ¿Y si una sola pieza ya alcanza?
Hay que contemplarlo en serio. Si BC produce una policy fiable, quizá GAIL agregue complejidad sin mejorar nada. Si D funciona, quizá E la empeore. Cada etapa tiene que justificar su existencia con evidencia:
¿Qué mejora concreta aporta esta etapa, y cuánto cuesta conseguirla?
Agentic Racing llevó esa pregunta más lejos que cualquier variante de la tabla. Después de la octava corrida, la decisión fue no entrenar ningún piloto: el experto heurístico, con las directivas conectadas a su ritmo, su frenada y su línea, pasó a ser el piloto del demo. El objetivo del proyecto era mostrar el ciclo entre el piloto y el estratega, y para eso no hacía falta una red neuronal: hacía falta un piloto que cambiara de comportamiento según la directiva, y el experto ya lo hacía.
No es una conclusión sobre BC, GAIL o PPO. Es una conclusión sobre ingeniería: a veces la pieza más sencilla que cumple el objetivo es la correcta, y el pipeline más sofisticado queda como experimento para otro día.
12. Implementado, ejecutado, evaluado
Vale la pena separar tres niveles de madurez, porque se confunden con facilidad:
- Implementado: el código existe.
- Ejecutado: se corrió y hay evidencia.
- Evaluado: se midió y se comparó contra una referencia.
Aplicado a Agentic Racing:
| Pieza | Implementado | Ejecutado | Evaluado |
|---|---|---|---|
| Experto heurístico | sí | sí: es el piloto del demo | sí: vueltas completas en el circuito fijo y tiempos por directiva |
Grabación de demostraciones (eval.exe -record) | sí | no hay registro de que se haya usado | — |
| PPO | sí | sí: ocho corridas en pistas procedurales | sí: alrededor del 10% de vuelta (8–13%); en el circuito fijo, nunca |
| BC | configurado | no: se quitó antes de la octava corrida | — |
| GAIL | configurado | no: se quitó junto con BC | — |
| BC + GAIL + PPO simultáneo | configurado | no | — |
| Fine-tuning secuencial | no | no | — |
Que una configuración exista no demuestra que funcione. Que una corrida se haya ejecutado tampoco demuestra que mejore frente a una referencia. Esta tabla es lo que un lector debería poder pedirle a cualquier proyecto de RL antes de creerle una curva.
Conclusión
BC, GAIL y PPO atacan partes distintas del problema:
- BC usa las demostraciones para aprender directamente las acciones del experto.
- GAIL convierte la comparación con el experto en una recompensa.
- PPO optimiza una policy con la recompensa que reciba, sea cual sea.
La cadena BC → GAIL → PPO es una buena forma de pensarlos juntos, pero en ML-Agents la combinación
natural es simultánea: una sola corrida de PPO, con BC empujando la policy hacia el experto y GAIL
sumando su recompensa. La versión secuencial existe,
con --initialize-from, y trae sus propias trampas: los schedules reinician, y quitar la imitación deja
a la policy a merced de la recompensa.
Y en este proyecto esa recompensa tiene un punto ciego concreto: no sabe nada de las directivas del estratega, que son la razón de ser del piloto. Es el tipo de hallazgo que solo aparece cuando se diseña el experimento con el sistema real en la mano, y no con una arquitectura genérica en la cabeza.
La pregunta interesante no es si podemos encadenar tres algoritmos, sino si cada uno aporta algo medible que los otros no aportan.
Agentic Racing tiene casi todo lo necesario para responderla: el experto, el grabador, el evaluador y la configuración. Le falta lo más importante: correrlo.
Si llegaste directo a este artículo, las cuatro partes anteriores están enlazadas al principio, y Agentic Racing: un piloto que nunca aprendió a manejar cuenta la historia completa del proyecto.
Referencias
- Ho, J. y Ermon, S. (2016). Generative Adversarial Imitation Learning. NeurIPS.
- Schulman, J. et al. (2017). Proximal Policy Optimization Algorithms.
- Ross, S., Gordon, G. y Bagnell, J. A. (2011). A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS.
- Rajeswaran, A. et al. (2018). Learning Complex Dexterous Manipulation with Deep Reinforcement Learning and Demonstrations. RSS. (Un antecedente de inicializar con BC y afinar con RL.)
- Kostrikov, I. et al. (2019). Discriminator-Actor-Critic: Addressing Sample Inefficiency and Reward Bias in Adversarial Imitation Learning. ICLR.
- Unity Technologies. Unity ML-Agents Toolkit, release de
mlagents1.1.0: la sección de imitation learning dedocs/ML-Agents-Overview.md, los parámetros degailybehavioral_cloningendocs/Training-Configuration-File.md,--initialize-fromendocs/Training-ML-Agents.md, y la carga de checkpoints enml-agents/mlagents/trainers/model_saver/torch_model_saver.py. - La configuración de entrenamiento, el experto, el evaluador y la bitácora del proyecto están en github.com/alulema/agentic-racing.