Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero (este artículo)
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema
Dónde nos quedamos
La parte 2 terminó con una lectura incómoda de lo que pasó en Agentic Racing. PPO optimizó con estabilidad el objetivo que le dimos, pero solo puede reforzar lo que la policy ya prueba de vez en cuando. La maniobra completa de una curva (frenar, girar, volver a acelerar) es una secuencia coordinada de uno o dos segundos, y si la policy casi nunca la prueba por azar, ningún policy gradient la va a inventar.
En la sección 10 de esa parte mencionamos, en un par de líneas, una salida a ese problema: partir de las demostraciones de un experto. Este artículo la desarrolla.
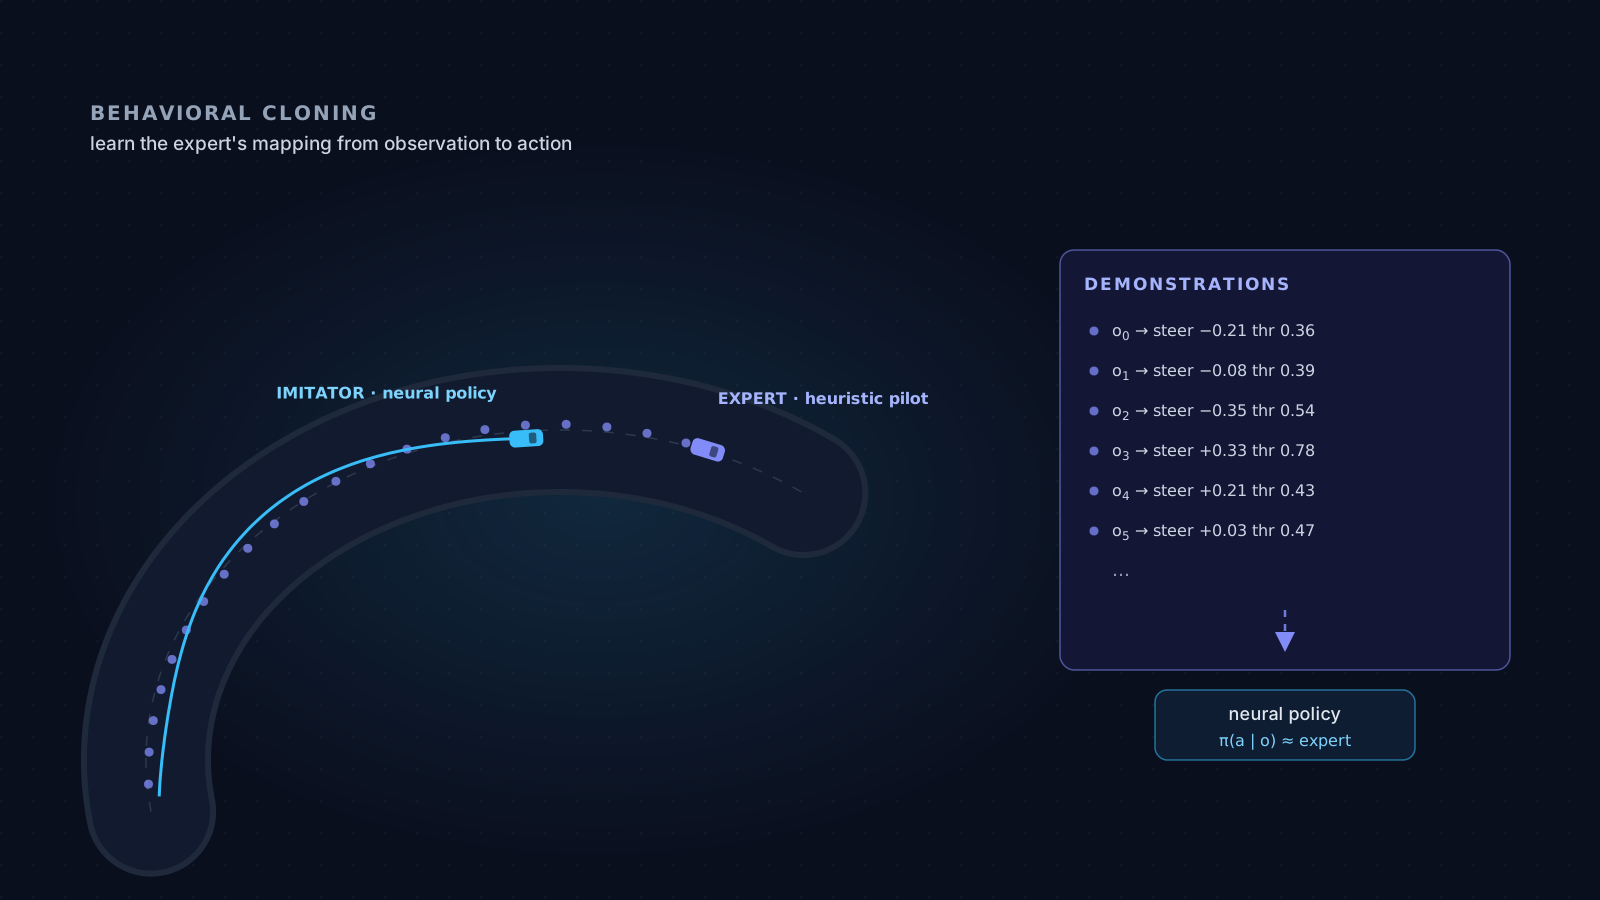
La idea es sencilla. ¿Qué pasaría si ya tenemos un piloto que sabe conducir? En lugar de obligar al agente a descubrir desde cero qué debe hacer, podemos observar al piloto y registrar sus decisiones:
observación → acción
observación → acción
observación → acción
...
Y después entrenar una red neuronal para que aprenda esa relación. Eso es Behavioral Cloning (BC):
En lugar de aprender únicamente por prueba y error, podemos aprender imitando ejemplos de comportamiento.
Una advertencia honesta, como en las partes anteriores
En Agentic Racing, BC se preparó pero nunca se ejecutó. El proyecto tiene un experto (el piloto heurístico que hoy maneja los autos del demo), un grabador de demostraciones y llegó a tener una configuración de entrenamiento con BC. Pero la bitácora del proyecto no registra que se haya grabado nunca una demostración, y la última corrida de entrenamiento se hizo con PPO limpio.
Se quedó en el camino por dos razones. La primera es, en sí misma, una buena lección sobre imitación: cada vez que el plan era “grabar demostraciones”, aparecía un defecto en el experto o en el entorno que hacía que valiera la pena arreglar eso primero. El profesor tenía que aprender a manejar antes de poder enseñar. La segunda fue una decisión deliberada: con el agarre lateral ya corregido y las pistas suavizadas, la octava corrida se hizo con PPO limpio, sin imitación, para saber si el algoritmo por sí solo alcanzaba (lo contamos en la sección 10 de la parte 2). No alcanzó, y poco después el proyecto dejó de lado el piloto RL; BC no volvió a intentarse.
Así que en este artículo los conceptos de BC van acompañados de lo que el repositorio realmente tiene, de lo que no, y de qué habría pasado si se hubiera usado con ese experto concreto.
1. De reinforcement learning a imitation learning
En PPO, el ciclo fundamental es el de la parte 1:
observación
     ↓
   policy
     ↓
   acción
     ↓
  entorno
     ↓
 recompensa
     ↓
 aprendizaje
     ↺
El agente tiene que descubrir progresivamente qué acciones producen buenos resultados.
En Behavioral Cloning cambiamos el problema. Tenemos un experto y registramos lo que hace:
                 EXPERTO
                    │
                    ▼
             DEMOSTRACIONES
                    │
                    ▼
                 DATASET
                    │
                    ▼
              NEURAL POLICY
Podemos expresarlo como:
La policy intenta reproducir el comportamiento del experto. Ya no le decimos:
“Descubre cuál es la mejor acción.”
Le decimos:
“Cuando veas algo parecido a lo que vio el experto, haz lo que hizo.”
Fíjate en lo que desaparece: la recompensa. BC no la usa. No sabe si el experto conducía bien o mal; solo sabe qué hizo.
2. ¿Qué es exactamente una demostración?
Una demostración es una secuencia de experiencias producidas por el experto:
t = 0   observación → [...]   acción → [...]
t = 1   observación → [...]   acción → [...]
t = 2   observación → [...]   acción → [...]
Cada paso contiene un par:
donde es la observación y es la acción que tomó el experto.
Una demostración no es un video. Un video muestra qué hizo el piloto; una demostración para aprendizaje contiene exactamente los datos que la policy va a recibir y producir, para poder relacionar observación con acción.
En Unity ML-Agents, las demostraciones se graban con el componente DemonstrationRecorder, que
guarda en un archivo .demo las observaciones del agente y las acciones que tomó en cada decisión
(en nuestro caso, 10 veces por segundo).
En Agentic Racing, el evaluador del proyecto tiene un modo pensado para esto:
eval.exe -recordEse modo hace tres cosas: conduce todos los autos con el piloto heurístico, le agrega un
DemonstrationRecorder a cada uno y corre 300 segundos, escribiendo un archivo .demo por auto. Como
el grabador está en el mismo agente que se entrena, cada demostración contiene los mismos 42
números de observación y las mismas 3 acciones continuas que vimos en la parte 1. Experto y policy
hablan exactamente el mismo idioma.
Lo que no sabemos es si alguna vez se generó un archivo .demo. Son datos, así que están excluidos
de git a propósito, y la bitácora del proyecto no registra que se haya ejecutado una grabación.
3. El experto no tiene que ser humano
Cuando pensamos en imitación, solemos imaginar a una persona conduciendo. No tiene por qué ser así. El experto puede ser una persona, un controlador tradicional, un sistema de reglas, una policy ya entrenada u otro agente.
En Agentic Racing, el experto natural es el piloto heurístico, RaceAgent.Heuristic(): el mismo
controlador escrito a mano que hoy maneja los autos del demo, y cuya versión simplificada vimos en la
sección 17 de la parte 1. En cada paso:
- mira la curva más cerrada en los próximos 60 metros y calcula una velocidad objetivo;
- acelera si va por debajo, frena si va claramente por encima;
- apunta el volante a un punto intermedio entre la trazada ideal y el centro de la pista (más cerca de uno u otro según la directiva), entre 12 y 36 metros por delante según la velocidad.
Y produce sus acciones exactamente en el mismo formato que la policy: steer y throttle entre −1
y 1, brake entre 0 y 1.
             Piloto heurístico
                    │
                    ▼
             demostraciones
                    │
                    ▼
          Behavioral Cloning
                    │
                    ▼
              Neural Policy
Un detalle que hace a este experto especialmente interesante: su comportamiento cambia con la directiva del estratega. Más agresividad significa una velocidad objetivo más alta y frenar más tarde; las directivas más conservadoras lo acercan al centro. Al grabar sin forzar una directiva, el evaluador le asigna una al azar en cada episodio, igual que en el entrenamiento. Así que unas demostraciones grabadas hoy con él no solo enseñarían a conducir: enseñarían a conducir distinto según la directiva, que era justo lo que los seis canales de directiva de la observación necesitaban aprender.
Con un matiz de fechas: cuando se preparó la configuración de BC, la directiva todavía no estaba conectada al piloto heurístico; eso se hizo un día después. Unas demostraciones grabadas en ese momento le habrían enseñado a la policy justo lo contrario: a ignorar los canales de directiva.
Que el repositorio tenga un experto no significa que exista un pipeline de BC ejecutado. Este es el estado real:
| Pieza | ¿Existe? | Dónde |
|---|---|---|
| Experto | Sí | RaceAgent.Heuristic(), en RaceAgent.cs |
| Grabador de demostraciones | Sí | eval.exe -record, en EvalRunner.cs |
| Instrucciones de grabación y entrenamiento | Sí, pero desactualizadas | training/README.md, sección 6 (dice que la configuración trae los bloques de BC y GAIL; ya no los trae) |
| Configuración con BC y GAIL | Existió | se agregó para la octava corrida y se quitó antes de lanzarla |
Archivos .demo | Ninguno registrado | la bitácora no registra una grabación; son datos y no se versionan |
| Una corrida con BC | No | la octava corrida se hizo con PPO limpio |
| Resultados de BC | No | no hay métricas que comparar |
4. BC convierte la imitación en aprendizaje supervisado
Supongamos que tenemos un conjunto de demostraciones:
Cada ejemplo contiene una observación y la acción que tomó el experto. Queremos entrenar una red neuronal para que:
(Aquí escribimos como la acción que produce la policy, para simplificar; en realidad, como vimos en la parte 1, la policy produce una distribución y la acción se muestrea de ella.)
El proceso es aprendizaje supervisado tradicional:
observación
     │
     ▼
red neuronal
     │
     ▼
acción predicha
     │
     ▼
comparar con el experto
     │
     ▼
loss
     │
     ▼
backpropagation
     │
     ▼
actualizar θ
La diferencia está en qué representa el dataset. En un problema clásico tendríamos imagen → gato.
Aquí tenemos observación del entorno → acción del experto.
5. ¿Qué loss utiliza Behavioral Cloning?
Depende del espacio de acciones.
Acciones continuas. Si el experto produce valores como:
steer    = -0.35
throttle =  0.72
brake    =  0.00
la formulación más común penaliza la distancia entre la acción del experto y la de la policy (hasta un factor constante, según cómo se promedie sobre las dimensiones de la acción):
Acciones discretas. Si las acciones fueran categorías (IZQUIERDA, RECTO, DERECHA), el
problema es de clasificación y se usa una pérdida como cross-entropy.
ML-Agents 1.1.0 hace exactamente eso: error cuadrático medio para las acciones continuas y
cross-entropy para las discretas. Para las continuas compara la acción que muestrea la policy de
su distribución con la acción del experto. Eso tiene un efecto secundario interesante: como el ruido
del muestreo también aumenta el error, BC no solo acerca la media de la policy a la del experto,
también reduce su dispersión, es decir, cuánto explora. TensorBoard la muestra como
Losses/Pretraining Loss.
En nuestro auto, con tres acciones continuas, sería el error cuadrático medio sobre steer,
throttle y brake.
La idea importante:
La policy recibe una observación y es penalizada cuando su acción se aleja de la que tomó el experto.
6. Entrenar al imitador
El ciclo básico es:
- tomar un lote de demostraciones;
- pasar las observaciones por la policy;
- obtener las acciones predichas;
- compararlas con las del experto;
- calcular la loss;
- hacer backpropagation;
- actualizar los parámetros;
- repetir.
La ventaja frente a RL desde cero es enorme. El agente no tiene que descubrir por accidente cómo tomar una curva: le mostramos cómo. Es como enseñarle a un alumno: “cuando estés en esta situación, yo haría esto”.
En ML-Agents hay un detalle de implementación que cambia cómo conviene pensarlo. BC no es una fase
previa separada del entrenamiento con PPO. Corre dentro del mismo entrenamiento: después de cada
actualización de PPO, la policy recibe también una actualización de BC, que por defecto da varias
pasadas por las demostraciones en minibatches, con su propio optimizador. Esa actualización usa una
tasa de aprendizaje igual a la tasa inicial de PPO multiplicada por strength, que decae
linealmente hasta casi cero durante los primeros steps pasos.
La configuración que llegó a escribirse para la octava corrida de Agentic Racing usaba
strength: 0.5 y steps: 2000000. Es decir, BC habría empujado con fuerza al principio y se habría
ido apagando durante los primeros 2 millones de pasos, de una corrida de 10 millones, para dejar el
resto en manos de PPO.
7. Entonces… ¿hemos resuelto el problema?
No. Aquí aparece la limitación más importante de Behavioral Cloning.
Imaginemos que el experto conduce siempre cerca del centro de la pista:
────────────────────────────────
             🚗
              ↓
       trayectoria experta
────────────────────────────────
La policy aprende principalmente esos estados. Pero al ejecutarse puede cometer un pequeño error:
────────────────────────────────
               🚗
                ↘
                 ↘
────────────────────────────────
Ahora el auto está en un estado que quizá nunca apareció en las demostraciones, y la policy tiene que decidir qué hacer. Si tampoco sabe recuperarse:
pequeño error
     ↓
estado no visto
     ↓
acción incorrecta
     ↓
error mayor
     ↓
otro estado no visto
     ↓
...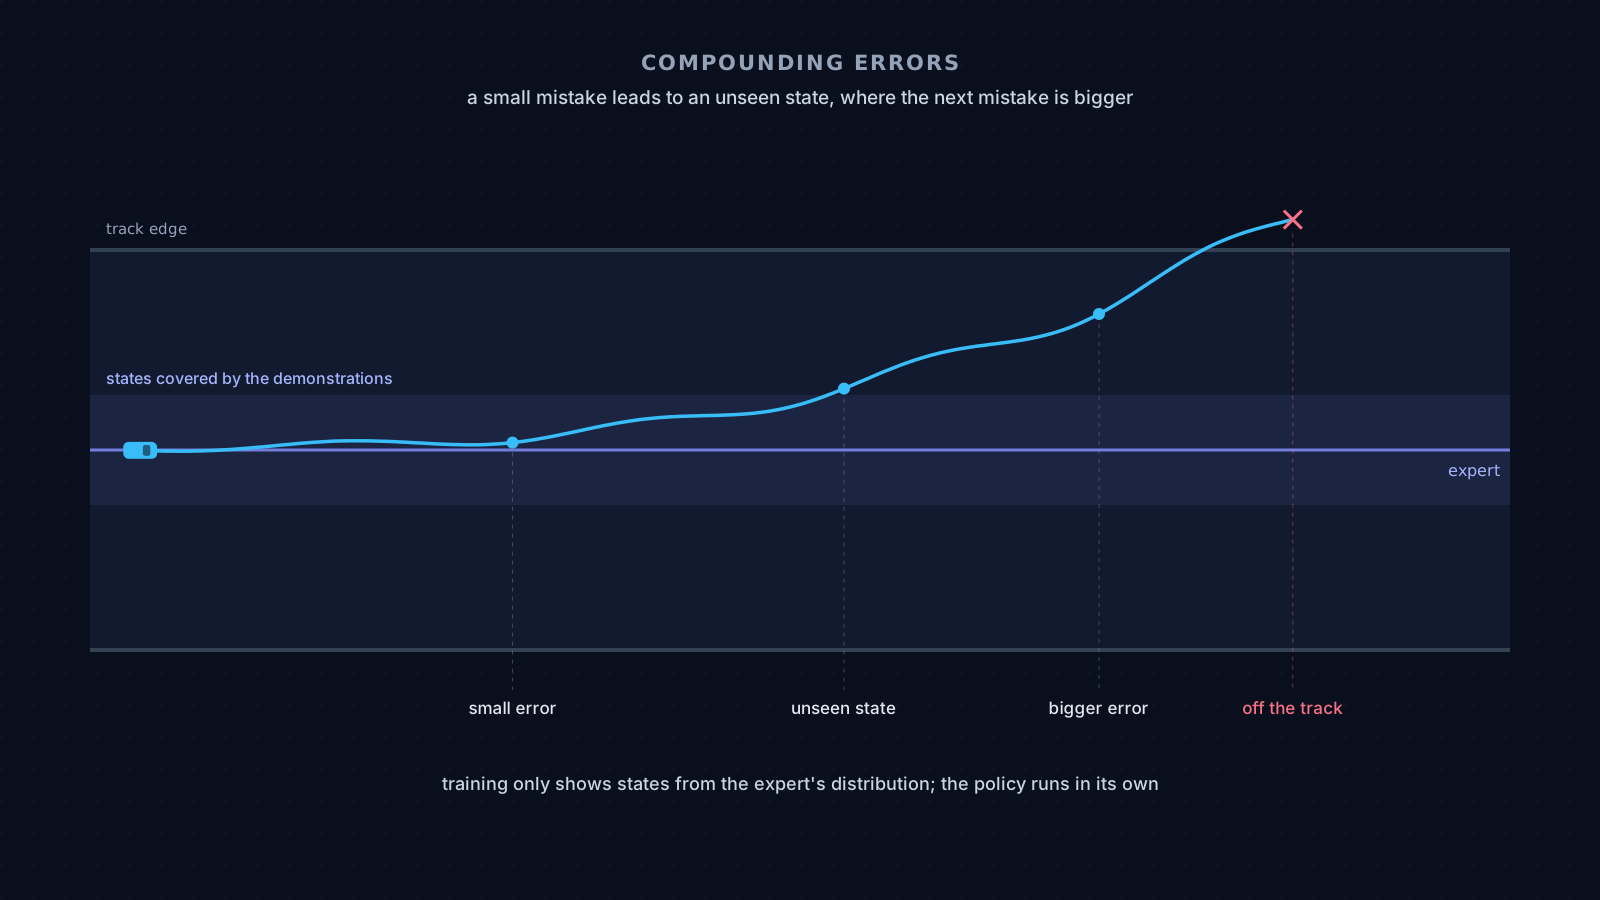
Este fenómeno se conoce como covariate shift y como errores acumulativos (compounding errors).
8. El experto y la policy visitan distribuciones distintas
Durante el entrenamiento, la policy ve estados visitados por el experto:
Pero cuando la ejecutamos, visita los estados a los que la llevan sus propias decisiones:
Y no hay ninguna garantía de que:
Al principio pueden parecerse. Después de un pequeño error, empiezan a separarse. El experto nunca tuvo que demostrar qué hacer en una situación muy mala, porque el experto no suele llegar ahí. La policy, en cambio, sí puede llegar.
El análisis clásico de Ross y Bagnell lo pone en números: si el imitador se equivoca con probabilidad en los estados del experto, en una tarea de pasos su desempeño puede alejarse del del experto en una cantidad que crece con , no con . Cada error no solo cuesta lo suyo: además lleva al imitador a estados donde se va a equivocar más. En las ocho corridas de Agentic Racing, un episodio de entrenamiento podía durar hasta 800 decisiones.
Por eso podemos tener:
un resultado excelente sobre el dataset y una mala policy durante la ejecución.
9. Un ejemplo con nuestro coche
En Agentic Racing este problema no es hipotético: está escrito en la propia configuración.
Las demostraciones empezarían siempre en el mejor estado posible. El modo de grabación activa la
opción CleanSpawn del evaluador: cada auto aparece sobre la línea central, perfectamente alineado
con la pista y ya a 14 m/s. En cambio, durante el entrenamiento cada episodio empieza con ruido a
propósito: hasta ±10° de rumbo, hasta ±2 m de desplazamiento lateral y a 8 m/s. Desde el primer
paso, la policy entrenada visitaría estados que las demostraciones nunca muestran.
El experto tiene sus zonas preferidas. Una de las observaciones es el desplazamiento lateral del auto respecto del centro, dividido por la mitad del ancho de la pista: 0 es el centro, y −1 y +1 son los bordes. El piloto heurístico apunta a un punto entre la trazada ideal y el centro, y además corrige hacia el centro, así que en las rectas y con las directivas conservadoras sus demostraciones se concentrarían cerca de 0; en las curvas y con las directivas agresivas, más hacia la trazada. Nadie midió esa distribución, pero hay algo que el código sí deja claro: el experto no tiene ninguna razón para pasar tiempo pegado al muro equivocado o cruzado en la pista. Si la policy llega ahí, tiene que extrapolar, y extrapolar fuera de la distribución de entrenamiento es mucho más difícil que interpolar dentro de ella.
El propio experto era frágil fuera de su estado nominal. En una versión anterior, aparecer sobre la trazada ideal en lugar de sobre el centro bastaba para que el piloto heurístico entrara en una oscilación y terminara en un trompo: su corrección hacia el centro era demasiado fuerte para ese punto de partida. Y el código del evaluador lo dice explícitamente: el arranque con ruido del entrenamiento detiene a la heurística antes de que llegue a estabilizarse en la línea, por eso el experto solo se evaluó y se grabaría desde arranques limpios. Un experto que no sabe recuperarse de una situación no puede enseñar a recuperarse de ella.
Y hoy habría un problema más: todas las arenas usan el mismo circuito fijo, así que las demostraciones cubrirían un único trazado.
Tener muchas demostraciones no significa tener una policy robusta. La cobertura importa tanto como la cantidad.
10. La calidad del experto también importa
BC aprende del experto, y eso incluye sus defectos. Si el experto frena de más, toma trayectorias ineficientes, comete errores o produce acciones ruidosas, BC puede aprender todo eso.
No necesariamente:
Agentic Racing tuvo un ejemplo muy concreto. Antes de grabar, se revisó con más detalle cómo manejaba el piloto heurístico en las pistas procedurales de entonces. Solo 2 o 3 de cada 9 autos manejaban bien; los demás se quedaban en un vaivén cerca del punto de partida: chocaban con el borde, hacían una reversa corta, volvían a frenarse y repetían, durante los 80 segundos del episodio, sin avanzar. La bitácora lo dice sin rodeos: esas trayectorias “llenarían las demos de basura”. La solución fue agregar un corte por falta de progreso (menos de 8 metros en 5 segundos termina el episodio), para que los autos atascados se reiniciaran en lugar de grabar minutos de un experto que no estaba conduciendo.
Fue la primera de varias veces en que grabar las demostraciones se pospuso porque el profesor todavía no estaba listo.
BC es imitación. No es, por sí mismo, un algoritmo cuyo objetivo sea superar al experto.
11. Entonces, ¿para qué sirve BC?
A pesar de esas limitaciones, BC puede ser muy útil, sobre todo como punto de partida:
                 Experto
                    │
                    ▼
             demostraciones
                    │
                    ▼
            Behavioral Cloning
                    │
                    ▼
             policy inicial
                    │
                    ▼
                  PPO
                    │
                    ▼
             policy mejorada
PPO ya no empieza desde cero: empieza con una policy que sabe hacer algo razonable. Y eso ataca directamente el problema de la parte 2. El agente no necesita encontrar por azar la secuencia frenar–girar–acelerar si alguien se la muestra. Basta con que BC la deje en una zona donde la policy la pruebe con frecuencia, para que PPO pueda reforzarla.
Por eso imitation learning y reinforcement learning se complementan.
12. BC + PPO: enseñar primero, optimizar después
Podemos pensar en dos profesores:
- El experto dice: “así es como yo conduzco”.
- El entorno dice: “esto es lo que realmente funciona para conseguir el objetivo”.
BC escucha al experto. PPO escucha la recompensa.
En ML-Agents, como vimos en la sección 6, los dos escuchan a la vez, con un volumen que cambia con el tiempo: el peso de BC empieza alto y se apaga, mientras PPO sigue durante todo el entrenamiento.
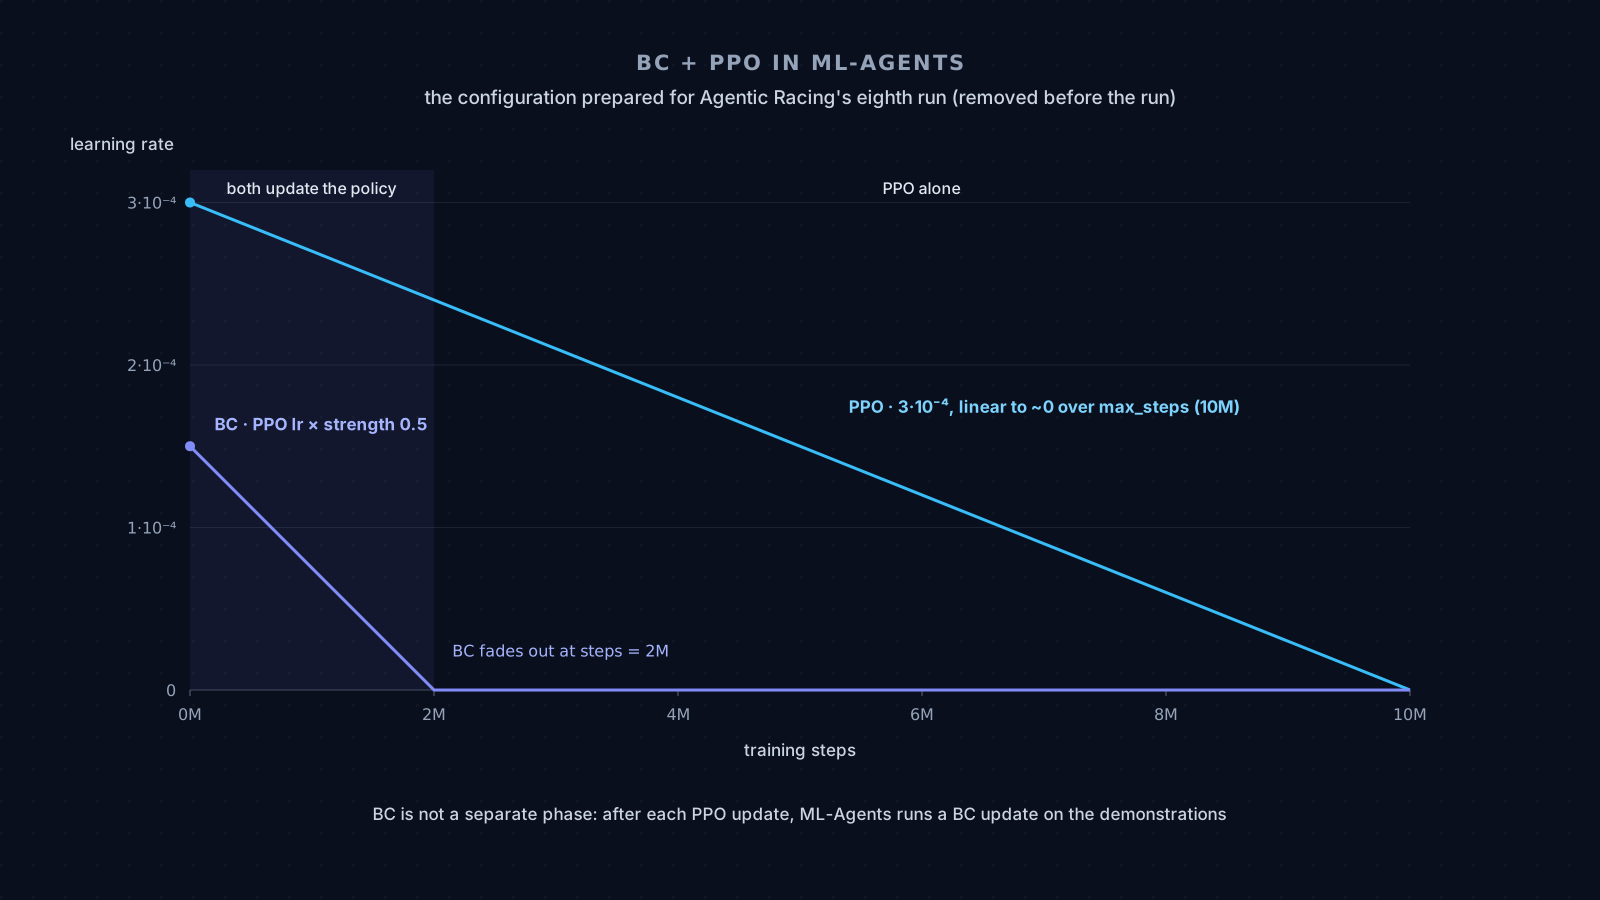
Es una forma suave de “enseñar primero, optimizar después”: no hay un corte entre las dos etapas, sino una transición. En Agentic Racing ese pipeline existió en la configuración, pero nunca se ejecutó.
13. ¿Y dónde entra GAIL?
BC intenta aprender directamente .
GAIL (Generative Adversarial Imitation Learning) plantea otra pregunta:
¿El comportamiento de mi agente se parece al del experto?
Entrena un discriminador que intenta distinguir entre experiencias del experto y experiencias del agente. El agente recibe una recompensa adicional cuando sus experiencias son difíciles de distinguir de las del experto. En ML-Agents, GAIL es literalmente eso: una señal de recompensa más, que se suma a la recompensa del entorno y que PPO optimiza como cualquier otra.
La configuración de la octava corrida también tenía un bloque de GAIL, con un peso de 0.15 y comparando acciones además de observaciones.
Así que cada técnica responde una pregunta distinta:
| Técnica | Pregunta principal |
|---|---|
| Behavioral Cloning | ¿Puedes hacer lo que hizo el experto en este estado? |
| GAIL | ¿Tu comportamiento se parece al del experto? |
| PPO | ¿Puedes maximizar la recompensa de la tarea? |
GAIL merece su propio artículo, y es la parte 4 de la serie.
14. El verdadero desafío: ¿qué estamos enseñando?
BC nos obliga a hacernos una pregunta más profunda:
¿La observación contiene suficiente información para tomar la decisión correcta?
Supongamos dos situaciones distintas:
situación A → el experto gira a la izquierda
situación B → el experto gira a la derecha
Si ambas producen exactamente la misma observación para la policy, el problema no es la red neuronal: la información simplemente no está. Y con una pérdida de error cuadrático, la policy no elige una de las dos respuestas: aprende el promedio, que puede ser no girar en absoluto.
Esto en Agentic Racing es concreto, porque el piloto heurístico no decide solo a partir de las 42 observaciones que recibiría la policy:
- Tiene memoria. Su volante pasa por un filtro de suavizado: cada comando mezcla el nuevo cálculo con el comando anterior. La policy de la parte 2 es una red sin memoria, que solo ve la observación actual.
- Usa temporizadores. Si el auto lleva un rato lento y contra el muro (el código lo cuenta como más de un segundo), el experto hace una reversa de 0.6 segundos para soltarse. Mismo estado visible, acciones distintas según cuánto tiempo lleve atascado. Para la policy, eso sería exactamente la situación A y B de arriba: a veces acelerar, a veces dar reversa, ante la misma observación.
- Mira la pista de otra forma. El experto busca la curva más cerrada en los próximos 60 metros y apunta a un punto concreto entre la trazada y el centro. La policy no hace ese escaneo: recibe tres números de curvatura (0–22, 18–45 y 40–75 metros por delante), los raycasts contra los muros y su relación con la trazada, pero no el punto exacto al que apunta el experto.
Nada de esto impide que BC funcione. Pero significa que la policy no podría reproducir al experto con exactitud, y que justamente en las maniobras de recuperación, donde el experto depende de su memoria, la imitación sería peor.
Esto conecta con la sección 3 de la parte 1: diseñar las observaciones también forma parte del problema. Un dataset gigantesco no puede compensar una observación que no contiene la información que usó el experto.
15. Las demostraciones también son un problema de ingeniería
Crear demostraciones no consiste en grabar muchas horas. Hay que preguntarse:
| Pregunta | En Agentic Racing |
|---|---|
| ¿El experto es realmente bueno? | En el circuito fijo, sí: completa vueltas enteras. En las pistas procedurales de entonces, no, aunque buena parte de la culpa era del entorno (curvas demasiado cerradas y un agarre lateral que frenaba el auto en cada giro). |
| ¿Cubre situaciones diferentes? | Sí en directivas (una al azar por episodio). No en trazados: hoy hay un solo circuito. |
| ¿Hay curvas fáciles y difíciles? | El circuito fijo tiene cuatro curvas, todas del mismo radio. |
| ¿Hay situaciones de recuperación? | Casi no: las grabaciones empiezan centradas y alineadas, y el experto no suele meterse en situaciones de las que tenga que salir. |
| ¿Hay acciones inconsistentes? | Sí: las que dependen de la memoria y los temporizadores del experto. |
| ¿Los estados se parecen a los que verá la policy? | No del todo: el entrenamiento empieza con ruido de rumbo y de posición que la grabación no tiene. |
Si todas las demostraciones son perfectas, quizá enseñemos muy bien a conducir perfectamente, pero no a recuperarse cuando algo sale mal. Para conducción, las demostraciones de recuperación pueden ser tan importantes como las ideales.
Hay un precedente famoso. ALVINN, uno de los primeros vehículos que aprendió a conducirse con una red neuronal (Pomerleau, 1989), terminó entrenándose imitando a un conductor humano. Para que aprendiera a corregir, Pomerleau (1991) generaba además imágenes desplazadas y rotadas, como si el vehículo estuviera corrido hacia un lado, con la corrección que habría hecho falta. Fabricaba los ejemplos de recuperación que el conductor nunca había necesitado mostrar.
16. ¿Qué deberíamos medir?
No conviene evaluar BC solo por su loss. Una policy puede tener un error de imitación muy pequeño y aun así conducir mal.
Métricas de imitación:
- la pérdida de BC (
Losses/Pretraining Lossen ML-Agents); - el error por componente de la acción:
steer,throttleybrakepor separado.
Métricas de comportamiento:
- fracción de vuelta completada;
- vueltas completadas y tiempo por vuelta;
- motivo por el que termina cada episodio (salida de pista, auto detenido, sin progreso);
- velocidad y uso del freno.
Agentic Racing ya tiene casi todas las de comportamiento: son las que reporta su evaluador, el mismo que en la parte 2 mostró que la recompensa media subía mientras la fracción de vuelta no se movía.
Un loss bajo no garantiza una buena policy. Lo que queremos medir es el comportamiento fuera del dataset.
17. El experimento que vale la pena hacer
Para Agentic Racing, la comparación interesante sería:
PPO desde cero                    demostraciones → BC + PPO
      │                                       │
      ▼                                       ▼
  resultado A                             resultado B
comparando la fracción de vuelta, las vueltas completadas, las salidas de pista, la estabilidad y cuántos pasos hace falta para llegar a cada nivel, y probando después ante situaciones que no estaban en las demostraciones.
Entonces la pregunta deja de ser “¿BC funciona?” y pasa a ser:
¿Cuánto facilita el aprendizaje empezar con una policy que ya sabe imitar un comportamiento razonable?
Este experimento no se hizo. Hoy sería más fácil de hacer que en su momento: en el circuito fijo, donde la pista ya no es un obstáculo, el experto completa vueltas, y el grabador y el evaluador existen. Faltaría volver a agregar los bloques de BC a la configuración, que las instrucciones dan por presentes. Queda pendiente.
18. DAgger: enseñar también a recuperarse
La solución clásica al covariate shift es DAgger (Dataset Aggregation), de Ross, Gordon y Bagnell:
- entrenar con las demostraciones iniciales;
- ejecutar la policy;
- registrar los estados que la policy visita;
- preguntarle al experto qué habría hecho en cada uno;
- agregar esos ejemplos al dataset;
- volver a entrenar;
- repetir.
demostraciones iniciales
          │
          ▼
         BC
          │
          ▼
       policy
          │
          ▼
    ejecutar policy
          │
          ▼
 estados fuera de distribución
          │
          ▼
   consultar al experto
          │
          ▼
    nuevos ejemplos ──────► BC
DAgger es interesante porque el experto enseña justo en las situaciones donde la policy tiene problemas.
Con un experto humano, DAgger es caro: alguien tiene que etiquetar miles de estados. Con un experto que es un programa, como el piloto heurístico de Agentic Racing, es mucho más barato: basta con correr la heurística “en la sombra” junto a la policy, en los mismos estados que la policy visita, y guardar qué habría hecho. Tiene que correr a la par y no como una consulta suelta, porque, como vimos en la sección 14, la heurística tiene memoria. ML-Agents no trae DAgger incluido, así que habría que construirlo. Tampoco se hizo, pero es probablemente la mejor respuesta a los problemas de las secciones 9 y 15.
19. BC no reemplaza al reinforcement learning
BC puede funcionar muy bien cuando hay buenas demostraciones, el problema está bien cubierto y la policy no necesita alejarse mucho de los ejemplos.
Pero si queremos que el agente descubra mejores estrategias, supere al experto, se adapte a situaciones nuevas u optimice una recompensa específica, necesitamos algo más. En el caso de Agentic Racing, superar al experto no es un detalle: el piloto heurístico frena según una regla fija, y un agente que aprendiera de la recompensa podría encontrar algo mejor.
Experto
   │
   ▼
Demostraciones
   │
   ▼
Behavioral Cloning ──► policy inicial
                           │
                           ├──► GAIL: ¿se parece al experto?
                           │
                           ▼
                          PPO: ¿maximiza la recompensa?
                           │
                           ▼
                    policy optimizada
En ML-Agents, las tres piezas pueden combinarse en una sola corrida, que es lo que preparaba la configuración de la octava corrida. Esa secuencia es una propuesta para Agentic Racing, no algo que se haya ejecutado.
Conclusión: sí, podemos enseñar imitando
Behavioral Cloning transforma una parte del problema. En lugar de decir “explora hasta descubrir qué funciona”, decimos “mira estos ejemplos y aprende a comportarte como el experto”. Eso puede ser muy poderoso.
Pero tiene una debilidad fundamental: el agente puede encontrarse con situaciones que nunca aparecieron en las demostraciones. Un pequeño error lo saca de la distribución del experto, ese error genera otro, y ese otro genera otro.
Agentic Racing agrega una segunda lección, menos obvia: imitar exige un experto confiable y una observación que contenga lo que el experto usa para decidir. El proyecto tenía un experto, un grabador y una configuración, pero cada vez que iba a grabar descubría algo que arreglar: un experto que se atascaba, pistas que nadie podía recorrer, una física que convertía cada giro en un frenazo. Y aun con todo arreglado, ese experto decide con memoria y temporizadores que la policy no podría ver.
Para Agentic Racing, la pregunta interesante no es solo si podemos enseñar imitando, sino:
¿Podemos usar la imitación como punto de partida y después conseguir que el agente supere las limitaciones de sus demostraciones?
Ahí es donde Behavioral Cloning se conecta con GAIL y con PPO.
Siguiente en la serie: la parte 4, “¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero”.
Si llegaste directo a este artículo, la parte 1 explica los conceptos base, la parte 2 abre PPO por dentro, y Agentic Racing: un piloto que nunca aprendió a manejar cuenta la historia completa del proyecto.
Referencias
- Pomerleau, D. (1989). ALVINN: An Autonomous Land Vehicle in a Neural Network. Advances in Neural Information Processing Systems 1.
- Pomerleau, D. (1991). Efficient Training of Artificial Neural Networks for Autonomous Navigation. Neural Computation, 3(1).
- Ross, S. y Bagnell, J. A. (2010). Efficient Reductions for Imitation Learning. AISTATS.
- Ross, S., Gordon, G. y Bagnell, J. A. (2011). A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS.
- Ho, J. y Ermon, S. (2016). Generative Adversarial Imitation Learning. NeurIPS.
- Unity Technologies. Unity ML-Agents Toolkit, en
particular el módulo de BC (
ml-agents/mlagents/trainers/torch_entities/components/bc/module.py) y la recompensa de GAIL (.../reward_providers/gail_reward_provider.py) del release demlagents1.1.0. - El experto (
RaceAgent.cs), el grabador (EvalRunner.cs), las instrucciones de imitación (training/README.md) y la bitácora del proyecto están en github.com/alulema/agentic-racing.