Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero (este artículo)
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema
Dónde nos quedamos
La parte 3 hizo una pregunta sencilla: ¿podemos enseñar a un agente imitando a un experto? La respuesta fue sí. Con Behavioral Cloning (BC) recogemos ejemplos y entrenamos una policy para que:
Pero apareció un problema: si el agente llega a un estado que no estaba en las demostraciones, puede no saber qué hacer, y cada error lo lleva a estados donde se equivoca más. Y en Agentic Racing apareció otro: el experto, el piloto heurístico del proyecto, decide con memoria y temporizadores que la policy no ve, así que hay situaciones en las que ninguna red sin memoria puede copiar su acción exacta.
Eso abre una pregunta más interesante:
¿Realmente necesitamos decirle al agente qué acción tomar en cada estado?
Quizá podamos enseñarle algo distinto:
“Quiero que tu comportamiento se parezca al del experto.”
Esa es la idea de Generative Adversarial Imitation Learning (GAIL), que la parte 3 dejó anunciada como la siguiente parada de la serie.
Una advertencia honesta, como en las partes anteriores
En Agentic Racing, GAIL corrió la misma suerte que BC: se configuró pero nunca se ejecutó. La configuración que se preparó para la octava corrida tenía un bloque de GAIL junto al de BC; se quitó antes de lanzarla, y esa corrida se hizo con PPO limpio. La bitácora no registra ninguna demostración grabada, así que tampoco hay discriminador entrenado, ni métricas de GAIL, ni comparación entre BC y GAIL que mostrar.
Lo que sí hay es suficiente para hacer este artículo concreto: el experto, el grabador de demostraciones, la configuración que se escribió y el código de ML-Agents que la habría ejecutado. Así que, como en la parte 3, la teoría va acompañada de lo que el proyecto realmente tenía y de lo que habría pasado con ello. Las tablas de resultados de este artículo son experimentos propuestos, no resultados.
1. De copiar acciones a imitar comportamientos
Behavioral Cloning puede verse así:
       observación
            │
            ▼
   ¿qué hizo el experto?
            │
            ▼
    acción del experto
            │
            ▼
        entrenar π
Por ejemplo:
observación:
curva a la derecha
velocidad alta
auto ligeramente desplazado

             ↓

experto:
steer    = 0.45
throttle = 0.30
brake    = 0.10
BC intenta aprender esa correspondencia. GAIL plantea otra pregunta:
¿El comportamiento que produce nuestro agente se parece al del experto?
Y para responderla introduce un componente nuevo: un discriminador.
2. La idea del discriminador
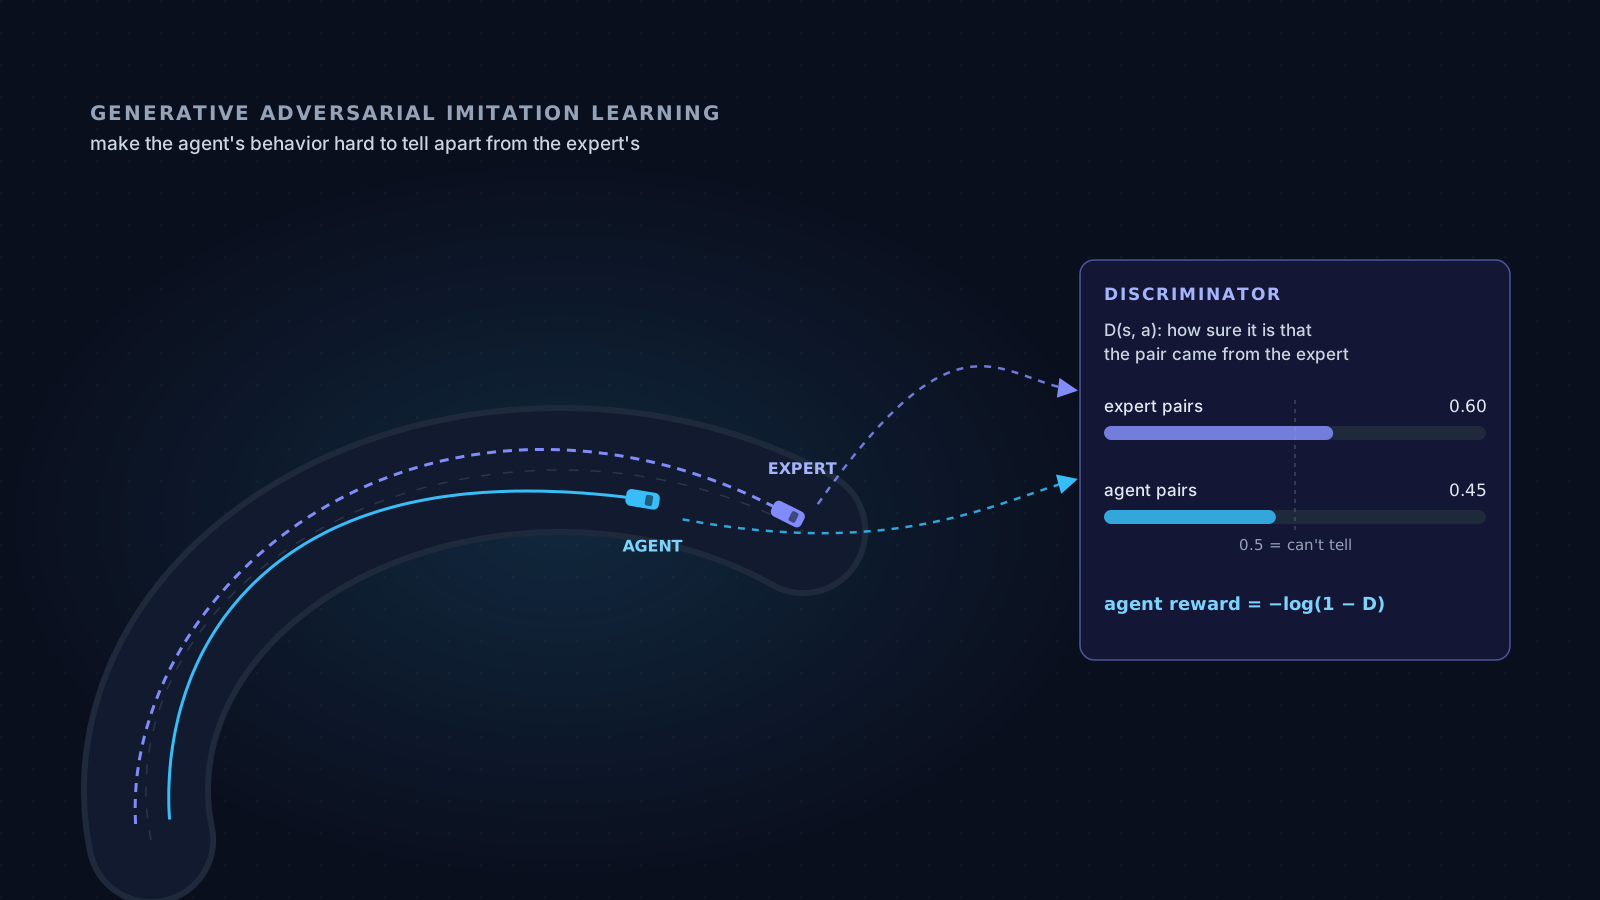
Imaginemos dos conductores, el experto y el agente, y un juez que mira lo que hace cada uno:
        EXPERTO                 AGENTE
           │                       │
     comportamiento          comportamiento
           │                       │
           └──────────┬────────────┘
                      ▼
              ┌───────────────┐
              │ Discriminador │
              └───────┬───────┘
                      ▼
          ¿del experto o del agente?
El discriminador intenta distinguir el comportamiento del experto del comportamiento del agente. Si recibe una experiencia del experto, debería responder “experto”; si recibe una del agente, “agente”.
La parte interesante es que el agente también está aprendiendo, y su objetivo es que esa clasificación sea cada vez más difícil. Tenemos un juego:
Discriminador: "quiero distinguirlos".
Agente:        "quiero que no puedas distinguirme del experto".
3. ¿Por qué esto recuerda a una GAN?
El nombre no es casualidad. GAIL está inspirado en las Generative Adversarial Networks (GANs). En una GAN, simplificando:
generador ──► datos generados ──► discriminador ──► ¿real o generado?El generador intenta producir datos que parezcan reales, y el discriminador intenta distinguir lo real de lo generado.
GAIL hace algo parecido, con una diferencia fundamental:
En GAIL, el “generador” no genera imágenes ni vectores directamente. La policy genera comportamiento interactuando con el entorno.
La policy no produce una muestra aislada. Produce una secuencia:
y los estados de esa secuencia no los elige ella: los produce la física del entorno a partir de sus acciones. Esa es la razón por la que GAIL no se puede entrenar como una GAN normal, derivando a través del generador. Necesita reinforcement learning.
4. Importa el comportamiento, no una acción aislada
BC trabaja con la correspondencia . GAIL trabaja con pares , pero mirados como una distribución: con qué frecuencia la policy visita cada estado y qué acciones toma ahí.
Imaginemos un tramo de pista:
experto: frena 0.30 → gira 0.42 → acelera 0.70 → corrige −0.05
agente:  frena 0.28 → gira 0.45 → acelera 0.66 → corrige −0.08
Ninguna acción del agente es igual a la del experto, pero el comportamiento es casi el mismo: frena, gira, acelera y corrige en los mismos lugares y con magnitudes parecidas. BC penalizaría cada una de esas pequeñas diferencias. Un discriminador, si son diferencias del tamaño de la variación normal del experto, no tendría cómo usarlas para distinguirlos.
Eso es lo que GAIL intenta capturar.
5. Una intuición con Agentic Racing
El circuito de Agentic Racing hoy es un rectángulo de esquinas redondeadas de unos 2 km, con cuatro curvas iguales. El experto, el piloto heurístico de la parte 3, lo recorre vuelta tras vuelta. Cada vuelta deja una trayectoria:
donde cada son los mismos 42 números de observación que recibe la policy (los de la parte 1) y
cada son las mismas tres acciones continuas: steer, throttle y brake.
Ahora dejamos conducir al agente, que produce sus propias trayectorias . GAIL entrena un discriminador para distinguir los pares de una y otra.
Al principio es fácil: el agente recién inicializado zigzaguea, frena en las rectas o acelera en las curvas, y el discriminador lo detecta enseguida. A medida que la policy mejora, sus pares se parecen cada vez más a los del experto, y el discriminador empieza a dudar. El objetivo es llegar a un punto en que el discriminador tenga dificultades para diferenciarlos.
6. El discriminador
Formalmente, el discriminador es una función:
donde es el estado, la acción y los parámetros de una red neuronal. Su salida se interpreta como la probabilidad de que el par venga del experto.
Por ejemplo, al principio del entrenamiento:
D(par del experto) = 0.95
D(par del agente)  = 0.08
El discriminador está muy seguro. Más adelante:
D(par del experto) = 0.60
D(par del agente)  = 0.45
La distinción se vuelve más difícil.
En ML-Agents 1.1.0, el discriminador es una red densa que recibe la observación y, si la opción
use_actions está activa, también la acción y una marca que indica si el episodio terminó en ese
paso. Por defecto tiene 2 capas de 128 neuronas y una salida con función sigmoide, que es la
probabilidad anterior. La configuración que se preparó para Agentic Racing activaba use_actions, así
que el discriminador habría comparado pares observación–acción completos.
7. El objetivo del discriminador
El discriminador se entrena como un clasificador binario:
donde es el comportamiento del experto y el del agente:
pares del experto ──► D debería dar valores altos
pares del agente  ──► D debería dar valores bajos
En ML-Agents, la pérdida del discriminador es esa expresión con el signo cambiado (salvo un pequeño margen numérico dentro de los logaritmos). Además, le suma una penalización de gradiente con peso 10: evalúa el discriminador en puntos intermedios entre pares del experto y del agente, y castiga que la norma de su gradiente respecto de la entrada se aleje de 1. Es una técnica tomada de las GANs (Gulrajani et al., 2017) para que el discriminador no se vuelva tan tajante que deje de dar una señal útil. El propio código explica para qué está: “agrega estabilidad, sobre todo off-policy” (PPO es on-policy, así que aquí es una protección más que una necesidad).
Pero lo importante es que la policy también aprende.
8. ¿Qué quiere conseguir la policy?
La policy quiere generar comportamiento que parezca del experto:
discriminador ──► "esto parece del agente" ──► señal ──► policy
      ▲                                                     │
      │                                                     ▼
      └──────────────── nuevo comportamiento ◄──────────────┘
La policy cambia, el comportamiento cambia, el discriminador vuelve a entrenarse con ese nuevo comportamiento, y el proceso continúa. Es un juego adversarial.
9. El ciclo de aprendizaje
El ciclo completo es:
- el agente interactúa con el entorno;
- genera trayectorias;
- el discriminador evalúa esos pares;
- su salida se convierte en una recompensa;
- la policy se actualiza con esa recompensa;
- el discriminador se actualiza para distinguir mejor;
- el agente vuelve a interactuar.
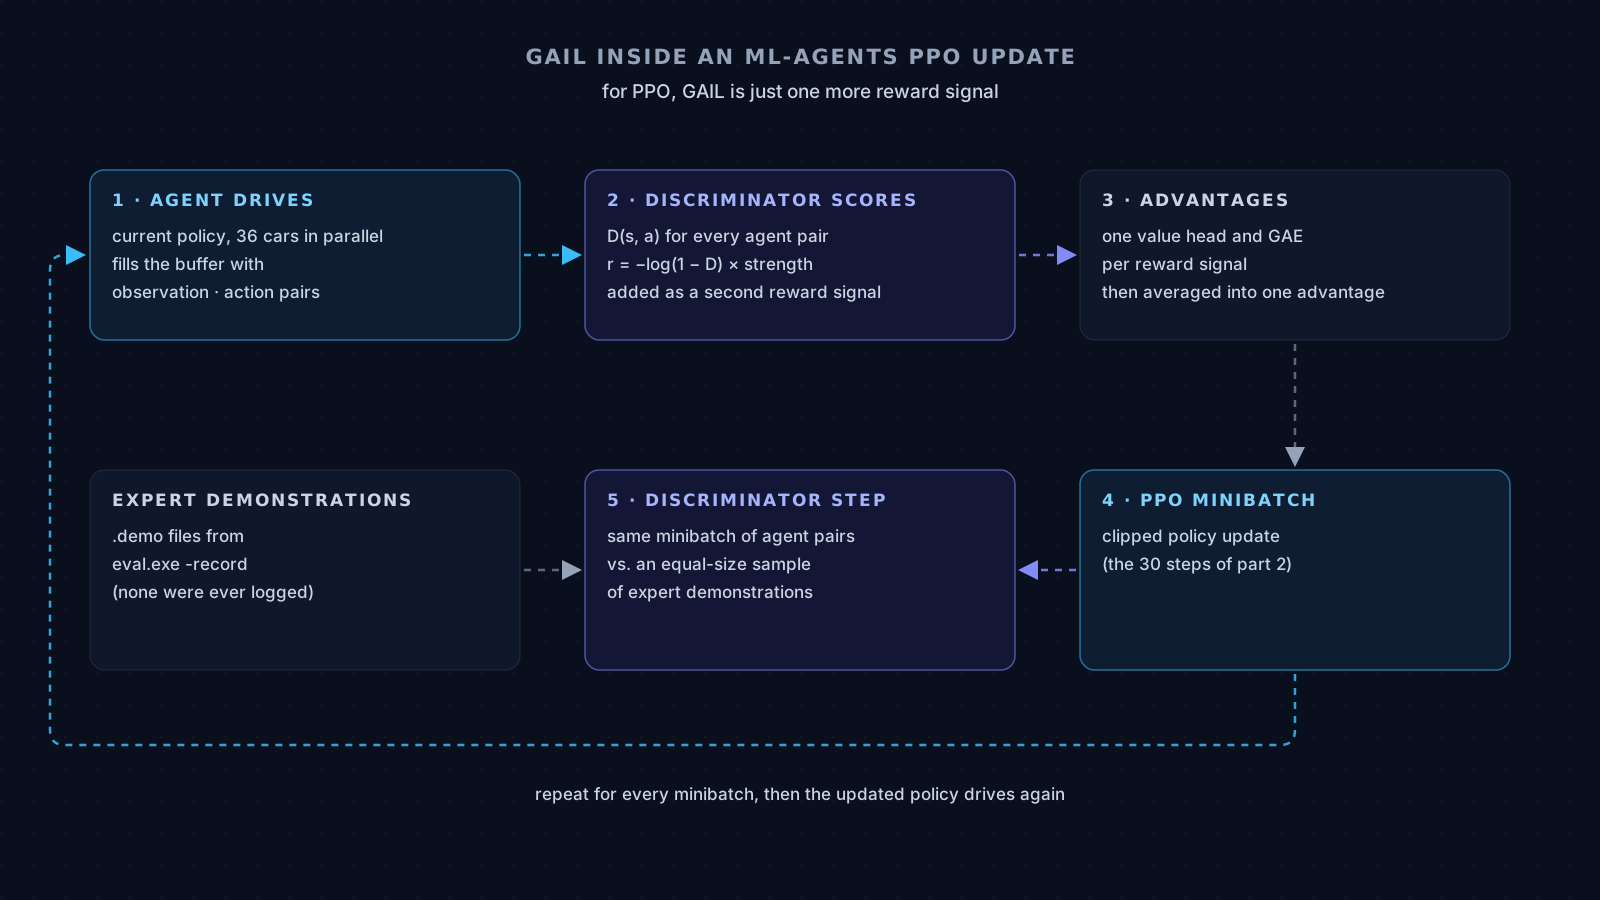
En ML-Agents, los pasos 5 y 6 ocurren entrelazados. En cada minibatch de la actualización de PPO (los 30 de la parte 2), primero se actualiza la policy y después el discriminador da un paso con ese mismo minibatch de experiencias del agente y una muestra del mismo tamaño de las demostraciones. Policy y discriminador avanzan a la par.
10. GAIL sigue siendo reinforcement learning
Esta distinción es importante: GAIL no reemplaza al reinforcement learning. Lo que cambia es la fuente de la señal de aprendizaje.
En RL tradicional:
entorno ──► recompensa ──► policyEn GAIL:
experto + comportamiento del agente ──► discriminador ──► recompensa de imitación ──► policyLa policy sigue aprendiendo interactuando con el entorno, con un algoritmo de RL. En ML-Agents ese algoritmo es PPO, el mismo de la parte 2: para PPO, GAIL es simplemente una señal de recompensa más. La diferencia es que esta recompensa no la diseñamos nosotros: la construye el discriminador.
11. Una recompensa aprendida
Esta es una de las ideas más poderosas de GAIL. En la parte 1 diseñamos a mano una recompensa con nueve componentes (progreso, velocidad objetivo, cercanía al borde, vuelta completa…) y vimos cuántas versiones hicieron falta y cuántas veces el agente encontró atajos. GAIL propone otra cosa: que la recompensa salga de comparar al agente con el experto.
ML-Agents 1.1.0 la calcula así, para cada paso:
(con un pequeño margen numérico para que nunca sea infinita).
La lectura es directa:
- si el discriminador cree que el par es del agente, y la recompensa es casi 0;
- si cree que es del experto, y la recompensa crece;
- con , cuando no puede decidir, la recompensa es .
Hay un detalle que conviene notar: esta recompensa nunca es negativa. Volveremos a eso en la sección 18.
el agente actúa
       ↓
 discriminador
       ↓
"¿parece del experto?"
       ↓
   recompensa
       ↓
     policy
12. Entonces, ¿GAIL elimina la necesidad de diseñar recompensas?
No del todo. Es una interpretación demasiado simplificada.
GAIL aprende una señal de imitación a partir de demostraciones, pero el sistema completo sigue teniendo un entorno, observaciones, acciones, un algoritmo de RL, hiperparámetros y, casi siempre, otras recompensas. Y aprender de un experto no garantiza que el comportamiento aprendido sea óptimo:
Si el experto conduce mal, GAIL puede aprender a conducir como ese experto.
En la práctica, GAIL casi nunca se usa solo. La configuración que se preparó para Agentic Racing mantenía toda la recompensa diseñada de la parte 1, con peso 1.0, y le agregaba la de GAIL con un peso de 0.15. GAIL no reemplazaba la recompensa: la complementaba.
13. ¿Cuál es la diferencia con Behavioral Cloning?
| Característica | Behavioral Cloning | GAIL |
|---|---|---|
| Tipo de aprendizaje | supervisado | imitación mediante RL |
| ¿Aprende directamente acciones? | sí | no: aprende a producir una distribución parecida |
| ¿Usa demostraciones? | sí | sí |
| ¿Usa discriminador? | no | sí |
| ¿Necesita interactuar con el entorno? | no | sí |
| ¿Aprende en los estados que visita la propia policy? | no | sí |
| ¿Usa una recompensa? | no | sí, una aprendida |
En una frase cada uno:
- Behavioral Cloning: “haz lo mismo que hizo el experto en esta situación”.
- GAIL: “produce un comportamiento que se parezca al del experto”.
La diferencia parece pequeña, pero conceptualmente es enorme.
14. El problema de BC que GAIL ataca
Recordemos los errores acumulativos de la parte 3. BC aprende de los estados que visitó el experto, pero después la policy visita los suyos:
trayectoria del experto  ─────────────────────►

trayectoria del agente   ───────────╮
                                    ╰────────► fuera de la distribución
GAIL tiene una ventaja conceptual: la policy genera sus propios estados interactuando con el entorno, y el discriminador también los evalúa. Si la policy se va a un estado que el experto nunca visitó, el discriminador lo reconoce como “del agente” y la recompensa de GAIL baja. La forma de volver a ganar recompensa es volver a zonas que se parezcan a las del experto. Es decir, GAIL no solo le enseña al agente qué hacer donde estuvo el experto: le da un motivo para regresar ahí.
En Agentic Racing eso habría sido especialmente relevante. Como vimos en la parte 3, las demostraciones se grabarían siempre desde arranques limpios (centrados, alineados, a 14 m/s), mientras que el entrenamiento arranca con ruido de rumbo y de posición. Con BC, esos primeros estados quedarían fuera de lo que enseñan las demostraciones. Con GAIL, la recompensa empujaría a la policy a llegar cuanto antes a estados parecidos a los del experto.
Eso no significa que GAIL elimine el problema mágicamente. Significa que el entrenamiento tiene en cuenta la distribución de estados que genera la propia policy, que es justo lo que BC no hacía.
15. Occupancy measures: la idea matemática detrás de GAIL
Una forma elegante de entender GAIL es a través de las occupancy measures. Simplificando, una policy induce una distribución sobre los pares estado–acción que visita:
y el experto induce la suya:
GAIL busca una policy cuya distribución se parezca a la del experto:
Hay un resultado elegante detrás (Ho y Ermon, 2016): cuando el estado es completamente observable, cada policy tiene una única distribución de este tipo, así que igualar las distribuciones es, en el fondo, igualar la policy del experto:
en los estados que visita el experto. Entonces, ¿qué cambia respecto de BC? Dónde se miden los errores. BC los mide en los estados del experto; GAIL, en los estados por los que realmente pasa la policy. Un error que saca a la policy de la zona del experto le cuesta poco a BC y mucho a GAIL.
Esto conecta con un límite que vimos en la parte 3. Que el experto tenga memoria no es, por sí solo, un obstáculo: en teoría siempre existe una policy sin memoria que reproduce la misma distribución de pares estado–acción. Lo que sí es un obstáculo en Agentic Racing es otra cosa. Primero, las 42 observaciones no son el estado completo: no incluyen, por ejemplo, el comando de volante anterior, del que depende el filtro del experto. Segundo, la policy que igualaría al experto tendría que ser multimodal (ante la misma observación, a veces acelerar y a veces dar reversa), y una policy gaussiana como la de la parte 2 solo puede tener una moda por acción. GAIL no puede inventar la información que falta ni darle a la policy una forma que no tiene.
16. GAIL como problema adversarial
Juntando las dos partes, GAIL se puede escribir así:
El discriminador intenta maximizar su capacidad de distinguir al experto del agente, y la policy intenta que esa distinción sea difícil. (La formulación original de Ho y Ermon agrega un término de entropía de la policy; en ML-Agents, el término de entropía de PPO que vimos en la parte 2 cumple un papel parecido, aunque no idéntico. Además, Ho y Ermon definen al revés, como la probabilidad de que el par venga del agente; la recompensa resultante es equivalente.)
No es exactamente una GAN aplicada a trayectorias: como vimos en la sección 3, el entorno se interpone entre la policy y lo que ve el discriminador, y por eso la policy aprende con RL.
17. ¿Por qué no simplemente copiar las acciones?
Imaginemos que, en una situación, el experto gira con steer = 0.35, y que nuestro agente, en una
situación muy parecida, consigue prácticamente el mismo resultado con steer = 0.32.
BC penalizaría directamente esa diferencia. GAIL pregunta otra cosa: ¿el comportamiento resultante se parece al del experto? Si las diferencias de 0.03 son normales dentro de lo que hace el propio experto, el discriminador no tiene cómo usarlas.
En ML-Agents esto tiene un ajuste explícito. Con use_actions desactivado, el discriminador ni
siquiera ve las acciones: compara solo los estados por los que pasa cada uno, y al agente le basta
con llegar a los mismos lugares de la misma forma. Con use_actions activado, como en la configuración
de Agentic Racing, compara pares completos, pero sigue comparando distribuciones, no acciones una por
una.
Por eso GAIL puede capturar algo más cercano al estilo de comportamiento.
18. Pero GAIL tampoco es magia
GAIL puede tener problemas:
- el discriminador puede aprender demasiado rápido y dejar a la policy sin una señal útil;
- o demasiado lento, y entonces su recompensa no distingue nada;
- las demostraciones pueden ser insuficientes o cubrir pocas situaciones;
- el experto puede ser subóptimo;
- las observaciones pueden no contener lo que el experto usa para decidir;
- el entrenamiento adversarial puede ser inestable.
Y hay uno menos obvio, que en Agentic Racing habría sido concreto. Como vimos en la sección 11, la recompensa de GAIL nunca es negativa. En una tarea donde el episodio termina cuando el agente falla, una recompensa siempre positiva por paso significa que sobrevivir más tiempo da más recompensa, independientemente de si el agente se parece al experto. Kostrikov et al. (2019) describen este sesgo en detalle.
En la parte 1 vimos lo que pasa en Agentic Racing cuando la recompensa tiene una salida fácil: en la cuarta corrida, el agente aprendió a detenerse a propósito porque así cobraba más. Con GAIL, la tentación iría en la dirección contraria: alargar el episodio.
Y ese efecto no habría sido pequeño. El 0.15 de la configuración parece un peso bajo frente al 1.0 de la recompensa del entorno, pero hay que mirar la escala. Con el discriminador indeciso (), GAIL paga por decisión, en todas las decisiones. La recompensa diseñada, conduciendo bien a 21 m/s, paga como mucho unos 0.07 por decisión (0.04 por progreso, 0.025 por velocidad objetivo y casi nada por la trazada). Es decir: por paso, GAIL habría pesado tanto o más que toda la recompensa diseñada. Y como cualquier fin de episodio corta esa recompensa futura, también terminar la vuelta antes le habría costado algo al agente; el bono de vuelta, de 12 a 20, habría tenido que compensarlo. El corte por falta de progreso (menos de 8 metros en 5 segundos termina el episodio) limita la peor versión del problema, que es quedarse quieto, pero no lo elimina. Es exactamente el tipo de cosa que habría que medir antes de confiar en el resultado.
Lo que nos lleva a la pregunta importante:
¿Cómo sabemos si el agente realmente está aprendiendo a imitar al experto?
No basta con ver que cambie la pérdida del discriminador. Hay que mirar el comportamiento.
19. ¿Cómo evaluar GAIL?
ML-Agents reporta varias métricas propias de GAIL en TensorBoard: la pérdida del discriminador
(Losses/GAIL Loss), la penalización de gradiente, y las dos más útiles para ver el juego en acción:
Policy/GAIL Expert Estimate y Policy/GAIL Policy Estimate, la salida media del discriminador sobre
las demostraciones y sobre las experiencias del agente. Si esas dos curvas se acercan, el agente se
está volviendo difícil de distinguir. Si el estimado del agente se queda pegado en 0, el discriminador
ganó y la policy no está recibiendo señal.
Pero, como en la parte 3, las métricas del algoritmo no alcanzan. En Agentic Racing también habría que mirar:
Métricas de imitación:
- cuánto se parecen las trayectorias del agente a las del experto;
- la distribución de las acciones, en especial del freno, que la policy de la parte 2 casi no usaba;
- la velocidad en cada tramo y el comportamiento en las curvas.
Métricas de conducción:
- fracción de vuelta completada y vueltas completas;
- tiempo por vuelta;
- motivos de fin de episodio: salida de pista, auto detenido, sin progreso;
- capacidad de recuperación desde arranques con ruido.
El evaluador del proyecto ya mide casi todas las de conducción. Las de imitación habría que construirlas.
20. El papel del experto vuelve a ser fundamental
Es tentador pensar que “GAIL aprende por sí mismo”. No exactamente. El experto sigue siendo la fuente de conocimiento:
experto ──► malas demostraciones ──► GAIL ──► mal comportamientoGAIL no sabe que el experto está equivocado. Por eso todo lo que vimos en la parte 3 sobre las demostraciones sigue valiendo, y en Agentic Racing vale con los mismos detalles: las grabaciones empezarían siempre desde arranques limpios, cubrirían un único circuito, y el experto tiene comportamientos de recuperación que dependen de temporizadores. Para GAIL, además, la cobertura importa por otra razón: el discriminador solo puede reconocer como “del experto” lo que aparece en las demostraciones.
La calidad de las demostraciones importa, también para GAIL.
21. Un experto heurístico puede ser suficiente
Una de las partes más interesantes del proyecto es que no hace falta un piloto humano:
controlador heurístico ──► demostraciones ──► GAIL ──► neural policyEsto permite usar un controlador tradicional como profesor. Y aparece una idea que me parece especialmente valiosa desde el punto de vista de ingeniería:
Podemos usar software tradicional para generar los datos que enseñan a un modelo de machine learning.
No hace falta reemplazar de inmediato el sistema tradicional. Puede ser la fuente de conocimiento. En Agentic Racing, de hecho, ese controlador terminó siendo el piloto del demo, y un estratega LLM le dice cómo conducir a través de las directivas. La red que habría aprendido de él nunca llegó a existir, pero el patrón sigue siendo válido.
22. BC + GAIL
Ahora podemos combinar los dos métodos de imitación:
- BC: “copia al experto”.
- GAIL: “haz que tu comportamiento parezca el del experto”.
La intuición clásica es secuencial: BC da una policy inicial razonable, y GAIL la sigue refinando mientras interactúa con el entorno, sobre todo en los estados donde BC falla porque se salió de la distribución de las demostraciones.
En ML-Agents la combinación no es secuencial, sino simultánea. Como vimos en la parte 3, BC corre dentro del entrenamiento con un peso que se apaga con el tiempo; GAIL, en cambio, es una recompensa que dura toda la corrida. La configuración que se preparó para Agentic Racing combinaba las dos así:
| Pieza | Configuración | Qué hace |
|---|---|---|
| Recompensa del entorno | strength: 1.0, gamma: 0.995 | la recompensa diseñada de la parte 1 |
| GAIL | strength: 0.15, use_actions: true | recompensa de imitación durante toda la corrida |
| BC | strength: 0.5, steps: 2000000 | empuje inicial hacia el experto: su tasa de aprendizaje es la mitad de la de PPO y se apaga a los 2 millones de pasos |
| PPO | el de la parte 2 | optimiza la suma de las recompensas |
Las demostraciones para BC y para GAIL habrían sido las mismas: las que grabara eval.exe -record.
23. ¿Y dónde entra PPO?
La serie empieza a conectar todas sus piezas. La intuición más común es una cadena: BC para arrancar, GAIL para refinar la imitación y PPO para optimizar la recompensa. En ML-Agents, la estructura real es otra: PPO es el único algoritmo de RL, y BC y GAIL son dos fuentes de conocimiento que se le enchufan. GAIL solo cambia la recompensa que ve PPO; BC, además, da sus propios pasos de gradiente sobre los pesos de la policy, con su propio optimizador, después de cada actualización de PPO.
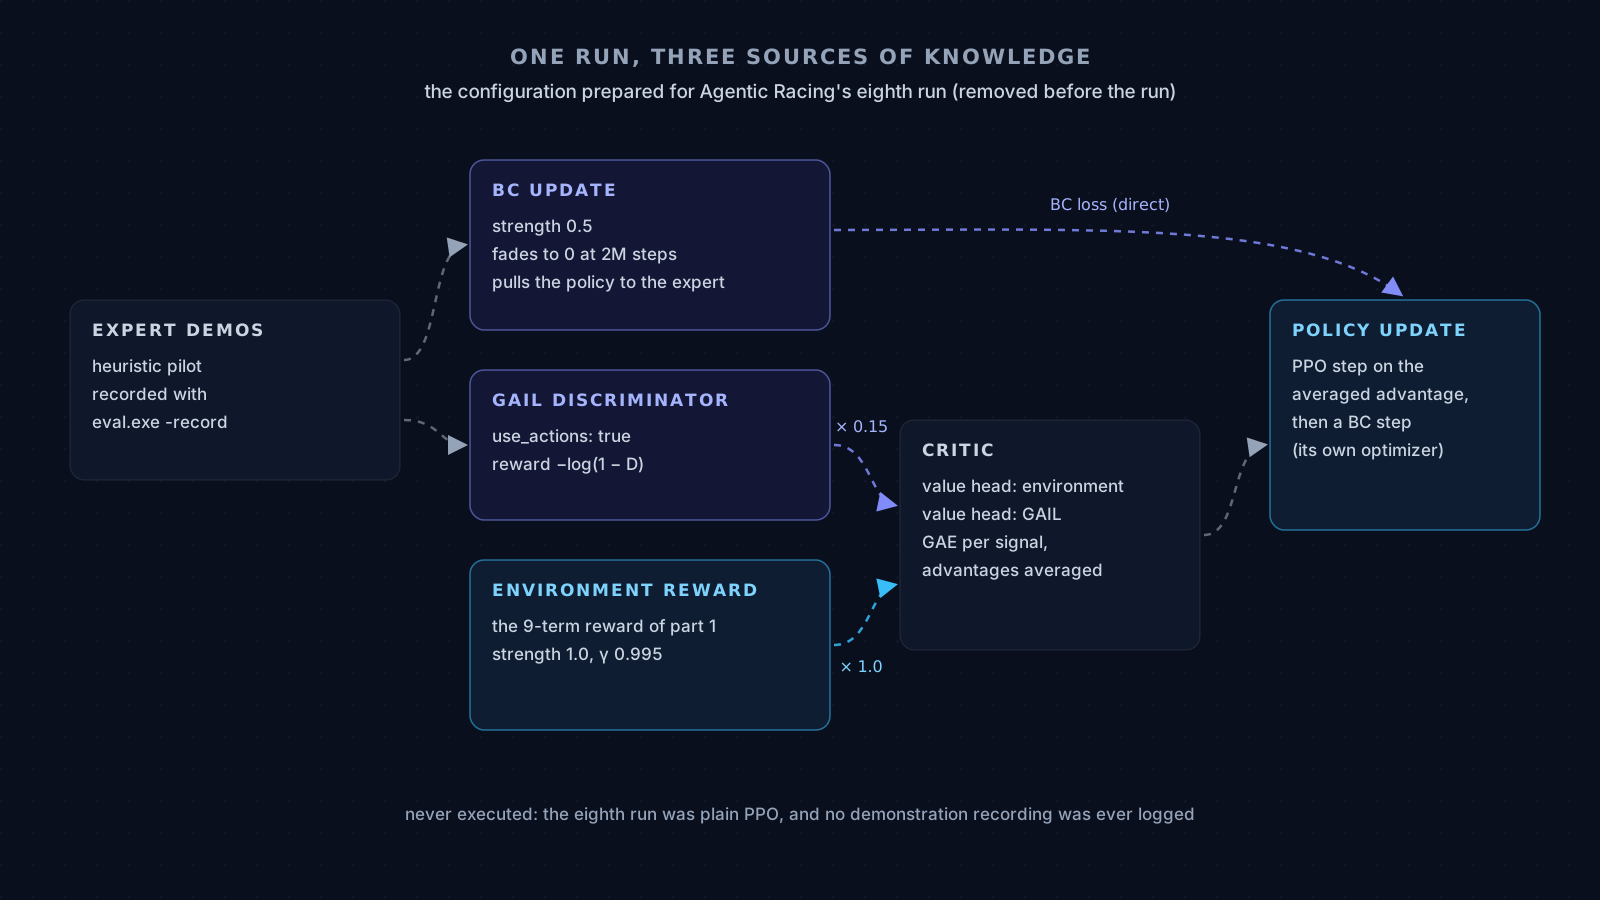
Hay un detalle interno de ML-Agents que merece mención. Cada recompensa tiene su propia “cabeza” en el crítico, su propio factor de descuento y su propio cálculo de GAE. Después, los advantages de todas las recompensas se promedian para formar el advantage que usa PPO. Así que el peso de GAIL no es solo el 0.15 de la configuración: también depende de la escala de su recompensa frente a la del entorno.
Esto nos lleva a una pregunta más interesante que “¿qué algoritmo es mejor?”:
¿Cómo combinamos distintas fuentes de conocimiento para construir una policy mejor?
24. Un posible experimento con Agentic Racing
Podríamos comparar cuatro estrategias, todas sobre el circuito fijo:
| Experimento | Señales de aprendizaje | En ML-Agents |
|---|---|---|
| A. PPO desde cero | recompensa del entorno | extrinsic |
| B. BC + PPO | recompensa del entorno + BC | extrinsic + behavioral_cloning |
| C. GAIL | solo recompensa de imitación | gail |
| D. BC + GAIL + PPO | todo | la configuración que se preparó para la octava corrida, adaptada al circuito fijo |
Y medir, para cada una:
| Métrica | A | B | C | D |
|---|---|---|---|---|
| Fracción de vuelta | ? | ? | ? | ? |
| Vueltas completadas | ? | ? | ? | ? |
| Tiempo por vuelta | ? | ? | ? | ? |
| Salidas de pista | ? | ? | ? | ? |
| Parecido con el experto | ? | ? | ? | ? |
| Recuperación desde arranques con ruido | ? | ? | ? | ? |
Esto es un experimento propuesto. Ninguna de esas celdas tiene un valor, porque nada de esto se ejecutó. Del experimento A sí sabemos algo de las partes anteriores: en las pistas procedurales, la fracción de vuelta se quedó alrededor del 10%. En el circuito fijo nunca se probó.
Lo importante no sería demostrar que una técnica “gana”, sino entender por qué cada estrategia funciona o falla.
25. El verdadero reto: ¿qué significa “parecerse al experto”?
Supongamos dos policies que completan la pista. La A sigue exactamente la trayectoria del experto. La B toma trayectorias diferentes, pero consigue mejores tiempos. ¿Cuál es mejor?
Depende del objetivo. Si queremos imitar al experto, A. Si queremos ganar la carrera, B.
Esa es la diferencia fundamental entre imitation learning y reinforcement learning. GAIL nos acerca al comportamiento del experto. PPO, con la recompensa del entorno, puede alejarnos de él si hacerlo da más recompensa. Y eso puede ser exactamente lo que queremos.
En Agentic Racing, esa tensión tendría una forma muy concreta: el piloto heurístico frena según una regla fija, la velocidad objetivo calculada a partir de la curva que viene. Una policy que se pareciera demasiado al experto heredaría esa regla. Una que optimizara solo la recompensa podría encontrar una mejor, o, como en la parte 1, una salida fácil.
26. Imitar no significa superar
Esta es probablemente la idea más importante del artículo. Si el experto tiene cierto nivel, GAIL intenta aprender un comportamiento parecido a ese nivel. El objetivo de GAIL es la imitación, no la mejora.
Para superar al experto hace falta otra señal que diga “este comportamiento es mejor”. Esa señal es la recompensa del entorno, y el peso relativo de cada una decide hacia dónde tira la policy. Con 1.0 para el entorno y 0.15 para GAIL, como en la configuración de Agentic Racing, la intención era usar la imitación como guía, no como meta. Pero, como vimos en la sección 18, la intención y el efecto no tienen por qué coincidir: por la escala de cada recompensa, GAIL podría haber terminado mandando.
Por eso la combinación de imitation learning y reinforcement learning puede ser mucho más poderosa que cualquiera de las dos por separado.
27. Una forma de entender toda la serie
Hasta ahora hicimos cuatro preguntas:
| Parte | Pregunta | Idea central |
|---|---|---|
| 1. Reinforcement Learning | ¿Puede aprender por prueba y error? | entorno → recompensa → policy |
| 2. PPO | ¿Cómo mejoramos la policy sin destruir lo que ya aprendió? | actualizaciones controladas |
| 3. Behavioral Cloning | ¿Podemos enseñarle observando a un experto? | experto → ejemplos → policy |
| 4. GAIL | ¿Podemos hacer que su comportamiento se parezca al del experto? | discriminador → recompensa de imitación → policy |
Y ahora podemos formular la siguiente:
¿Podemos combinar todas estas ideas?
Esa es la pregunta de la parte 5.
Conclusión
GAIL introduce una idea poderosa:
No necesitamos enseñarle al agente cada acción correcta: podemos enseñarle qué significa comportarse como un experto.
Behavioral Cloning aprende directamente de los pares . GAIL entrena un discriminador que intenta distinguir de y convierte esa competencia en una recompensa que acerca la policy al comportamiento del experto. La diferencia se resume en dos preguntas:
- Behavioral Cloning: ¿qué hizo el experto aquí?
- GAIL: ¿mi comportamiento se parece al del experto?
Pero GAIL no elimina los desafíos. Sigue necesitando buenas demostraciones, buenas observaciones, un entorno adecuado, un entrenamiento estable y una evaluación cuidadosa. Y, como cualquier recompensa, la suya también puede tener atajos.
En Agentic Racing, GAIL quedó en una configuración que nunca se lanzó. Pero esa configuración dice mucho de la intención: la recompensa diseñada como señal principal, la imitación como guía con peso 0.15 y BC como un empujón inicial. Era una apuesta a que el experto le mostrara el camino al agente y que la recompensa lo llevara más lejos. Y también deja una lección: un peso pequeño en la configuración no garantiza una influencia pequeña, porque lo que cuenta es la escala de cada señal.
Imitar al experto puede enseñarnos a comportarnos como él. Aprender con recompensas podría permitirnos ir más allá de lo que el experto sabe hacer.
Ahí es donde Behavioral Cloning, GAIL y PPO empiezan a convertirse en piezas de un mismo sistema.
Si llegaste directo a este artículo, las tres partes anteriores están enlazadas al principio, y Agentic Racing: un piloto que nunca aprendió a manejar cuenta la historia completa del proyecto.
Referencias
- Ho, J. y Ermon, S. (2016). Generative Adversarial Imitation Learning. NeurIPS.
- Goodfellow, I. et al. (2014). Generative Adversarial Nets. NeurIPS.
- Gulrajani, I. et al. (2017). Improved Training of Wasserstein GANs. NeurIPS. (La penalización de gradiente que usa el discriminador de ML-Agents.)
- Kostrikov, I. et al. (2019). Discriminator-Actor-Critic: Addressing Sample Inefficiency and Reward Bias in Adversarial Imitation Learning. ICLR.
- Ross, S., Gordon, G. y Bagnell, J. A. (2011). A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS.
- Unity Technologies. Unity ML-Agents Toolkit, en
particular la recompensa y el discriminador de GAIL
(
ml-agents/mlagents/trainers/torch_entities/components/reward_providers/gail_reward_provider.py) y la combinación de señales de recompensa en el trainer de PPO (ml-agents/mlagents/trainers/ppo/trainer.py) del release demlagents1.1.0. - La configuración de entrenamiento, el experto y la bitácora del proyecto están en github.com/alulema/agentic-racing.