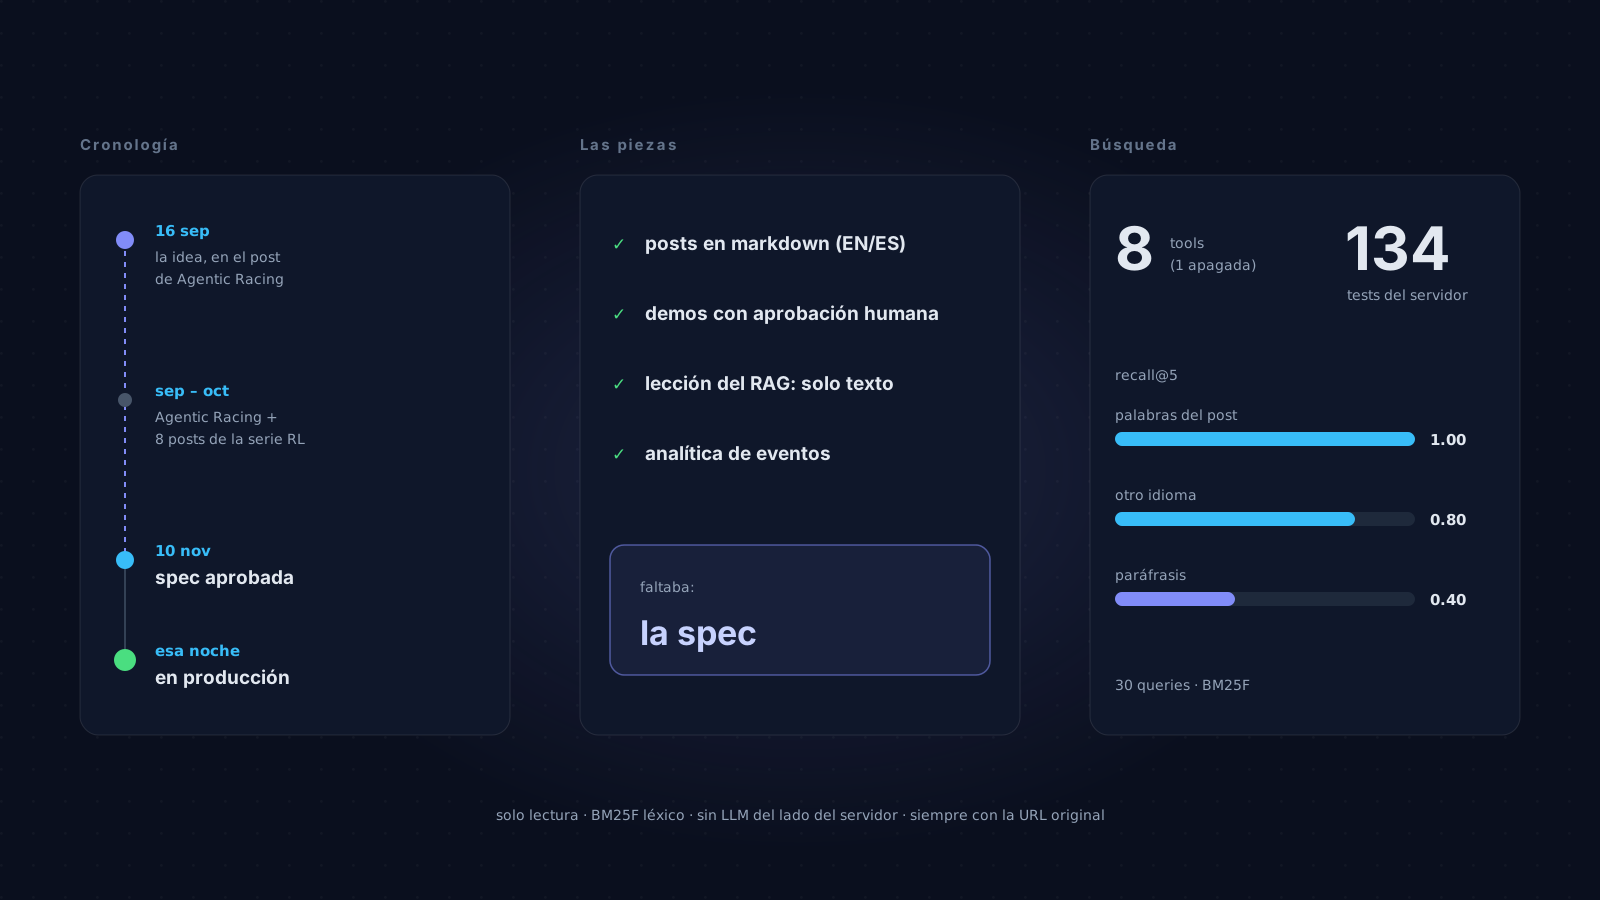
Desde esta semana, este sitio también es un servidor MCP. Si usas Claude, Claude Code, Cursor o cualquier cliente compatible, puedes conectarlo y preguntarle a tu asistente por los posts: que te resuma uno, que te encuentre la sección donde explico el clipping de PPO o que te diga qué demos están corriendo. El servidor solo devuelve texto del blog, siempre con la URL original para que puedas verificarlo.
La pregunta que me hice al publicarlo fue incómoda: si casi todo estaba listo desde hacía semanas, ¿por qué tardé tanto?
Este post es la respuesta honesta. Y como en los posts anteriores, lo construí junto con un asistente de código, con una spec escrita antes y una bitácora que registra cada decisión y cada error.
La idea venía de septiembre
El 16 de septiembre publiqué Agentic Racing. En la introducción escribí que andaba metido en comunicación entre agentes: MCP, A2A, y qué tan lejos se puede llevar la idea de agentes que se coordinan. El estratega de ese demo ya era eso: algo que razona y le manda instrucciones cortas a algo que reacciona.
Un servidor MCP para mi propio blog era el siguiente paso obvio. Un canal estándar por el que cualquier agente pudiera leer lo que escribo, sin scraping y sin inventar.
No lo perdí de vista. Pero no lo hice.
Las piezas ya estaban
Cuando por fin me senté a diseñarlo, casi nada era nuevo:
- El contenido. Todos los posts, en inglés y en español, ya vivían como markdown con metadatos: título, tags, fecha y traducción. Solo había que empaquetarlos en un índice durante el build.
- Los demos con aprobación humana. Desde junio, cada demo del sitio se pide con un formulario y yo apruebo cada solicitud por email. El MCP podía reutilizar ese mismo flujo sin saltarse a nadie.
- La lección del RAG. En el chatbot RAG sobre mi blog aprendí que una garantía no puede vivir en un prompt. Un servidor que solo devuelve texto del corpus, y no genera nada, aplica esa idea desde el diseño.
- La analítica. El sitio ya registraba eventos propios, así que contar cuántas llamadas recibe el MCP era agregar un tipo de evento.
Lo que faltaba no era código. Faltaba sentarme a decidir cómo tenía que ser.
Por qué tardé: los demos iban primero
Entre septiembre y noviembre, el calendario se llenó solo:
- Agentic Racing no terminó al publicarlo. El post cuenta ocho intentos fallidos de entrenar al piloto con aprendizaje por refuerzo y siete corridas del experimento con el estratega. A principios de octubre todavía estaba corrigiendo cifras del entrenamiento, y lo actualicé por última vez el 10 de octubre.
- Ese fracaso se convirtió en una serie entera: ocho posts de Reinforcement Learning desde cero, usando Agentic Racing como laboratorio, publicados entre el 2 y el 13 de octubre.
- En medio salieron el planificador de viajes, el agente que sueña y el demo de Harness², que además trajo un bug de producción: el entorno se destruía a mitad de una corrida larga.
Cada demo era algo que una persona podía probar con un botón. El MCP, en cambio, era una puerta nueva hacia cosas que ya existían. Siempre había algo más visible que hacer primero. No fue una decisión explícita, fue la suma de muchas pequeñas.
Lo que hizo que saliera en una noche
El 10 de noviembre terminé y aprobé la spec. No una lista de ideas: un documento con la arquitectura, las restricciones del entorno, cada tool con su contrato, los límites de uso, un checklist de seguridad y las decisiones abiertas resueltas antes de escribir una línea de código: la URL, si el asistente podía pedir demos, el idioma por defecto, si el índice sería público y si el servidor iría al registro oficial de MCP. Junto con la spec, un plan por fases, cada una con su condición para pasar a la siguiente.
Con eso, el asistente de código hizo la implementación en una sola corrida, casi sin intervención mía (solo le aprobé un par de cosas en el chat), dejando una bitácora con lo que hizo, lo que decidió y lo que quedaba para mí: las credenciales, la configuración y las pruebas con un cliente real. Esa misma noche el servidor respondía en producción.
Dos cosas de esa corrida me parecen las más valiosas:
- Las pruebas de la búsqueda se escribieron antes que el buscador. Treinta consultas, escritas leyendo los posts, con el post que cada una debería encontrar. Así nadie podía ajustar el buscador mirando el examen.
- Antes de tocar el flujo de demos, se escribieron tests que fijan cómo funciona hoy. Recién después se extrajo la función que el MCP reutiliza.
La lección es casi vergonzosa por lo simple: el retraso nunca estuvo en el código. Estaba en no haber escrito la spec.
Las restricciones definieron el diseño
| Lo típico | Mi versión | Por qué |
|---|---|---|
| SDK oficial de MCP | Un despachador JSON-RPC propio, de unas 1 000 líneas | El SDK espera un servidor web asíncrono, y la API del sitio son funciones serverless que solo responden HTTP. La superficie es chica. |
| Búsqueda semántica con embeddings | BM25F léxico sobre un índice generado en el build | La base vectorial del chatbot RAG solo existe mientras hay un demo activo. El MCP no puede depender de ella. |
| Sesiones con estado y streaming | HTTP sin estado, una respuesta JSON por petición | Encaja con funciones que viven lo que dura una petición. |
| Un subdominio propio detrás de un proxy | La misma URL del sitio, /api/mcp | El proxy se construyó, con sus tests, y después lo aparqué: sumaba un componente, un secreto y un salto de red sin aportar nada. |
| Que el asistente pueda pedir demos | La tool existe, pero está apagada | Primero quiero ver una o dos semanas de tráfico real. Cuando se active, la solicitud seguirá llegando a mi email. |
Lo que no hace, a propósito: el servidor no genera respuestas con un modelo propio. Recupera texto y el modelo del cliente lo sintetiza. No pago tokens, y lo que el servidor devuelve siempre sale del blog.
Pero hay que decirlo: la garantía es más débil que la del chatbot RAG. El servidor controla qué texto entrega, no lo que el asistente del otro lado hace con él.
Lo que se rompió (o casi)
- El plan se contradecía a sí mismo. Pedía detectar español con al menos dos palabras típicas del idioma, pero su propio caso de prueba, “aprendizaje por refuerzo”, tiene una sola: “por”. Ganó la spec, que pedía comparar idiomas en vez de contar palabras.
- El portugués se detectaba como español. “Como funciona o aprendizado por reforço” daba español por “como” y “por”. Se agregaron señales fuertes de portugués y una lista mínima de francés, solo para no confundirlos.
- “C#” desaparecía al tokenizar. Ahora
C#,C++y.NETse convierten en palabras normales antes de dividir el texto. - La descripción para el registro oficial de MCP tenía 127 caracteres, y el máximo es 100. Se detectó validando contra el schema antes de publicar, no después.
- Un script de prueba sin
jqmandaba un cuerpo vacío, y el servidor respondía un error 415 que no explicaba nada. Ahora el script exigejqy dice qué falta.
La medición
La búsqueda se evaluó con esas 30 consultas sobre el índice real del blog, 10 de cada tipo. Cuento como acierto que el post esperado aparezca entre los 5 primeros (recall@5). El MRR premia, además, que aparezca arriba.
| Tipo de consulta | Ejemplo | recall@5 | MRR |
|---|---|---|---|
| Con palabras del post | ”PPO clipping policy update” | 1.00 | 0.95 |
| En el otro idioma | ”algoritmo de Levenshtein en JavaScript” → un post en inglés | 0.80 | 0.72 |
| Paráfrasis | ”copying what a teacher does instead of trial and error” | 0.40 | 0.28 |
El hueco de las paráfrasis es real y era esperable: BM25 busca palabras, no significados. “How do agents remember things over time” no encontró el post del agente que sueña, que trata justamente de memoria. Mi favorito de los fallos: “an AI that rewrites its own prompts and a grader that approves everything” describe exactamente el post de Harness², y el primer resultado fue un solucionador de sudoku en C#. El post dice “judge”, no “grader”, y habla de mejorar instrucciones, no de reescribir prompts. Cuenta la misma historia con otras palabras.
No se ajustó el buscador mirando esas consultas. Con los pesos de la spec, las consultas con palabras del post dieron 1.00 en la primera corrida, así que no había nada que ajustar, y las paráfrasis quedaron como línea base.
Además, el servidor tiene 134 tests automatizados, y pasan todos. Construir el índice toma unos 300 ms y cada búsqueda unos 3,5 ms, medidos en la corrida sobre el índice real.
La limitación honesta: son 30 consultas, y las escribió el asistente leyendo los posts, no lectores reales. Los tests corren contra el código y el índice del blog, no contra el servidor en producción. Y todavía no hay tráfico suficiente para hablar de uso.
Lo que haría distinto
Escribir la spec en septiembre. No necesitaba dos meses libres: necesitaba sentarme a decidir. Todo lo que vino después fue rápido porque las decisiones ya estaban tomadas.
Lo que viene
La spec ya tiene el experimento del próximo post: ¿un asistente con este MCP léxico responde sobre mi blog tan bien como mi chatbot RAG con búsqueda semántica? Las mismas preguntas contra los dos, midiendo si cada afirmación sale del texto, si cita bien y si dice “no sé” cuando corresponde. Sospecho que lo interesante estará en las fallas: un modelo grande puede compensar la búsqueda léxica reformulando la consulta varias veces, y uno pequeño no.
Lo que me llevo
Lo urgente le gana a lo importante sin que te des cuenta. Nunca decidí postergar el MCP. Simplemente siempre había un demo más visible.
El cuello de botella era la decisión, no el código. Con las decisiones resueltas por escrito, la implementación fue una noche.
Escribir el examen antes que la solución te obliga a ser honesto. El 0.40 de las paráfrasis no es un número bonito, pero es real, y es justo lo que va a medir el siguiente experimento.
Si quieres probarlo, en alexisalulema.com/es/mcp están las instrucciones para cada cliente. En Claude Code es una línea:
claude mcp add --transport http alexisalulema https://alexisalulema.com/api/mcpPídele que te resuma la serie de RL o que te diga en qué post hablo del juez que siempre dijo que sí. Y si una paráfrasis no encuentra nada, ya sabes por qué.
Casi dos meses esperando. Una noche construyéndolo.