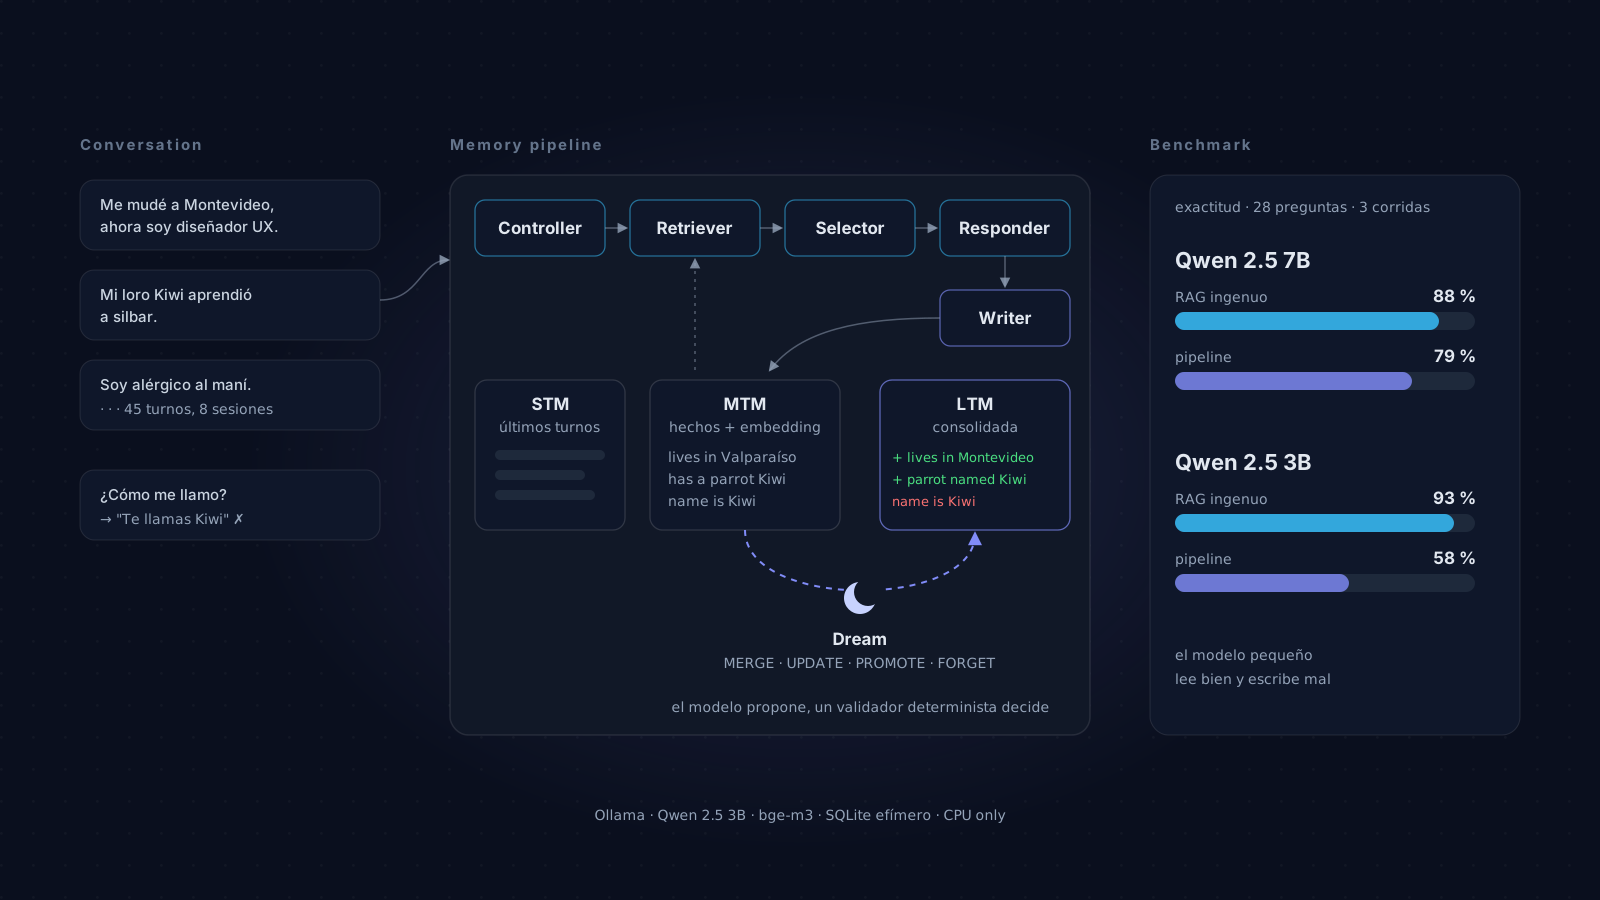
Este post abre una serie nueva en el blog: Paper → Demo en vivo → Post honesto. La idea es simple: tomar un paper reciente, construir un demo que cualquiera pueda probar, medirlo con cuidado y contar lo que salió, incluido lo que no salió como el paper sugiere. El primero es sobre memoria para agentes.
Hace tiempo que le daba vueltas a una idea: un agente conversacional no debería recordarlo todo como un acta, sino hacer algo parecido a lo que hacemos nosotros al dormir. Durante el día acumulamos detalles sueltos; de noche, el cerebro decide qué se queda, qué se fusiona con lo que ya sabíamos y qué se descarta. Un agente con memoria de corto, mediano y largo plazo, y una fase offline que la reorganiza. Lo tenía como una de esas ideas que uno anota para “algún día”.
Por eso fue una alegría encontrarme con LightMem, presentado en Lightweight LLM Agent Memory with Small Language Models por Jiaquan Zhang, Chaoning Zhang, Shuxu Chen, Zhenzhen Huang, Pengcheng Zheng, Zhicheng Wang, Ping Guo, Fan Mo, Sung-Ho Bae, Jie Zou, Jiwei Wei y Yang Yang, aceptado en ACL 2026 (arXiv:2604.07798). Es genial ver una idea que uno tenía rondando convertida en un trabajo formal, con una arquitectura clara, experimentos serios y un nombre. Todo el crédito del diseño es de ellos; lo mío es un demo inspirado en su arquitectura y una medición en condiciones mucho más modestas que las suyas.
Una aclaración que hago por respeto al trabajo de los autores: esto no es una reproducción del paper ni lo evalúa. Cambié piezas importantes (más abajo detallo cuáles y por qué), así que mis números dicen algo sobre mi versión con modelos locales pequeños, no sobre LightMem.
Y lo mismo que en los posts anteriores: lo construí junto con un asistente de código, en sesiones largas de decisiones y mediciones, con una bitácora que registra cada problema y cómo se resolvió.
Lo que propone el paper
LightMem organiza la memoria de un agente en tres niveles:
- STM (memoria de corto plazo): los últimos turnos de la conversación, tal cual.
- MTM (memoria de mediano plazo): resúmenes semánticos de lo conversado, con su embedding, información temporal y estadísticas de acceso.
- LTM (memoria de largo plazo): conocimiento consolidado y des-identificado, que en el paper es un grafo de entidades y relaciones.
Lo interesante es quién administra esa memoria. En vez de un modelo grande haciendo todo, el paper usa modelos de lenguaje pequeños (SLM) especializados: un Controller que convierte la pregunta en consultas y decide dónde buscar, un Selector que filtra los candidatos recuperados y un Writer que resume cada turno en entradas de MTM. Cada cierto número de turnos, una fase offline consolida la MTM en la LTM: fusiona, actualiza, refuerza o deja decaer lo que tiene poca evidencia.
El nombre del paper lo dice: memoria liviana. Reportan mejoras sobre A-MEM en LoCoMo y una recuperación con latencia p50 de 83 ms. Dos detalles importan para lo que viene: el Selector está afinado con LoRA, y la respuesta final la genera GPT-4o-mini. Los modelos pequeños administran la memoria; uno grande responde.
Las restricciones definieron el diseño (otra vez)
Como los demos anteriores, este vive en la infraestructura efímera del sitio, así que heredó sus reglas:
- Todo local. Ollama y modelos abiertos. Cero APIs externas, cero API keys.
- CPU only, en un pod pequeño.
- Sin estado. La memoria vive en un SQLite efímero: cuando el demo se destruye, se olvida todo. Muy apropiado para un agente que sueña.
Eso me obligó a apartarme del paper en varios puntos:
| Paper | Mi versión | Por qué |
|---|---|---|
| SLM de 1–1.5B, Selector afinado con LoRA | Qwen 2.5 de 3B y 7B, sin fine-tuning; el mismo modelo con prompts distintos | El fine-tuning queda fuera del alcance de un demo |
| Responder: GPT-4o-mini | Responder local, el mismo modelo pequeño | Regla de cero APIs. Es la diferencia más grande |
| LTM como grafo | LTM como lista de entradas | Simplicidad |
| Consolidación automática cada 10–15 turnos | Botón 🌙 Dream | Que la consolidación se vea |
| Embeddings en inglés (MiniLM) | bge-m3, multilingüe | Mis conversaciones mezclan español e inglés |
Cómo funciona el demo
En cada turno, el Controller decide si el mensaje trae información nueva y escribe las consultas de búsqueda. El Retriever busca por similitud coseno en MTM y LTM, el Selector se queda con lo relevante y el Responder contesta con eso más los últimos turnos. Después de responder, el Writer extrae hechos atómicos del mensaje del usuario (“The user lives in Quito”) y los guarda en MTM.
Todas las salidas de los módulos son JSON validado contra un esquema, con un reintento y un fallback determinista si el modelo falla. La traza de cada turno muestra qué decidió cada módulo y cuánto tardó.
El sueño es la parte que más me divertía construir. Al pulsar Dream:
- Las entradas se agrupan por similitud, temas o entidades compartidas.
- El modelo propone operaciones sobre cada grupo:
MERGE,UPDATE,PROMOTE(de MTM a LTM) yFORGET. - Un validador determinista revisa cada propuesta antes de aplicarla.
- Lo aprobado se aplica en una sola transacción, sin borrar nada de verdad: lo reemplazado queda marcado y apunta a lo que lo reemplazó.
La UI muestra el resultado como un diff: en verde lo nuevo, tachado en rojo lo reemplazado u olvidado, y aparte las propuestas que el validador rechazó, con el motivo.
Ese validador se convirtió en el corazón del proyecto, por una razón que se repite en este blog: el modelo propone, el código decide. Rechaza un UPDATE que introduce un nombre o un número que no estaba en ninguna de las entradas originales, uno que pierde el valor vigente (“trabaja como diseñador UX” → “trabajaba como arquitecto”), un FORGET sobre conocimiento de largo plazo, o un PROMOTE sin evidencia suficiente.
Los modelos copian los ejemplos
Antes del benchmark ya aparecieron las primeras lecciones, y casi todas vinieron del mismo lugar: los ejemplos de los prompts.
El Writer tenía un ejemplo con un perro llamado Toby que vive en Madrid. En la primera conversación de prueba, la memoria terminó diciendo que el usuario tenía un perro llamado Toby y vivía en Madrid, aunque el usuario nunca lo había dicho. Cambié los ejemplos por entidades neutrales y apareció “Bilbao”. Los cambié otra vez y el 3B empezó a registrar que el usuario era profesor, tenía una panadería o tenía un gato, todo sacado de los ejemplos.
La solución que mejor funcionó fue el grounding: cada nombre propio y cada número de un hecho tiene que aparecer en el mensaje del usuario (con tolerancia a traducciones: “Lisbon” vale si el mensaje dice “Lisboa”). Atrapa los nombres y los números inventados. No atrapa los sustantivos comunes: “teacher” no se puede verificar contra un mensaje en español sin traducir. Ese límite reaparece más adelante.
El benchmark
Para medir, armé un usuario ficticio, Mateo, con 8 sesiones de conversación: 45 turnos en español e inglés, con paráfrasis (su loro Kiwi aparece en cinco sesiones), cambios (se muda de Valparaíso a Montevideo, deja la arquitectura por el diseño UX, deja de ser vegetariano) y ruido (el clima, el tráfico, lo que desayunó). Después, 28 preguntas en sesiones nuevas: hechos simples, hechos actualizados, preguntas que cruzan sesiones, preguntas temporales y preguntas sobre cosas que Mateo nunca dijo, donde lo correcto es decir “no lo sé”.
Cuatro condiciones, mismo modelo y mismos datos:
| Condición | Memoria |
|---|---|
| A | Sin memoria: solo los últimos turnos |
| B | RAG ingenuo: cada frase del usuario guardada literal; las 8 más parecidas van al Responder |
| C | El pipeline completo, sin sueño |
| D | El pipeline más un Dream al final de cada sesión |
La condición B es deliberadamente tonta: no extrae, no resume, no consolida. Es el control.
Tres corridas por condición, porque con temperatura 0 y seed fija los resultados igual varían. (Lo aprendí en la primera prueba.)
v1: el control gana por 20 puntos
| Condición | Exactitud (7B) |
|---|---|
| A — sin memoria | 18 % |
| B — RAG ingenuo | 89 % |
| C — pipeline | 69 % |
| D — pipeline + Dream | 66 % |
El RAG ingenuo le ganó al pipeline por 20 puntos, y el sueño restó 3 más. Reconstruí la memoria de una corrida para entender por qué, y encontré un error en cada módulo:
- El Controller decidía no buscar. Ante “¿qué idioma estoy aprendiendo?” marcaba que no hacía falta memoria, y el Responder inventaba la respuesta.
- El Selector podaba de más. Las preguntas temporales necesitan unir dos hechos (“era arquitecto en Estudio Faro” y “tomó un curso de UX”); el Selector se quedaba con uno y la respuesta era “no tengo información”.
- El Dream volvió permanentes los errores del Writer. De “mi loro Kiwi aprendió a silbar”, el Writer había sacado “the user’s name is Kiwi”. El Dream lo interpretó como un cambio de nombre y lo consolidó. En 2 de 3 corridas, el agente terminó diciéndole a Mateo “Te llamas Kiwi”.
- El Dream olvidó la alergia al maní. Un hecho dicho una sola vez parece ruido, y
FORGETno distingue entre “desayunó medialunas” y “es alérgico al maní”.
El validador hizo su trabajo: bloqueó 18 actualizaciones que perdían el valor vigente. Pero el validador revisa la forma, no la verdad. “Te llamas Kiwi” no inventa ningún nombre: Kiwi estaba en el mensaje.
v2: arreglar una pieza expone la siguiente
Con ese diagnóstico hice cuatro cambios, validados primero con conversaciones de desarrollo y no con el benchmark, para no ajustar el sistema a las preguntas:
- Buscar siempre, aunque el Controller diga que no hace falta.
- Pasarle al Responder los textos originales que eligió el Selector (al menos 3, con fecha), en vez de su resumen.
- El grounding del Writer.
- Solo permitir olvidar eventos puntuales, nunca hechos sobre salud, trabajo, familia, mascotas o planes.
| Condición | v1 | v2 |
|---|---|---|
| B — RAG ingenuo | 89 % | 88 % |
| C — pipeline | 69 % | 79 % |
| D — pipeline + Dream | 66 % | 79 % ± 9 (71 / 75 / 89) |
Diez puntos de mejora, y el RAG ingenuo sigue arriba, con la mitad de la latencia (3.4 s contra 7.9 s por turno) y un tercio de las llamadas al modelo.
Lo más interesante de v2 fue lo que el arreglo destapó. Al pasar los textos originales en vez del resumen, el Responder empezó a ver “se llama Mateo” y “se llama Kiwi”. Como el prompt le pide confiar en lo más reciente, C respondió “Te llamas Kiwi” en las tres corridas. En v1 el resumen del Selector ocultaba ese error del Writer, y lo ocultaba por casualidad. El sueño, a veces, lo reparaba: fusionaba “tiene un loro llamado Kiwi” con “se llama Kiwi”. A veces no. Misma configuración, de 71 a 89 % según la corrida.
Y aparecieron corrupciones que pasan todas las reglas: el Dream escribió que Mateo vive en Pagora (Pagora es la empresa donde trabaja) y que “vive en Valparaíso (antes era alérgico al maní)”. Todo está grounded: cada palabra viene de un hecho real. Las reglas evitan que el modelo invente; no evitan que mezcle.
Con 3B, la brecha se dispara
El paper usa modelos de 1–1.5B, así que corrí lo mismo con Qwen 2.5 3B:
| Condición | 7B | 3B |
|---|---|---|
| B — RAG ingenuo | 88 % | 93 % |
| C — pipeline | 79 % | 58 % |
| D — pipeline + Dream | 79 % | 49 % |
El RAG ingenuo con 3B fue la mejor configuración de todo el estudio, y la más rápida: 1.4 s por turno. El pipeline con el mismo modelo perdió 35 puntos.
Ahí está la frase que me llevo de este proyecto: el modelo pequeño lee bien y escribe mal. Como lector de frases literales, el 3B iguala o supera al 7B. Como escritor de memoria, se desmorona:
- El Controller marcó como “sin información nueva” el 58 % de los turnos, entre ellos el nombre de Mateo, su cumpleaños y su loro. Esos hechos nunca llegaron a la memoria.
- Los ejemplos de los prompts se filtraron como sustantivos comunes, justo donde el grounding no llega: “teacher” 3 veces, “bakery” 6, “cat” 9 (para un loro).
- El sueño consolidó la basura junto con lo real: “es alérgico al maní y va a la piscina”, “tomó un curso de UX y aprendió a silbar una canción nueva” (lo del loro, otra vez), “tiene amigos llamados Kiwi y Ramón” (Ramón es el perro).
Hay una ironía que me hizo reír: mi post anterior sobre un chatbot RAG era exactamente la condición B, y aquí le ganó a una arquitectura mucho más elaborada.
Por qué gana el RAG ingenuo
El RAG ingenuo guarda lo que el usuario dijo, literal. No hay ningún paso donde un modelo pequeño pueda reescribir, perder o inventar un hecho. El pipeline, en cambio, reescribe la memoria dos veces: el Writer convierte cada mensaje en hechos y el Dream convierte esos hechos en otros. Cada reescritura es una oportunidad de equivocarse, y la consolidación convierte esos errores en permanentes: el error deja de ser una frase rara entre muchas y pasa a ser el recuerdo.
Esto no contradice al paper; lo acota. Su Selector está afinado con LoRA para esa tarea, y la respuesta la escribe GPT-4o-mini. Mi resultado dice que sin esas piezas grandes, la arquitectura no se sostiene sola con un modelo pequeño. Es una pregunta distinta, y la respuesta en mis condiciones es clara.
Publicarlo: el demo que tardaba 90 segundos por llamada
Faltaba ponerlo en línea, y en CPU apareció el problema que más me enseñó de la parte de infraestructura.
La primera medición con el 3B, limitado a 2 vCPU como el pod del demo, fue desastrosa: el Controller tardaba entre 87 y 180 segundos, y el Writer se quedaba sin tiempo en 4 de 10 turnos. Incluso el 1.5B tardaba ~50 segundos por llamada. No cuadraba con nada que hubiera visto antes.
La causa: dentro del contenedor, Ollama ve los 10 núcleos del host, no los 2 que le asigna el límite, y lanza un hilo por núcleo. El límite de CPU del kernel reparte el tiempo de 2 núcleos entre 10 hilos que necesitan coordinarse capa a capa, y todos terminan esperándose entre sí. Al fijar los hilos al límite real (num_thread=2), la misma llamada pasó de 91 a 4 segundos.
Con eso arreglado, lo que queda es la física de un modelo en CPU: lee el prompt rápido y genera unos pocos tokens por segundo, así que cada módulo cuesta lo que escribe. El pipeline hace 2 o 3 llamadas antes de responder:
| qwen2.5:3b | Respuesta (p50) | Writer (en segundo plano) |
|---|---|---|
| 2 vCPU | ~75 s | ~100 s |
| 4 vCPU | ~30 s | ~50 s |
Me quedé con el 3B y 4 vCPU. Para que la espera sea tolerable, el Writer corre después de responder: ves la respuesta primero y, unos segundos después, los hechos que aprendió aparecen en la memoria con la marca “aprendiendo…”.
Y como el resultado principal es que el RAG ingenuo gana, el demo no lo esconde. Tiene un selector con tres modos: LightMem, RAG y Comparar, que responde la misma pregunta de las dos formas lado a lado, con sus latencias y sus trazas. Es la forma más honesta que se me ocurrió de mostrar la arquitectura: dejar que la compares tú.
Lo que deliberadamente no hice
- Sin fine-tuning. Un Selector afinado con LoRA, como el del paper, es probablemente la pieza que más cambiaría los números. Quedó fuera del alcance.
- Sin un modelo grande para responder. Es la regla de cero APIs, y es la mayor diferencia con el paper.
- Sin grafo en la LTM. Una lista plana alcanza para mostrar la consolidación.
- Sin multiusuario. Un solo usuario, memoria efímera.
Y la limitación honesta de la medición: un usuario ficticio y 28 preguntas, puntuadas con palabras clave y revisadas a mano (corregí dos errores del scoring en esa revisión). Es un estudio de caso, no un benchmark general.
Lo que haría distinto
Si empezara de nuevo, separaría guardar de interpretar. Guardaría siempre la frase literal del usuario, como el RAG ingenuo, y dejaría que el Writer y el sueño produjeran solo índices sobre esas frases: etiquetas, vínculos, un resumen para buscar mejor. Nunca reemplazos. Si el sueño se equivoca, se pierde un índice, no un recuerdo. Es la misma lección del planificador de viajes, en otro dominio: sacarle al modelo las decisiones que no puede tomar bien.
Lo que me llevo
Me quedo con tres ideas.
La primera: con modelos locales pequeños, la mejor memoria es la que menos reescribe. Cada etapa que reformula un hecho es una oportunidad de perderlo, y la consolidación vuelve permanentes esos errores.
La segunda: un validador revisa forma, no verdad. Mis reglas detienen nombres inventados y valores perdidos; no detienen que “Pagora” pase de empresa a ciudad. Para eso hace falta algo que entienda la frase, y en este sistema eso es justamente el modelo pequeño que se equivocó.
La tercera: arreglar una pieza puede exponer el error de otra. El “Te llamas Kiwi” estuvo ahí desde la primera corrida; el resumen del Selector lo tapaba por casualidad. Sin tres corridas por condición y sin reconstruir la memoria a mano, habría celebrado los 10 puntos de v2 sin ver lo que destaparon.
Nada de esto le quita mérito a LightMem. Me deja con más ganas de probar la pieza que no pude: un Selector afinado, que es exactamente donde el paper pone su apuesta. Gracias a sus autores por convertir en un trabajo serio una idea que muchos teníamos dando vueltas.
Puedes probar el agente en alexisalulema.com/projects: se provisiona cuando lo pides, corre 40 minutos y se destruye solo, con su memoria incluida. Cuéntale algo, pregúntale, pulsa 🌙 Dream y compara con el RAG. El código, con la bitácora completa de decisiones, mediciones y errores, está en github.com/alulema/dreaming-agent.
Si te dice que te llamas Kiwi, ya sabes por qué.