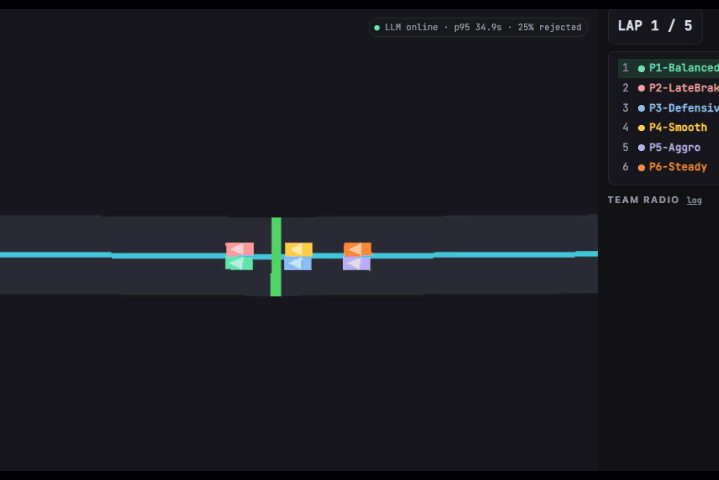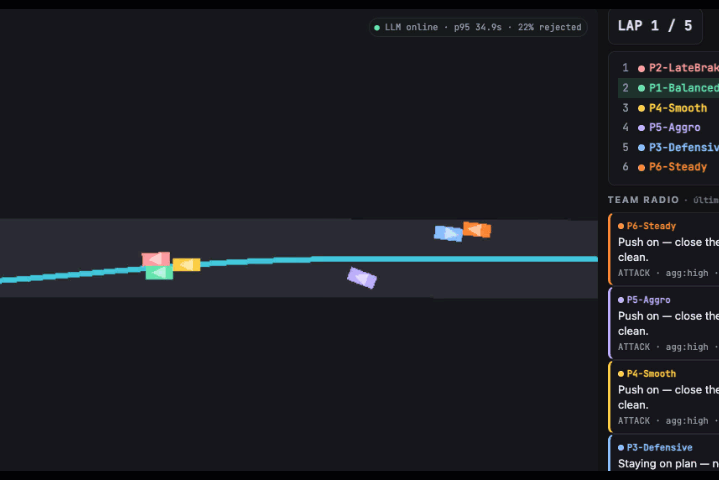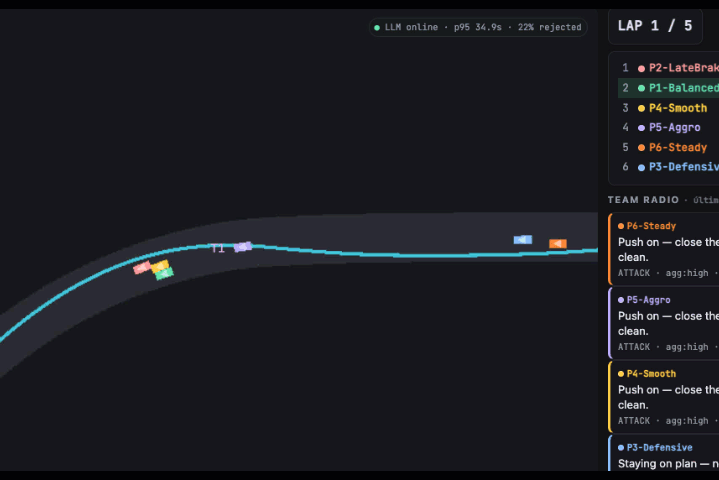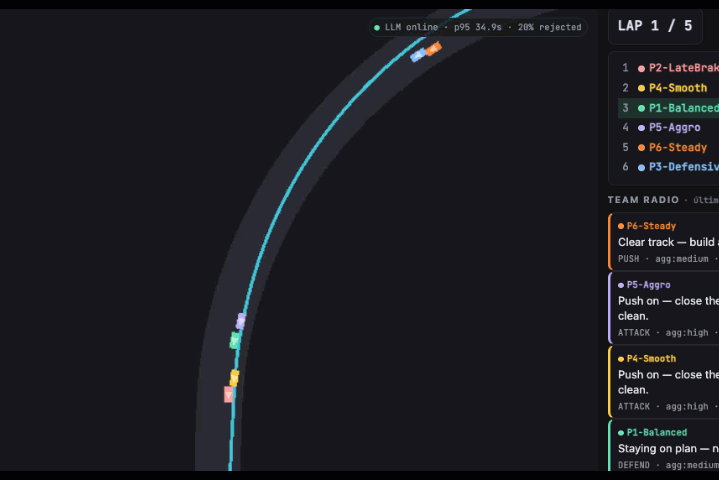
Construí un demo de carreras donde autos idénticos compiten en un circuito cerrado, cada uno con un piloto que reacciona cuadro a cuadro y un jefe de equipo en un LLM que razona por evento y le manda directivas de estrategia. Ocho intentos de entrenar el piloto con aprendizaje por refuerzo no funcionaron — la pista estaba rota antes que el algoritmo. El jefe de equipo sí funcionó, y un experimento sobre cuánto aporta terminó siendo más interesante que el demo en sí: siete corridas, dos sesgos de razonamiento reales y parcialmente corregibles, un cuello de botella de infraestructura, y una lección sobre confiar más en el benchmark completo que en el test rápido de escritorio.
Siempre me ha llamado la atención el desarrollo de videojuegos, en particular Unity y toda la industria que se mueve alrededor de él. No tuve la oportunidad de entrar en esa industria — otros caminos, otros contratos — pero con los asistentes de código actuales eso se vuelve alcanzable de una forma que hace un par de años no lo era. Le pedí a Claude Code que se hiciera cargo de casi todo el lado de Unity, que no es mi fuerte, y me quedé yo con las decisiones de diseño y con la parte que sí me interesa de verdad: qué pasa cuando le das a un agente autonomía real sobre otra pieza del sistema.
Porque el gancho no era “hacer un juego”. La idea concreta viene de la Fórmula 1, de verla de chico sin pensar todavía en nada de esto: lo que más me llamaba la atención no era el auto ni el piloto, era la radio del equipo. El estratega en el muro de boxes ve la carrera completa — clasificación, gaps, la pizarra de tiempos, el plan de toda la carrera — y le manda al piloto una instrucción corta y específica: ataca ahora, cuida el neumático, defiende la posición. El piloto no ve nada de eso; va a 300 km/h reaccionando a lo que tiene diez metros adelante, sin margen para pensar en la estrategia general. Dos niveles, dos ritmos, un canal angosto de comandos entre uno que reacciona y otro que razona. Até esa imagen a los LLMs mucho después, pensando en cómo razonan con todo el contexto a la vista en vez de reaccionar a un dato a la vez: el estratega de boxes ya es, en el fondo, exactamente eso — ve el cuadro completo y da una instrucción de alto nivel, sin tocar el volante él mismo.
Y últimamente ando metido en comunicación agentic — MCP, A2A, y en general qué tan lejos se puede llevar la idea de agentes que se coordinan entre sí, incluso agentes que guían a dispositivos “tontos” (tengo en la cabeza un experimento con un ESP32 para más adelante). El patrón del muro de boxes es exactamente ese: un canal angosto de comandos entre algo simple y algo que piensa. Este demo es un ensayo de esa idea con un volante y seis autos, antes de intentarlo con hardware de verdad.
Un piloto que nunca aprendió a manejar
El plan inicial era razonable en el papel: un circuito cerrado corto —así un episodio de entrenamiento es una vuelta, no la carrera completa— con raycasts, velocidad y ángulo respecto a la trazada ideal como observaciones, PPO como algoritmo, y una recompensa por progreso con penalización por salirse o chocar.
Corrí ocho iteraciones completas, cada una de 6 a 10 millones de pasos, tocando en cada vuelta una variable distinta: la forma de la recompensa (siete versiones distintas), una heurística de referencia que usaba solo para diagnosticar (ocho versiones), el radio de las curvas, la geometría de los muros —probé malla en cero, cajas, sólido extruido—, el punto de spawn, el modelo de agarre lateral. El número que me importaba, cuánto de una vuelta completaba un auto sin salirse, no se movió de un 10-13% en ninguna de las ocho.
Lo que rompió el estancamiento no fue tocar el algoritmo. Fue la heurística de diagnóstico, que en la misma pista y con la misma física llegó al 82% de una vuelta a 21 m/s sostenido. Mismo entorno, un método lo resuelve razonablemente bien y el otro se queda estancado en un décimo de eso — ahí dejó de tener sentido seguir pensando que el problema era la recompensa.
El cambio que sí movió algo fue reformar la recompensa de velocidad para que tuviera un pico, no una pendiente. Antes, más velocidad siempre sumaba puntos — así que frenar para una curva era puro costo, nunca beneficio, y el agente aprendía exactamente eso: no frenar nunca. La reforma calcula una velocidad objetivo según la curvatura que viene —
donde es el mayor cambio de rumbo de la pista en los próximos 30-55 metros— y premia acercarse a ese objetivo, no superarlo:
Con esto frenar antes de una curva cerrada deja de ser puro costo — hay una zona donde vale más frenar que no frenar. Subirle además anticipación al agente (las mismas observaciones de curvatura hacia adelante que usaba la heurística en ) le subió el valor de la recompensa un 40%, pero el porcentaje de vuelta no se movió: el agente seguía sin descubrir la maniobra de curva —frenar, girar, acelerar, una secuencia coordinada de uno o dos segundos— porque el 97% de los intentos morían antes de esos dos segundos. Exploración difícil, no una recompensa mal diseñada.
Las ocho corridas usaron PPO de punta a punta; lo que cambiaba entre una y otra era la recompensa, la percepción del agente o la física, nunca el algoritmo en sí. Antes de la última, probé imitación desde la heurística como puente —grabé demostraciones y mezclé behavioral cloning con GAIL— pero la ganancia fue chica, así que la corrida final volvió a ser PPO limpio, sin ese andamiaje, para tener una lectura clara de si el algoritmo por sí solo alcanzaba. No llegué a probar curriculum learning ni una red más grande — quedaron anotados como el siguiente paso si esto no funcionaba, pero el proyecto se descopeó antes de esa iteración.
En paralelo había una segunda variable contaminando todo el experimento sin que yo lo supiera: las pistas generadas de forma procedural tenían geometría rota en varios tramos, curvas que honestamente ni una persona hubiera podido tomar bien.
Cuando cambié a un circuito fijo simple —un óvalo con esquinas redondeadas, sin generación procedural de por medio— la heurística corrió limpia, sin un solo choque ni bloqueo en nueve autos a la vez, y completó la vuelta entera una vez que le di margen de tiempo suficiente. La “parálisis” que había dominado los ocho intentos de RL —autos que se frenaban a media pista y se quedaban clavados ahí— era en buena parte un problema del generador de pistas, no un fallo de fondo del controlador físico del auto. Había estado cazando un bug de aprendizaje que en realidad era, al menos en parte, un bug de geometría.
Con esa señal sobre la mesa, y con el tiempo del proyecto corriendo, decidí no seguir persiguiendo RL. El demo es sobre el circuito piloto-estratega, no sobre tener el mejor piloto de carreras posible, y para demostrar ese circuito no hace falta una red neuronal manejando — hace falta un piloto cuyo comportamiento cambie de forma observable según la directiva que reciba. Una heurística escrita a mano, con el freno más tardío cuando la agresividad es alta, un sesgo de línea según ataque o defensa, y tolerancia a proximidad según el riesgo aceptado, cumple ese requisito igual de bien — y corre en el cliente sin necesitar exportar ningún modelo ni pagar el costo de inferencia por auto dentro del navegador.
Forzando la directiva a distintos valores sobre el circuito fijo, el mismo piloto heurístico completó la vuelta en 79 segundos en modo agresivo y en 112 en modo conservador — un 40% de diferencia cambiando solo dos parámetros. El mecanismo detrás es un único mapeo, sin nada más disperso en el código: la agresividad de la directiva (0 a 1, un valor discreto que el estratega elige entre bajo/medio/alto) escala la velocidad objetivo de la curva anterior directamente —
— y el margen antes de frenar crece con ella igual de lineal, de 0.3 a 2.2 m/s de sobrante permitido sobre el objetivo. Es justo la superficie de escritura que necesitaba el estratega, y llegó por un camino que no tenía nada que ver con el que había planeado.
El intento de RL no fue tiempo tirado: dejó un pipeline de entrenamiento y un arnés de evaluación sólidos, y una lección que me quedó grabada — si vas a comparar dos métodos de control contra el mismo entorno, valida primero que el entorno en sí sea navegable con un método simple de referencia, antes de gastar cómputo persiguiendo hiperparámetros de un método sofisticado.
Una nota técnica al margen, porque la información pública sobre esto es escasa: correr una red neuronal dentro de un build WebGL, en el navegador, sin GPU, con la Inference Engine de Unity, funcionó sin sobresaltos. Un modelo de juguete cargó y corrió con el backend de CPU en 3.4 ms en frío y 0.1 ms en caliente por inferencia — con seis autos haciendo inferencia por frame eso son 0.6 ms/frame, un presupuesto perfectamente cómodo a 60 fps. Si el RL hubiera funcionado, esta pieza no habría sido el problema.
El jefe de equipo que sí razona
El estratega es un LLM local —llama3.2:3b, servido por un sidecar Ollama sin GPU, sin
API externa— decisión deliberada: sin factura por token, sin depender de un proveedor.
Cada auto tiene su propio estratega, independiente de los otros cinco. Ve la
clasificación completa, los tiempos de vuelta, el mapa del circuito con las curvas
numeradas, su propia bitácora de vueltas anteriores — pero nada cuadro a cuadro, y nada
sobre lo que va a pasar en los próximos segundos. La respuesta llega de forma asíncrona;
la carrera nunca la espera, y si se atrasa, simplemente llega tarde, como el muro de
boxes real.
Para poder decir algo más que “se ve bien”, monté un experimento de campo mixto: de seis autos en la misma carrera, tres llevan estratega LLM y tres llevan una directiva heurística fija, rotando la parrilla de salida y qué auto lleva qué motor entre carreras. Ahí la posición final sí significa algo, porque es un enfrentamiento directo bajo condiciones idénticas — comparar una carrera con todos los autos en modo LLM contra otra con todos en modo heurístico no mide nada, porque dentro de una sola carrera la posición es de suma cero y alguien gana en ambos casos igual.
Corrí esa comparación siete veces, 18 carreras por corrida, y cada una respondió una pregunta distinta.
La primera pista: hay un efecto, y es grande. El grupo heurístico terminaba en promedio en la posición 2 de 6; el grupo LLM, en la posición 5. Consistente, sin excepción, en los seis pilotos de la población. Instrumentando decisión por decisión, no solo el resultado de cada carrera, la causa apareció clara: filtrando a respuestas realmente frescas del modelo, elegía baja agresividad y bajo riesgo casi la mitad de las veces, mientras que la heurística fija nunca elige “bajo” en ninguno de esos dos canales. El prompt original le daba al modelo una excusa ficticia para ir lento: le pedía “conservar” pensando en desgaste de neumáticos y combustible que, en esta simulación, sencillamente no existen. Un segundo hallazgo que no esperaba: solo el 42% de las decisiones de los autos LLM eran respuestas frescas — el resto caía en un modo de respaldo por saturación del proxy, no por error del modelo.
Un prompt corregido, y el sesgo cede. Reescribí las reglas del sistema: eliminé la excusa del desgaste, agregué umbrales explícitos atados a la telemetría real —rival a menos de 1.5 segundos, ataca; alguien encima tuyo, defiende; pista despejada, empuja— y un recordatorio directo de que no había costo mecánico en ir rápido. Medido sobre decisiones frescas, baja agresividad/bajo riesgo cayó del 47% al 0.3%, y el tiempo perdido contra el líder bajó un 60%. Pero la posición final apenas se movió, porque la fracción de decisiones frescas no mejoró — seguía cayendo casi todo en el mismo respaldo de antes por saturación del proxy.
Aflojar la concurrencia, y empeora. Con un solo motor Ollama sirviendo una petición a la vez por diseño, subí el límite de llamadas admitidas por el proxy de 1 a 3, sin tocar el motor. El resultado fue peor: la fracción de respuestas frescas cayó a menos de una de cada diez. Antes, el respaldo era un rechazo instantáneo cuando no había turno libre; ahora, dejar pasar más peticiones hacia un motor que seguía siendo de un solo hilo las hizo esperar en cola real, algunas superaron el umbral de latencia del cortacircuitos, y cada disparo apagaba el sistema entero 60 segundos. Aflojar la puerta de entrada sin aflojar el cuello de botella real no gana nada; solo cambia el tipo de fallo, y el nuevo es peor.
Un segundo motor, en la máquina equivocada. La palanca correcta, en teoría, no es un número más grande en el semáforo sino un segundo motor Ollama independiente — real paralelismo en vez de más cola detrás de uno solo. Construí esa pieza: un container sidecar solo con Ollama, opcional, con un reparto de turnos en el proxy que garantiza que dos llamadas concurrentes nunca terminen atadas al mismo motor. Lo validé aislado — tres llamadas concurrentes contra dos motores, exactamente dos consiguieron turno, nunca las dos en el mismo— y después corrí las 18 carreras completas con el sidecar activo en la misma máquina. El resultado no cambió en nada: mi laptop de desarrollo tiene ocho núcleos físicos en total, y los dos containers Ollama compiten por ellos junto con el navegador renderizando el circuito. Un segundo motor local no le suma cómputo real al sistema — le suma demanda sobre el mismo cómputo fijo que ya había, el mismo problema de fondo que la corrida anterior, solo que repartido entre dos procesos en vez de encolado en uno. El mecanismo de reparto quedó demostrado correcto; la ganancia de capacidad todavía no, porque esa ganancia solo existe si el segundo motor recibe cómputo genuinamente adicional.
Un segundo motor, en la máquina correcta. Tenía una MacBook M1 en la misma red.
Publiqué una variante multi-arquitectura de la imagen del sidecar (mismo peso, corriendo
nativo en arm64, no traducido) y la levanté ahí — CPU física, separada de verdad de mi
máquina de desarrollo. El cambio fue inmediato: el modelo tardó 7 segundos en calentar en
vez de 20, y la fracción de respuestas frescas del estratega saltó de menos de uno de
cada diez a 57%, la muestra más grande de todo el experimento. El mecanismo
funcionaba — solo necesitaba cómputo real detrás, no una promesa de cómputo.
Y sin embargo la posición final no mejoró. De hecho fue la peor de las últimas cuatro corridas.
Por qué el estratega prefiere defender
Con tanta frescura de respuesta por primera vez, pude comparar de verdad qué elige el LLM contra qué elige la heurística en el mismo tipo de situación. Filtrando ambas al evento más común (un incidente — contacto, roce, un momento de vulnerabilidad), la heurística elige atacar el 60% de las veces y defender el 38%. El LLM, en el mismo tipo de evento, invierte casi exactamente esa proporción: defender 69%, atacar 26%. No es un artefacto de qué dispara la llamada — es una lectura distinta de la misma situación.
Antes de escribir una hipótesis, lo probé en vivo. Armé una telemetría de manual: un rival cuatro segundos por delante, estable, ninguna amenaza; otro rival ochocientos milisegundos por detrás — un caso de “ataca” tan inequívoco como se puede construir. Cinco veces seguidas, con el mismo prompt, el modelo respondió “defend” las cinco. En una de las respuestas hasta reconoció, en su propia frase de radio, que el auto de adelante “está estable” — y aun así decidió protegerse de él en lugar de ir a buscarlo.
El modelo no está comparando dos números y actuando sobre el más chico, que es literalmente lo que el prompt le pide. Está haciendo algo más parecido a reconocer un patrón y completarlo: la sola presencia de un rival cerca, en cualquier posición, parece activar un marco de “cuidado” antes que un marco de “oportunidad” — el mismo tipo de sesgo hacia lo defensivo que ya habíamos encontrado (y arreglado) a nivel de agresividad/riesgo, reaparecido un nivel más arriba, en la elección de la directiva misma, donde el ajuste anterior nunca lo tocó.
Un segundo ajuste, y esta vez el test aislado miente
Reescribí el prompt otra vez: una instrucción explícita contra defender por defecto, la
comparación entre los dos gaps expresada como una resta directa en vez de dos reglas
independientes, y una corrección de un bug relacionado que encontré de paso —
target_rival a veces apuntaba al auto equivocado bajo “defend”.
Repetí el mismo experimento controlado. El caso más inequívoco —el de los cinco “defend” seguidos— seguía sin ceder ni una vez. Descorazonador: parecía que había tocado un límite real del modelo, no de la redacción.
Corrí las 18 carreras de todos modos, porque cinco muestras de un escenario artificial no son evidencia suficiente para nada. Y ahí el resultado fue otro: el gap de posición se achicó un 23%, el gap de tiempo contra el líder un 36%, y la proporción de “attack” en decisiones frescas subió de un cuarto a un tercio. Una mejora real, medida sobre cientos de decisiones en contextos variados — el mismo ajuste que mi test de escritorio había declarado un fracaso.
La explicación, pensándolo después, es simple: el escenario que armé a mano era casi adversarial —un solo rival, un solo eje de comparación, sin nada más en la telemetría— exactamente el tipo de caso límite donde un modelo chico tropieza más seguido. La variedad real de una carrera —dos rivales, notas de vueltas anteriores, un evento distinto cada vez— le da al modelo más anclas de las que mi prueba de escritorio le daba. Un test aislado con cinco muestras y un modelo con temperatura midió una cosa; un benchmark de cientos de decisiones en contextos reales midió otra. Cuando difieren, hay que creerle al segundo — es el que se parece al problema real.
El sesgo hacia defender no desapareció del todo. Sigue habiendo una brecha real de estilo con la heurística, incluso en el mejor caso medido. Pero se movió, con datos que lo confirman antes y después, igual que el sesgo original de agresividad — y ese residuo que queda, ya sin infraestructura ni prompt a quién culpar, es probablemente el límite honesto de lo que un modelo de 3B aporta como estratega en este dominio.
Lo que me llevo
Tres ideas se repitieron más de lo que esperaba, y sospecho que van a repetirse en cualquier próxima cosa que construya con agentes.
La primera: valida el entorno con un método simple antes de gastar cómputo en el método sofisticado. Buena parte del estancamiento de ocho corridas de RL no era del algoritmo — era una pista que al principio ni una heurística de diagnóstico podía tomar bien. Correr esa heurística primero me habría ahorrado semanas.
La segunda: un resultado agregado sobre un sistema con restricciones reales de cómputo casi siempre mezcla dos preguntas distintas —¿el agente razona bien?, y ¿tuvo la oportunidad de mostrarlo?— y separarlas exige instrumentar la decisión individual, no solo mirar el resultado final. Es exactamente el tipo de cosa que quiero tener resuelta antes de intentar algo parecido con un agente guiando un dispositivo real y “tonto” — ahí la pregunta de “¿tuvo la oportunidad de responder a tiempo?” no es un detalle de infraestructura, es la mitad del problema.
La tercera, la que más me sorprendió: un test aislado y un benchmark completo pueden apuntar en direcciones opuestas, sobre todo con un sistema que tiene algo de aleatoriedad. El primero sirve para diagnosticar y para armar una hipótesis rápido; el segundo es el que de verdad mide lo que importa. Confundir uno por el otro — declarar un arreglo fallido porque cinco muestras de un caso extremo no cambiaron, sin correr el experimento completo — casi me hace descartar un ajuste que sí funcionaba.
El código completo, la bitácora día a día y los siete datasets crudos de este experimento están en github.com/alulema/agentic-racing. Lo próximo, si el ESP32 coopera, tiene menos volante y más cables.