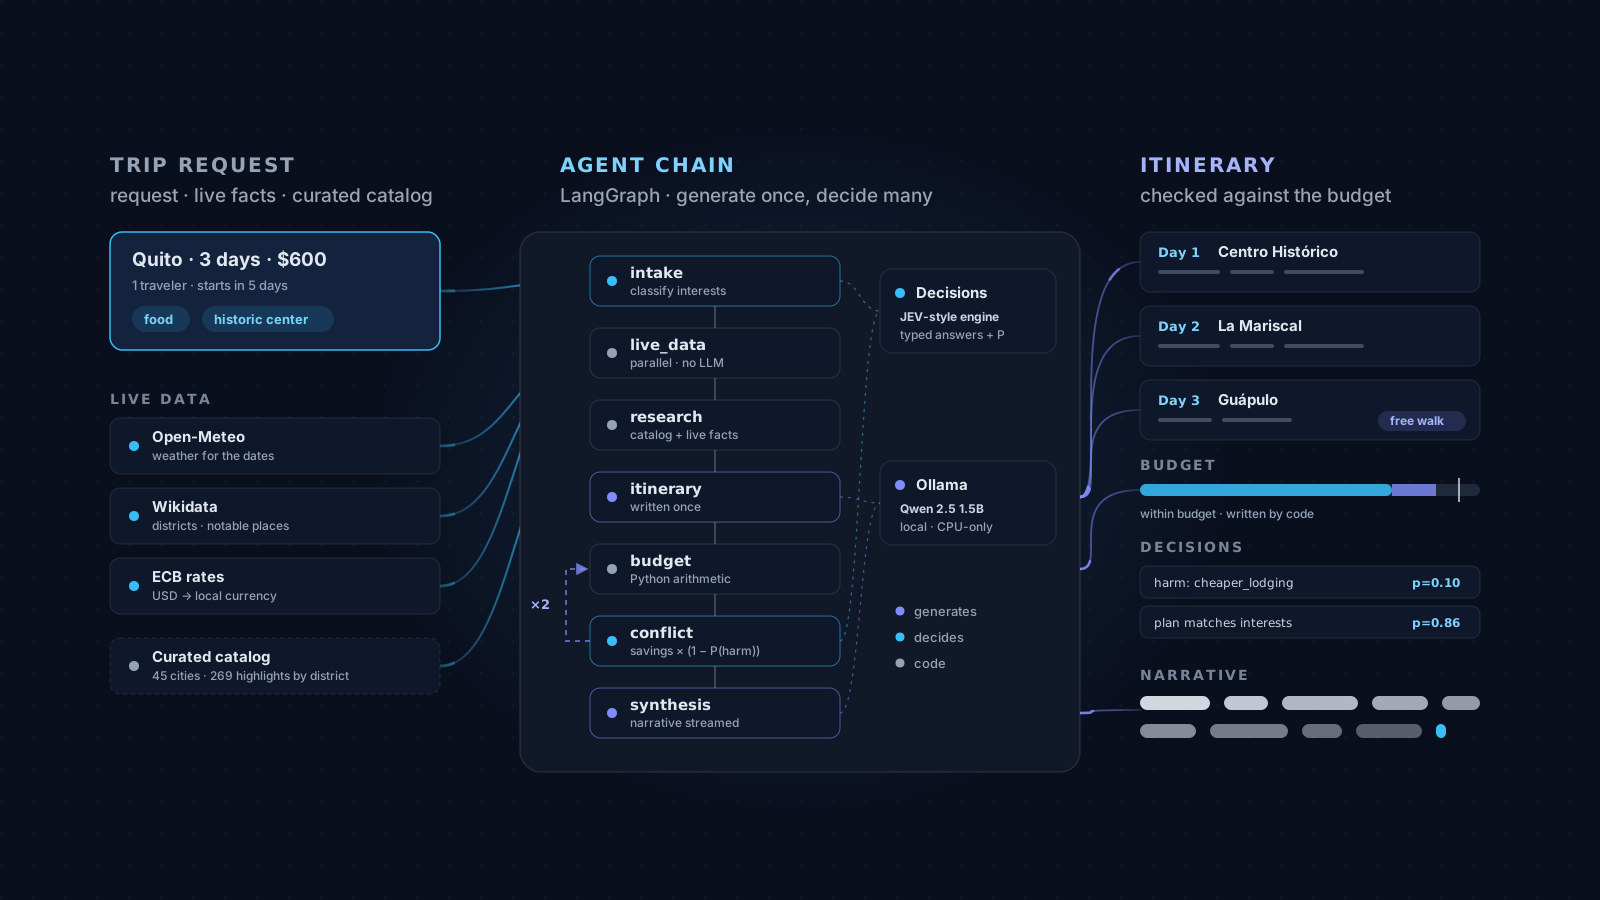
Un libro que me resultó interesante y entretenido de leer ha sido el de Imran Ahmad, 30 Agents Every AI Engineer Must Build. En el capítulo 7, el que habla sobre Chain-of-Agents, usa un planificador de viajes para explicar el patrón, y lo hace de una manera bastante educativa: un orquestador que no hace trabajo de dominio, especialistas que se pasan el trabajo, una memoria compartida y un mecanismo para cuando dos resultados no cuadran. La idea me gustó, y me embarqué en desarrollarla con uno de esos patrones como base, usando algunos conceptos que difieren del libro y que resuelven algunos pendientes del demo de Mr. Ahmad.
El pendiente que más me llamó la atención fue el conflicto. En el código que acompaña al capítulo el conflicto se detecta: se calcula un puntaje, se compara contra un umbral y el reporte recomienda investigar más. El arbitraje, el consenso y la renegociación quedan en el texto del libro. Los especialistas, además, devuelven datos simulados. Es lo razonable para un notebook didáctico que cubre tres patrones en pocas celdas, pero me dejó con la pregunta que me interesaba de verdad: ¿qué pasa cuando el conflicto hay que resolverlo, con un modelo real que se equivoca y datos reales que a veces no llegan?
El resultado es un demo donde escribes algo como “Quito, 3 días, $600, comida y centro histórico” y miras, en vivo, cómo una cadena de agentes arma el itinerario: qué agente trabaja, qué decide, con qué probabilidad, dónde aparece un conflicto de presupuesto y cómo la cadena lo resuelve sin que intervenga nadie. El itinerario bonito no es el punto. El punto es que la orquestación se vea.
Y lo mismo que dije en posts anteriores: lo construí junto con un asistente de código, en sesiones largas de decisiones y mediciones, con una bitácora que registra cada problema y cómo se resolvió.
Las restricciones definieron el diseño (otra vez)
Este demo vive en la misma infraestructura efímera que los anteriores, así que heredó sus reglas antes de escribir una línea:
- Sin API de pago. LLM local, servido por Ollama. Nada de facturas por token.
- CPU only, 2 vCPU / 4 GiB para todo el pod, incluido el modelo.
- Sin estado. El entorno puede morir en cualquier momento.
- Un modelo pequeño y abierto. Evalué Qwen, Llama y Phi, y me decidí por Qwen 2.5 1.5B.
Un modelo de 1.5B en dos núcleos es lento y se equivoca en hechos. Esa combinación diseñó todo lo demás.
JEV: razonar sin generar
Una de las ideas que quise incluir en este proyecto fue JEV, de TypeSafe, que ha sido publicado recientemente (en acceso anticipado desde el 15 de septiembre). Es lo que ellos llaman un modelo System One: en vez de generar texto token a token, recibe el estado de un programa y un conjunto de preguntas cuya forma declaras de antemano —qué campos quieres y qué valores puede tomar cada uno— y devuelve esas respuestas llenas, cada una con su probabilidad. Me pareció interesante incluir la capacidad de razonamiento sin tener que incurrir en generación para la respuesta, sino en un array de respuestas definidas. Si la respuesta solo puede ser una de cuatro opciones, no hay forma de que invente una quinta.
El problema fue práctico: JEV es una API alojada, en acceso anticipado con lista de espera y sin opción de correrlo localmente, así que no cumplía la regla de “todo local”. La solución fue quedarme con la forma y dejar el motor intercambiable. El demo define una interfaz con la forma de JEV: estado más preguntas tipadas, que devuelven respuestas con probabilidades.
TypedQuestion(
    id="harm:cheaper_lodging",
    family="action_harm",          # para despachar reglas
    kind="score",                  # "choice" con opciones, o "score" -> P(sí)
    text="¿Bajar la categoría del alojamiento daña los intereses del viajero?",
    params={"action_id": "cheaper_lodging"},
)
# -> Answer(value=0.1, probabilities={"yes": 0.1, "no": 0.9}, source="rules")
Hoy la implementa un motor por reglas: una taxonomía de palabras clave en español e inglés y
heurísticas explícitas. Es determinístico, instantáneo y funciona sin red. Cada pregunta lleva un
family para las reglas y un text en lenguaje natural, que es exactamente lo que evaluaría JEV. El
día que tenga acceso, enchufarlo es implementar un método.
(Confieso que escribiendo esto volví a pensar en Agentic Racing. Al final, el jefe de equipo solo elegía entre atacar, defender o empujar, con agresividad baja, media o alta. Un piloto no necesita un párrafo por radio: necesita una de tres palabras, y rápido. Ya veremos.)
Generar una vez, decidir muchas
La primera versión regeneraba el itinerario en cada ronda del conflicto de presupuesto. En CPU, eso eran varias salidas JSON largas por viaje, y no cabía en un tiempo razonable. De ahí salió el principio que ordena todo el proyecto: cada paso usa el mecanismo más barato que lo resuelve bien.
| Paso | Mecanismo |
|---|---|
| Intake: clasificar cada interés | Decisión tipada |
| Datos en vivo: clima, lugares, tipo de cambio | APIs públicas, sin LLM |
| Investigación del destino | Catálogo curado + datos en vivo (con suerte, 0 tokens) |
| Itinerario | Generación, una sola vez |
| Presupuesto | Aritmética en Python |
| Resolución de conflictos | Decisiones tipadas + aritmética |
| Revisión del itinerario | Código, sin regenerar |
| Síntesis | Generación (la narrativa) + código (las cifras) |
El modelo escribe dos veces por viaje; todo lo demás es una decisión o una cuenta. Un viaje completo consume entre 850 y 1.200 tokens, contra un tope de 6.000, y tarda de 25 a 45 segundos con los límites del pod. El ciclo de conflicto consume cero.
Resolver el conflicto, no solo detectarlo
Aquí está lo que quería construir desde que leí el capítulo. Cuando el total excede el presupuesto, el agente de conflictos no le pide al modelo “haz el viaje más barato”. Tiene un catálogo fijo de acciones: cambiar actividades de pago por paseos gratuitos, bajar la categoría del alojamiento, comer en mercados, comprar un pase de transporte. Para cada una:
- El código calcula cuánto ahorra. Es aritmética sobre los supuestos de costo del itinerario.
- El motor de decisiones estima cuánto daña los intereses del viajero, como una probabilidad. A quien pidió museos, los paseos gratuitos le hacen más daño que a quien pidió caminar.
- El código elige por
ahorro × (1 − P(daño)), aplica los cambios al itinerario y vuelve a presupuestar.
El ciclo tiene un tope duro de dos iteraciones. Si después de eso el viaje sigue sin caber, el resultado lo dice. Lisboa para dos personas con $50 es mi caso de prueba favorito: dos rondas de recortes, paseos gratuitos en cada barrio, y un veredicto honesto de que no alcanza. Un planificador que siempre dice que tu viaje cabe no es un planificador, es un vendedor.
Cada decisión aparece en el trace con su probabilidad.
Cuando el modelo no sabe dónde queda Shibuya
Los primeros viajes con el modelo real fueron educativos. Qwen 1.5B puso Shibuya, que está en Tokio, como barrio de Kioto. Inventó barrios en Hanói, un “Museo del Ámbito” que no existe, y le puso a Hanói precios más altos que a Lisboa.
Los prompts mejoraron los precios, pero no la geografía. Después corrí un benchmark de 1.5B contra 3B, con los mismos viajes y los mismos límites de CPU:
| Viaje | 1.5B | 3B |
|---|---|---|
| Kioto (catálogo) | 31 s | 71 s |
| Lisboa, $50 (catálogo) | 21 s | 68 s |
| Hanói (catálogo) | 25 s | 56 s |
| Valparaíso (solo modelo) | 23 s | 75 s |
El 3B tardó más del doble y no mejoró la geografía: puso Kinkaku-ji en Gion, “Ribeira” (que está en Oporto) en Lisboa, y “Paseo Alcorta” (que está en Buenos Aires) en Valparaíso.
Un prompt no le enseña a un modelo pequeño lo que no sabe, y un modelo un poco más grande tampoco. Los hechos que tienen que ser correctos se guardan como datos. El demo tiene un catálogo curado de 45 ciudades, cada una con tres barrios, y cada barrio lista las atracciones que están físicamente en él. El código decide qué barrio visita cada día y le pasa al modelo solo las atracciones de ese barrio, así que un templo no puede terminar en el día o en el barrio equivocado. Si el modelo devuelve otro barrio, la normalización impone el del plan. El modelo sigue escribiendo toda la prosa; lo que ya no decide es la geografía.
Pasó lo mismo con los recortes: el modelo escribía “Explore Alfama’s streets” en los tres días de Lisboa. La alternativa gratuita también pasó al código: “Paseo libre por Alfama: Miradouro de Santa Luzia”.
Lo honesto lo escribe el código
El bug que más me enseñó salió en el primer e2e con el modelo real. La narrativa final decía:
“You can expect to spend 50.”
La cadena había calculado bien que el viaje excedía el presupuesto. El modelo, al redactar el resumen, decidió lo contrario, con toda la seguridad de una frase bien construida. Es el mismo error que el chatbot RAG cometió con el Mundial: una garantía que depende de que un modelo de 1.5B tenga disciplina no es una garantía.
La solución fue partir la síntesis en dos. El modelo escribe la narrativa sin ver ningún número y con prohibición de hablar de dinero; un filtro en código elimina cualquier frase que lo haga de todos modos. El párrafo del presupuesto —total, recortes aplicados, si cabe o no— lo escribe el código. El e2e de CI falla si el resumen contradice el veredicto del presupuesto, así que la regla no depende de que yo me acuerde de revisarla.
El mismo filtro descarta frases que nombran lugares que no están en el plan (“Parque Lagoa”). Es una heurística con límites conocidos: “estación Kyoto Central” pasa, porque “Kyoto” es un nombre conocido.
LangGraph, solo para orquestar
La primera versión del orquestador era un bucle propio. Funcionaba, pero para mostrar el patrón,
un framework reconocible y un diagrama generado del grafo real valían la migración. El orquestador pasó a un StateGraph de LangGraph cuyo estado es la
memoria compartida misma:
- Un nodo por agente, que devuelve solo su sección; nunca muta el estado.
- Reducers para el trace y el conteo de tokens, así la memoria sigue siendo append-only.
- Ruteo en funciones de código, sin LLM: después del presupuesto, a conflicto si excede y quedan iteraciones; si no, a síntesis.
- Eventos en vivo por el stream
customde LangGraph, relayados al navegador por SSE.
LangGraph se usa solo para orquestar. El modelo se sigue llamando con un cliente Ollama propio, sin wrappers de LangChain. La prueba de que la migración salió bien fue aburrida, que es como deben ser estas pruebas: los 56 tests existentes pasaron sin cambios.
Datos en vivo: la API que no respondía
La última fase agregó hechos que cambian: el clima real de las fechas del viaje, el tipo de cambio a la moneda local y, para ciudades fuera del catálogo, barrios y lugares reales. Todo con fuentes gratuitas y sin API key: Open-Meteo, las tasas del Banco Central Europeo, Wikidata y OpenStreetMap. Ninguna es obligatoria: si una falla, la cadena sigue con catálogo o modelo y lo dice en el trace.
Para los lugares empecé con la API Overpass de OpenStreetMap. En cinco corridas del e2e en CI pasé por esto:
- La instancia pública respondió 504. Agregué una segunda instancia de respaldo.
- Las dos agotaron su timeout. Si fallan dos servidores independientes, el problema no es la carga, es la consulta: pedía nodos, vías y relaciones, y resolver la geometría de las relaciones es caro. La reescribí con una caja delimitadora y solo nodos y vías.
- Con la consulta liviana, otra vez 504 y timeout: unos 28 segundos extra por viaje.
- Cambié la fuente principal a Wikidata, con Overpass de respaldo. Respondió en 0,5 s.
Valparaíso pasó de barrios inventados por el modelo (“Casa Blanca”, “Playa de Coquimbo”) a lugares reales —la Catedral, el Museo a Cielo Abierto—, con 5 de 5 atracciones en su día, y el paso en vivo bajó de 28 a 1,3 segundos. Cuando una dependencia pública falla de forma consistente, cambiar de dependencia suele ser más barato que seguir negociando con ella.
Con el clima real apareció además un efecto que no esperaba: para las ciudades del catálogo, la nota del clima ahora la escribe el código con los números del pronóstico, y la investigación del destino dejó de generar. Cero tokens. Datos reales no solo hicieron el demo más honesto, lo hicieron más barato.
Lo que deliberadamente no hice
- Sin humano en el ciclo. El libro lo incluye en sus workflows, y es una carencia real frente al patrón. Para un demo público que quiere mostrar la resolución automática, lo dejé fuera.
- Sin precios reales de hoteles ni vuelos. Las APIs que los ofrecen piden key y acuerdo comercial. Clima y tipo de cambio son en vivo; los precios siguen siendo estimaciones.
- Sin JEV, todavía. La interfaz está lista; falta el acceso.
Conclusión
Mirando atrás, casi cada problema de este proyecto tuvo la misma solución: sacarle una decisión al modelo. La geografía pasó a un catálogo, el presupuesto a Python, la alternativa gratuita al código, las cifras del resumen al código, el clima a una API. Lo que quedó para el modelo es lo que un modelo de 1.5B hace bien: redactar prosa alrededor de hechos que ya son correctos.
Y ahí está, creo, lo que el patrón del capítulo 7 gana cuando sale del notebook. Un orquestador determinístico, una memoria compartida que solo crece y un conflicto que se resuelve con decisiones visibles no son solo una forma ordenada de coordinar agentes. Son la forma de saber qué parte del sistema está autorizada a inventar, y de que la respuesta sea “solo la prosa”.
El demo está disponible en alexisalulema.com/projects: se provisiona cuando lo pides, corre unos minutos y se destruye solo. El código, con la bitácora completa de decisiones, mediciones y errores, está en github.com/alulema/trip-planner.
Si JEV me da acceso, este post va a tener segunda parte.