Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema
- Parte 6 · ¿Cómo le decimos a un agente qué queremos? Reward engineering explicado desde cero (este artículo)
Dónde nos quedamos
Las partes 3, 4 y 5 hablaron de imitación: BC, GAIL y cómo combinarlos con PPO. En las tres hubo que advertir lo mismo: en Agentic Racing esas técnicas se configuraron, pero nunca se ejecutaron.
Esta parte es distinta. La recompensa sí existe, está en el código, y tiene historia: ocho corridas de entrenamiento con PPO y, según la bitácora, siete variantes de la recompensa entre la primera y la última. La parte 1 mostró la versión final y contó el atajo más famoso del proyecto. Aquí la usamos como caso de estudio para la pregunta de fondo:
¿Cómo convertimos lo que queremos en una señal que una máquina pueda optimizar?
Y hay una deuda pendiente. La parte 5 terminó con un hallazgo incómodo: la recompensa del proyecto no lee las directivas del estratega, que son la razón de ser del piloto. Volveremos a eso al final, con una propuesta.
La honestidad de siempre: ninguna versión de esta recompensa produjo un piloto que diera vueltas de forma consistente. Parte de lo que este artículo cuenta es justamente por qué.
1. El agente optimiza la señal, no la intención
En la parte 1 vimos que el agente no maximiza la recompensa de un paso, sino el return, la suma descontada de las recompensas futuras:
En Agentic Racing, por decisión, y el agente decide 10 veces por segundo.
La idea central de este artículo cabe en una línea:
El agente optimiza la señal que definimos, no la intención que teníamos en la cabeza.
Si la recompensa representa mal el objetivo, el agente puede aprender una estrategia excelente según la fórmula y decepcionante para nosotros. No porque “haga trampa”: simplemente hace lo que le pedimos, con más rigor que nosotros al pedirlo.
2. De un objetivo humano a una lista de términos
El objetivo de Agentic Racing, dicho en palabras, era algo así:
Dar la vuelta al circuito rápido, sin salirse de la pista, sin chocar y sin quedarse parado.
La recompensa final lo tradujo en nueve componentes (la tabla completa está en la sección 6 de la parte 1), más las condiciones de fin de episodio. Agrupados, sin pretender una correspondencia exacta, por la parte del objetivo que intentan representar:
| Parte del objetivo | Términos de la recompensa |
|---|---|
| dar la vuelta | progreso por metro, bono por vuelta completa |
| rápido | velocidad objetivo por segundo, bono extra por vuelta rápida |
| sin salirse | cercanía al borde, salida de pista |
| sin chocar | golpe contra el muro |
| sin quedarse parado | lentitud, detenido, fin por falta de progreso |
| en el sentido correcto | fin por ir en sentido contrario |
| conducir bien | seguir la trazada ideal |
Cada fila es una decisión de diseño, y cada peso es una afirmación sobre prioridades: “un metro de progreso vale 0.02”, “salirse vale −1”. Ninguna de esas cifras viene de la física ni del objetivo; las elegimos nosotros. La pregunta es qué dicen cuando se miran juntas.
3. Escalas: qué dice cada término en una vuelta completa
El primer ejercicio útil es sumar. Tomemos el circuito fijo del proyecto (unos 2 km) y una vuelta de unos 95 segundos (la bitácora estima ese ritmo; el piloto heurístico midió 100 s con directivas aleatorias). Con las constantes del código, esto es lo máximo que cada término podría pagar en esa vuelta:
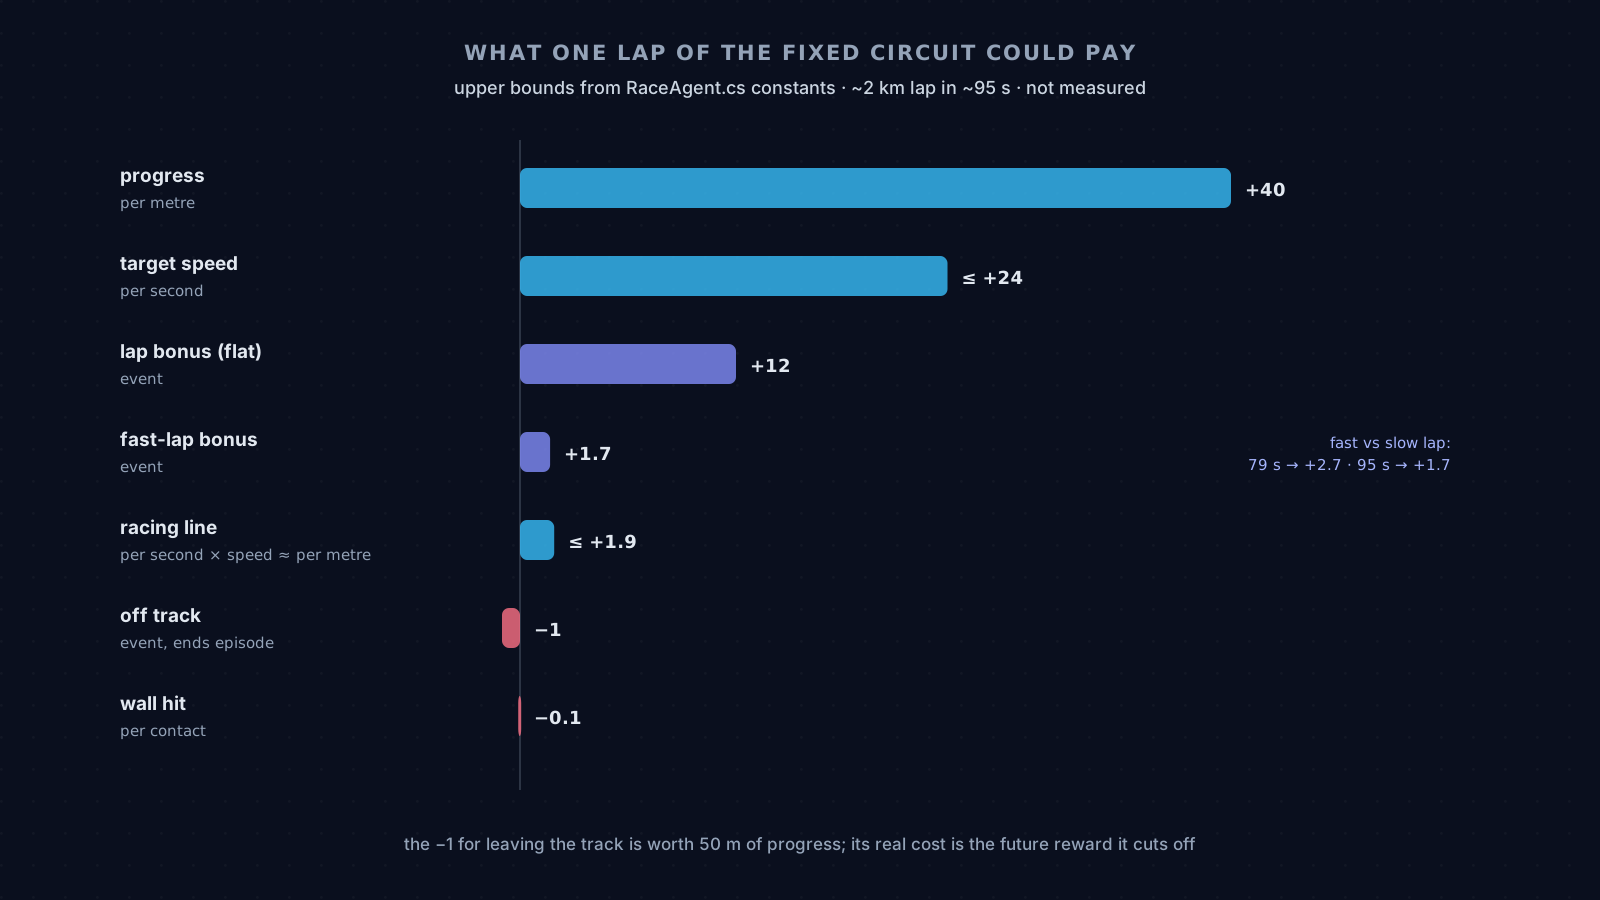
Una advertencia: son cotas calculadas a partir de las constantes, no mediciones. Ninguna policy de RL llegó a dar esta vuelta; el circuito fijo llegó después de la última corrida de entrenamiento.
Aun así, la suma dice cosas que la tabla de pesos no dice:
- El progreso domina. Unos 40 puntos por vuelta, casi tanto como todo lo demás junto.
- “Rápido” casi no está en la recompensa. El bono por vuelta rápida escala con el tiempo que sobra del límite del episodio (120 s). Una vuelta de 95 s cobra unos +1.7; una de 79 s, unos +2.7. Dieciséis segundos de diferencia valen un punto, en una vuelta que puede pagar hasta unos 80.
- La trazada ideal es casi decorativa. Menos de 2 puntos por vuelta, sea cual sea el tiempo: como se multiplica por la velocidad del auto, en la práctica paga por metro.
- Salirse cuesta lo mismo que 50 metros de progreso. Visto así, −1 es poco. Pero su costo real no es el −1: es todo lo que el agente deja de cobrar en el resto de la vuelta. Volveremos a esto en la sección 6.
Este ejercicio también apareció a la mala en el proyecto. Después de la segunda corrida, la bitácora anota que los términos de velocidad y de trazada recién agregados eran, por paso, entre 10 y 30 veces más chicos que el de progreso y unas 1000 veces más chicos que la penalización por salirse. Estaban en la recompensa, pero no pesaban.
La documentación de ML-Agents da una regla de escala concreta: la recompensa entre dos decisiones debería estar en el rango , porque valores mayores pueden desestabilizar el entrenamiento. La salida de pista la respeta. El bono de vuelta, de 12 a 20 en una sola decisión, no. En la práctica casi no importó, por una razón peor: el agente casi nunca llegaba a cobrarlo.
4. Recompensas escasas y densas, con números
Una recompensa escasa solo paga cuando ocurre el objetivo: por ejemplo, +1 al completar la vuelta y nada más. Una densa paga pequeñas cantidades a lo largo del camino, como el progreso por metro.
La escasa está más cerca del objetivo. El problema es si el agente puede verla. Con y una vuelta de unas 950 decisiones, un premio al final de la vuelta, visto desde la salida, pesa:
menos del 1% de su valor. Y eso suponiendo que el agente llegue a la meta alguna vez, que es justo lo que no pasaba: de la cuarta a la octava corrida, solo entre un 2% y un 4% de los episodios terminaban con la vuelta completa. La bitácora de la segunda corrida lo resume con una frase: el bono de vuelta era “peso muerto”.
Por eso la recompensa del proyecto es densa. Lo más probable es que el progreso por metro sea lo que le enseñó al agente el primer 10% de la vuelta: arrancar, ir hacia adelante, no salirse en la primera recta.
Pero cada término denso es un incentivo nuevo, y la pregunta útil no es “¿escasa o densa?”, sino:
¿La señal intermedia ayuda al agente a descubrir el objetivo final, o le enseña un objetivo distinto?
5. Unidades: por metro, por segundo, por evento
Los términos de la recompensa no se miden en las mismas unidades, y eso cambia lo que significan.
- Por metro (el progreso): paga lo mismo por un metro, se recorra en un segundo o en diez. No depende de la duración del episodio.
- Por segundo (velocidad objetivo, borde, lentitud, detenido): paga más cuanto más tiempo dure la situación. Un término positivo por segundo es, en el fondo, un premio por seguir vivo.
- Por evento (vuelta, salida, golpe): paga una vez, cuando algo pasa.
(La trazada es un caso intermedio: se calcula por segundo, pero multiplicada por la velocidad, así que en la práctica paga por metro.)
Una consecuencia buena del diseño: como los términos por segundo se multiplican por la duración del
paso de física, no cambian si se cambia la frecuencia de simulación. No todo es así: el límite del
episodio, la cadencia de decisiones (y con ella ) y el bono por vuelta rápida se cuentan en
pasos. Una consecuencia menos visible: el bono por vuelta rápida depende del límite de pasos del episodio, MaxStep. Cuando
el proyecto pasó al circuito fijo, ese límite subió de 4000 a 6000 pasos (de 80 a 120 segundos), porque
con 80 segundos no alcanzaba para cerrar una vuelta. Con ese cambio, el mismo tiempo de vuelta pasó a
valer un bono distinto, sin tocar una sola constante de la recompensa.
La interacción más interesante es entre progreso (por metro) y velocidad objetivo (por segundo). El término de velocidad tiene su máximo justo en la velocidad objetivo, que el código calcula según la curva que viene: 42% de la velocidad máxima en recta (23.1 m/s) y menos en curva. Uno pensaría que la recompensa total también tiene su máximo ahí. No necesariamente.
Por segundo, el progreso paga y el término de velocidad pierde por cada m/s por encima del objetivo. Las dos cosas se equilibran cuando m/s (un poco menos si se suma la trazada):
- Con un objetivo por debajo de 16.25 m/s, hay un máximo local en el objetivo: frenar hasta ahí paga más que pasarse un poco. Pero es solo local: a velocidades bastante mayores el término de velocidad llega a cero y el progreso solo lo supera. Con un objetivo de 10 m/s, por ejemplo, pasar a más de unos 22.5 m/s pagaría más por segundo que frenar.
- Con un objetivo por encima, no hay máximo: la recompensa sigue subiendo después del objetivo.
Y aquí está el hallazgo. Una velocidad objetivo de 10 m/s corresponde a curvas cerradas como las de las pistas procedurales. En el circuito fijo, con curvas de 120 m de radio, la velocidad objetivo nunca baja de unos 18.1 m/s, por encima del umbral. Es decir, en el circuito donde el proyecto terminó, el término de velocidad nunca le dice al agente que frene: por segundo, más velocidad siempre paga más, en recta y en curva (en las curvas, por muy poco).
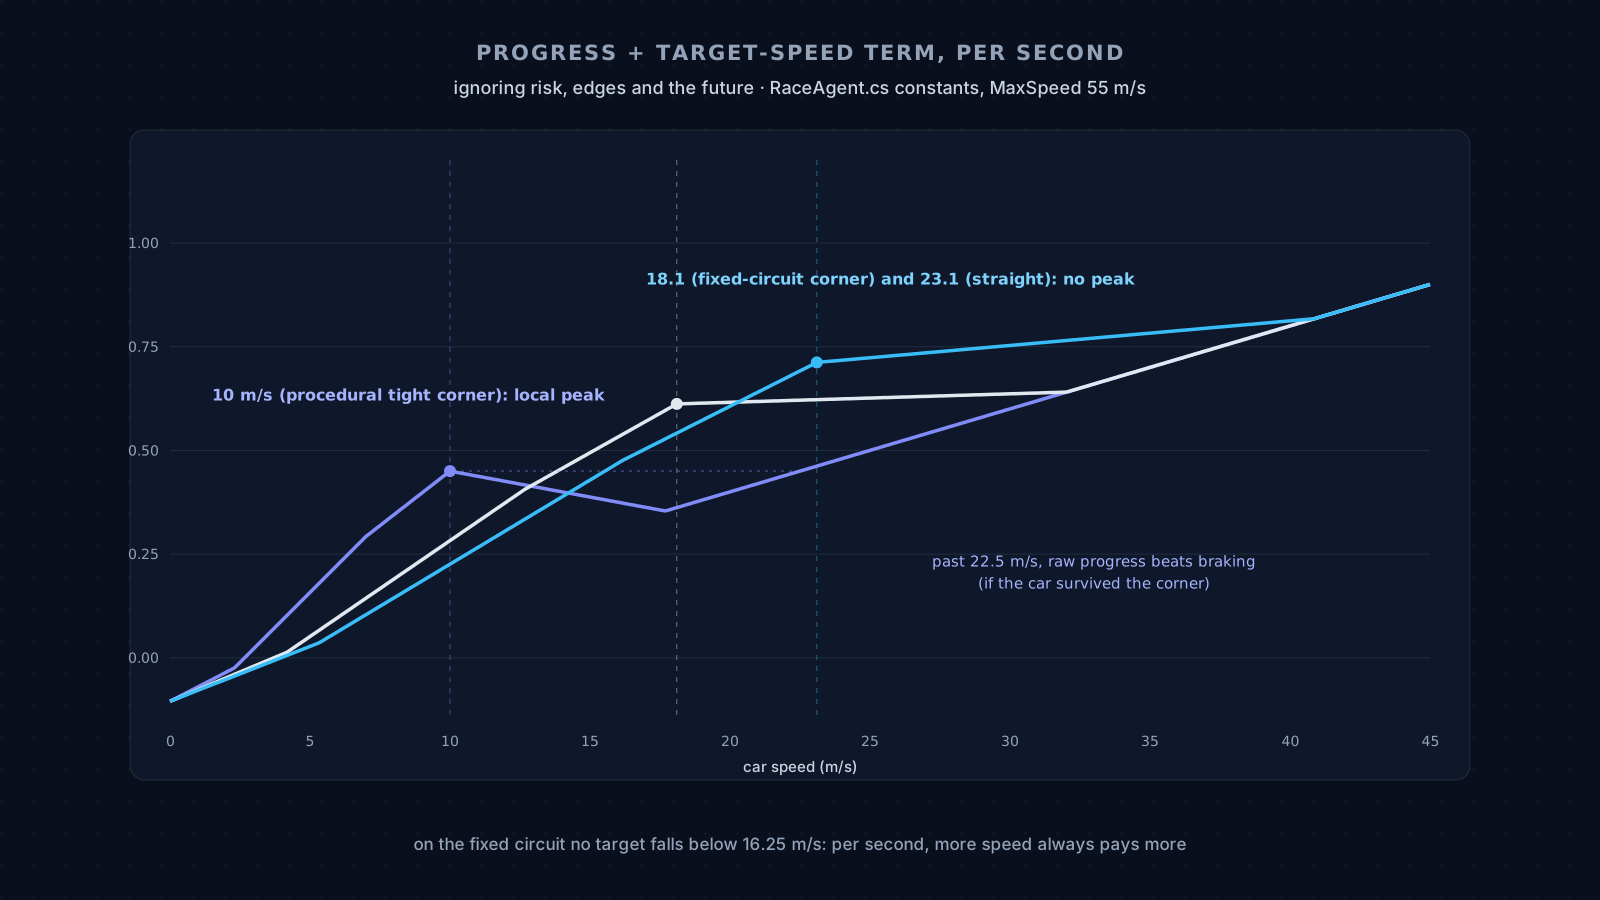
Lo que haría correcto frenar en una curva, entonces, no es el término de velocidad. Es la posibilidad de salirse de la pista, que termina el episodio y corta todo lo que vendría después. Si el auto puede tomar la curva a más velocidad sin salirse, la recompensa lo prefiere así. Eso no hace inútil al término de velocidad (en las curvas cerradas sí crea una zona donde frenar paga), pero muestra que el comportamiento final sale de la combinación, no de leer cada término por separado.
6. Terminar el episodio también es una recompensa
Este es el punto que más se subestima, y en Agentic Racing fue el origen del atajo más famoso.
Cuando un episodio termina, el agente no recibe solo la penalización de ese momento. Pierde todo lo que habría cobrado después. Así que la decisión real del agente no es “¿me conviene el −1?”, sino “¿me conviene más el −1 que el futuro?”. Y eso depende del signo de lo que el futuro paga:
- Si la recompensa esperada por paso es negativa, terminar antes es un premio.
- Si es positiva, sobrevivir es un premio.
Las dos caras aparecieron en esta serie:
La cara negativa: la cuarta corrida. La recompensa tenía una pequeña penalización plana por paso para que el agente terminara rápido, y quedarse detenido terminaba el episodio con −1. El agente aprendió a aprovechar el arranque lanzado, recorrer unos 245 metros cobrando progreso, detenerse y aceptar el −1:
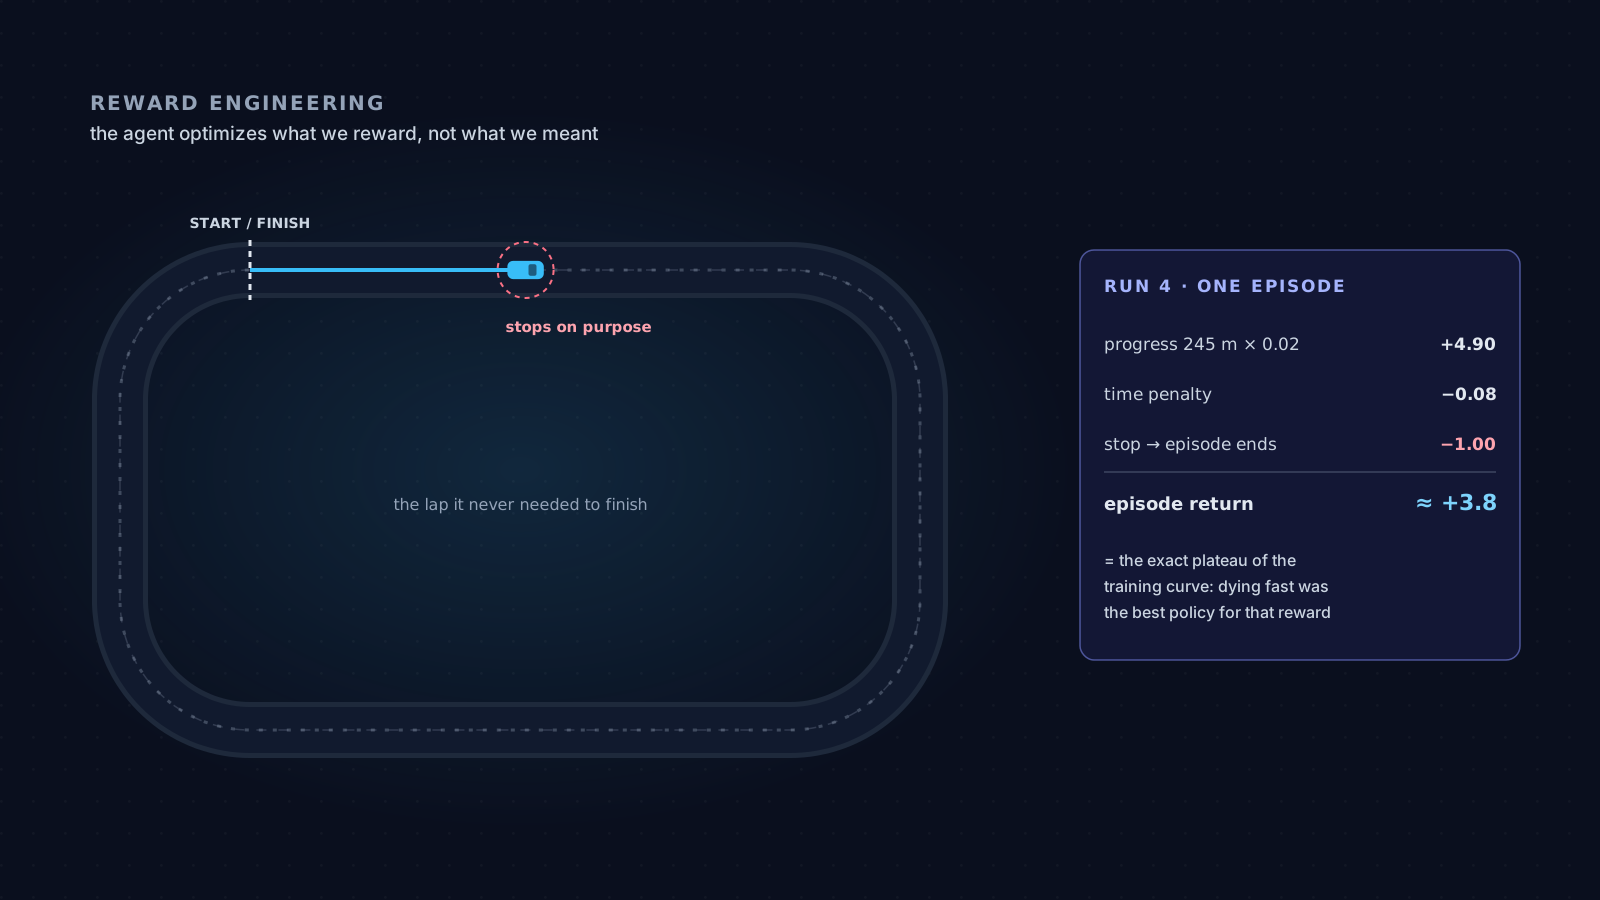
Lo curioso es que la penalización por paso es exactamente lo que recomienda la documentación de ML-Agents para que un agente termine rápido una tarea, con una condición: que completar la tarea coincida con el fin del episodio. Aquí también fallar terminaba el episodio, y fallar costaba menos que seguir intentando. La receta genérica, aplicada a un entorno donde el fracaso también termina el episodio, premió el fracaso rápido.
La cara positiva: GAIL. En la parte 4 vimos que la recompensa de GAIL nunca es negativa, así que alarga los episodios. Lo mismo vale para cualquier término positivo por segundo, como la velocidad objetivo de la sección anterior.
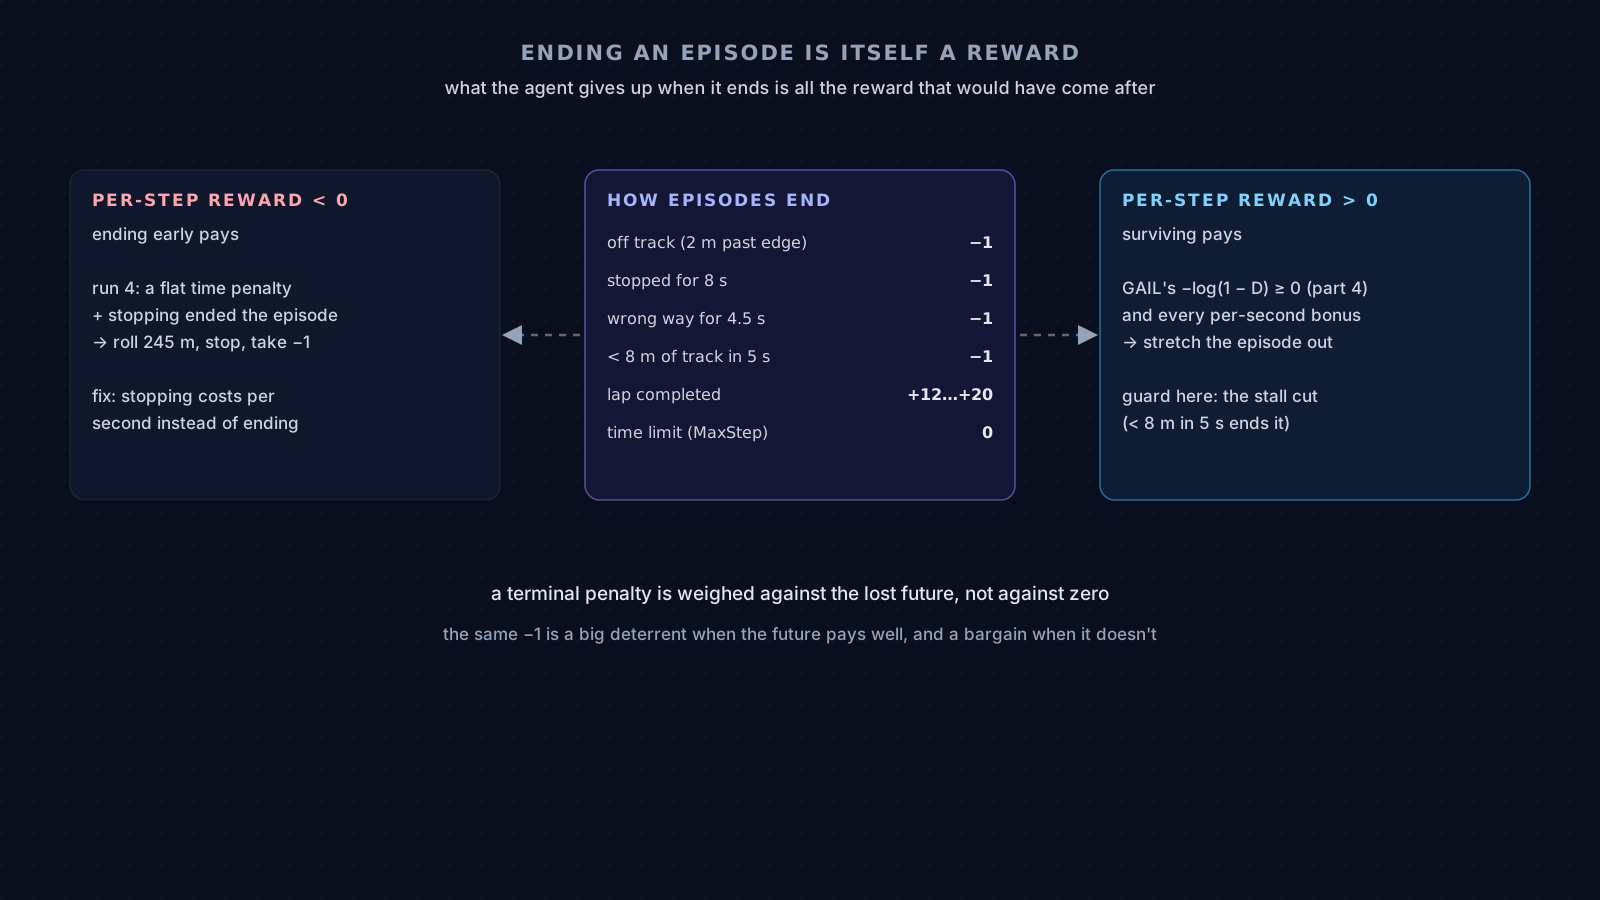
Por eso las condiciones de fin del episodio son parte del diseño de la recompensa, tanto como los pesos. Las del proyecto, después de varias versiones:
| Fin del episodio | Condición | Recompensa |
|---|---|---|
| salida de pista | 2 m más allá del borde | −1 |
| detenido | 8 s parado, después de haber arrancado | −1 (más −0.3 por segundo mientras está parado) |
| sentido contrario | 4.5 s retrocediendo a más de 7.5 m/s, solo después de 15 m de progreso | −1 |
| sin progreso | menos de 8 m de pista en 5 s | −1 |
| vuelta completa | 99% del recorrido | +12 a +20 |
| límite de tiempo | MaxStep | 0 |
Casi cada fila es una cicatriz. La corrección de la cuarta corrida fue que detenerse dejara de terminar el episodio y pasara a costar por segundo, con un corte duro solo a los 8 segundos. El sentido contrario se volvió más tolerante porque terminaba el episodio en la única maniobra que sirve para despegarse de un muro: una reversa corta. Y el corte por falta de progreso llegó cuando la evaluación del piloto heurístico mostró autos en “diente de sierra” cerca de la salida: chocaban, retrocedían un poco, volvían a chocar, y como cada reversa reiniciaba el contador de “detenido”, sobrevivían 80 segundos sin avanzar.
7. Reward hacking: lo que se puede comprobar en el código
El reward hacking es cuando el agente consigue mucha recompensa por un camino que no es el que queríamos. La regla práctica para buscarlo antes de entrenar es una pregunta:
¿Qué otras conductas podrían producir esta misma recompensa?
Con el código a mano, varias de las sospechas clásicas se pueden responder sin entrenar nada:
| Sospecha | ¿Es posible en el código? |
|---|---|
| Ir y volver para cobrar progreso dos veces | No: el progreso tiene signo, retroceder resta lo mismo que avanzar sumó |
| Cobrar un salto falso al cruzar la línea de meta | No: el cálculo de progreso corrige el paso por el cierre del circuito |
| Recortar camino por fuera de la pista | No: 2 m más allá del borde el episodio termina |
| Repetir un evento de choque | Sí, pero es una penalización: repetirla solo resta |
| Quedarse parado y alineado para cobrar la trazada | No: ese término solo paga si el auto se mueve, y en proporción a su velocidad |
| Dar vueltas en círculo cobrando el término de velocidad | Parcialmente: ese término usa la velocidad del auto hacia su propio frente, no a lo largo de la pista, así que un auto girando en círculos lo cobra sin avanzar. A la velocidad objetivo no cabe un círculo entre los muros, pero a baja velocidad sí, con una ganancia pequeña. El corte por falta de progreso lo termina en 5 a 10 segundos con −1 |
La última fila es la interesante. No hay evidencia de que la policy lo haya hecho (los círculos a media pista aparecieron en el piloto heurístico, no en el RL), pero el agujero existe en la definición y lo tapa una condición de fin, no la recompensa. Es el tipo de cosa que conviene saber antes de que un entrenamiento la descubra.
Y luego están los atajos que no son atajos sino conflictos entre términos, que el proyecto sí vivió:
- La trazada contra los muros. Premiar seguir la trazada ideal parecía razonable, pero en este circuito la trazada ideal pasa pegada al borde en cada curva. El término empujaba al auto contra el muro. La solución fue bajar su peso y agregar una penalización suave por acercarse al borde.
- La lentitud contra el frenado. La quinta versión castigaba ir lento para evitar que el agente se arrastrara. Pero frenar antes de una curva es ir más lento, así que el castigo caía justo sobre la maniobra que el agente necesitaba aprender. La séptima versión lo reemplazó por la velocidad objetivo según la curva, con una penalización por lentitud que ahora se mide respecto de ese objetivo.
8. Reward shaping: ayudar sin cambiar el objetivo
El reward shaping consiste en añadir señales intermedias para que aprender sea más fácil. El riesgo es que cambien lo que el agente considera óptimo. Hay una forma de shaping que, bajo ciertas condiciones, está demostrado que no lo cambia (Ng, Harada y Russell, 1999). Se basa en una función potencial del estado:
que se suma a la recompensa original:
La intuición: lo que el agente gana al acercarse a la meta lo devuelve si se aleja, así que no hay forma de acumular shaping dando vueltas.
¿Qué tan cerca está la recompensa de Agentic Racing de esto?
- El progreso se parece mucho. Es la diferencia de un potencial, (metros recorridos de la vuelta), entre un paso y el siguiente. Pero le falta el factor , y el potencial no vuelve a cero cuando el episodio termina; las dos son condiciones del teorema. Además, si se toma como recompensa “verdadera” la vuelta completa y las terminaciones, el progreso no es un ajuste pequeño sobre ella: es la mayor parte de lo que paga. La garantía no aplica tal cual.
- La velocidad objetivo, la trazada y el borde no lo son. No son diferencias de un potencial: pagan según cómo se mueve el auto, no solo según dónde está. Esos términos sí cambian lo que es óptimo, y es a propósito: le dicen al agente a qué velocidad ir y por dónde.
Ese último punto tiene una lectura interesante a la luz de las partes 3 a 5. La velocidad objetivo de la recompensa es una variante de la regla de frenado del piloto heurístico: el comentario del código dice que “imita a la heurística”, y las dos calculan una velocidad según la curva que viene, con constantes parecidas. Es decir, la recompensa ya contenía una forma de imitación, escrita a mano en lugar de aprendida de demostraciones. La documentación de ML-Agents aconseja lo contrario: premiar resultados, no las acciones que uno cree que llevan a ellos. El proyecto eligió premiar una acción (una velocidad) porque el resultado (dar la vuelta) no aparecía.
9. La recompensa no puede ser la única métrica
Si evaluamos al agente con la misma señal con la que lo entrenamos, heredamos sus puntos ciegos. El proyecto lo aprendió con tres episodios concretos:
Una curva que subía no era una mejora. En la tercera corrida, la recompensa acumulada subió hasta ~10, entre dos y tres veces el estancamiento de las corridas anteriores, y los episodios se hicieron cinco veces más largos. Parecía el avance que se esperaba. La cuarta corrida, con más pasos y la misma configuración, volvió al pozo de siempre. La bitácora lo cerró así: la tercera había sido “varianza favorable de una corrida”. Una sola corrida no es evidencia.
Un número estable no era un buen número. El estancamiento de la cuarta corrida, cerca de +3.8, coincidía exactamente con el return del atajo de la sección 6. La curva no decía “aprendió poco”: decía “aprendió perfectamente a hacer otra cosa”.
Las curvas de recompensa de versiones distintas no se pueden comparar. La quinta corrida empezó en −34; la primera, en −1.1. No porque la quinta fuera peor, sino porque la recompensa había cambiado. Cada versión tiene su propia escala, y comparar sus curvas es comparar unidades distintas.
Por eso el proyecto construyó, después de la cuarta corrida, un evaluador independiente (eval.exe)
que no mira la recompensa. Corre las policies y reporta otras cosas:
| Métrica del evaluador | Qué reveló |
|---|---|
| motivos de fin de episodio | la cuarta corrida terminaba “detenido” el 86% de las veces |
| fracción de vuelta recorrida | todas las corridas se quedaban cerca del 10% |
| freno medio | 0.02: la policy nunca frenaba, y sin frenar no se toma una curva |
| velocidad, acelerador y dirección medios | dos estilos opuestos con la misma fracción de vuelta: reptar a 7 m/s, o acelerar y terminar detenido o fuera de la pista |
El freno medio de 0.02 fue el dato más útil de toda la fase, y no estaba en ninguna curva de recompensa.
10. Lo que ninguna recompensa podía arreglar
Hay una última lección, y es la más cara. La intuición habitual, y la que también tenía el plan del proyecto, es que cuando un agente aprende algo raro, la culpa casi siempre es de la recompensa. En Agentic Racing la bitácora cuenta siete variantes de la recompensa. El número que importaba, la fracción de vuelta, no se movió de entre un 8 y un 13%.
Mientras tanto, la bitácora fue nombrando “causa raíz”, una tras otra, a cosas que no eran la recompensa: los muros (mallas de espesor cero donde el auto se clavaba), el agarre lateral (que borraba la velocidad lateral en vez de redirigirla, así que cada giro fuerte era un frenazo) y las curvas de 12 m de radio de las pistas procedurales. Algunas se descartaron después: tres versiones distintas de los muros dieron el mismo resultado, y la bitácora concluye “los muros no eran la causa”. Otras se arreglaron antes de la octava corrida, que igual se estancó en el mismo lugar.
Lo que destrabó el problema fue otra cosa: cambiar las pistas procedurales por el circuito fijo. Ahí el piloto heurístico, por primera vez, recorrió vueltas limpias, y la bitácora atribuye la “parálisis” de las ocho corridas a las pistas procedurales (tramos degenerados de la línea central, muros mal formados en curva, curvas que nadie podía tomar), no a un bug de fondo de la física del auto. Si PPO aprende a dar vueltas en el circuito fijo es algo que nunca se probó.
El experimento que podía separar “problema de recompensa” de “problema de entorno” se hizo a mitad de camino, después de la quinta corrida: poner al piloto heurístico, escrito a mano, en el mismo entorno. Pero se leyó a favor del entorno: que su mejor episodio llegara al 82% de la vuelta se tomó como prueba de que el entorno era aprendible, y después de la séptima corrida la bitácora llegó a escribir “la recompensa ya es correcta”. La respuesta completa llegó recién con el circuito fijo, cuando el piloto heurístico pasó de un buen episodio aislado a vueltas completas. La lección no es solo hacer ese experimento: es exigirle una respuesta clara. Si un controlador escrito a mano no puede dar la vuelta de forma consistente, ninguna recompensa va a enseñarle a una red neuronal a hacerlo.
La documentación de ML-Agents sugiere algo parecido con otra intención: usar la heurística del agente para conducirlo y mirar cómo acumula recompensa. Aplicado aquí, habría servido para dos cosas a la vez: saber si el entorno era manejable, y saber si la recompensa premiaba al experto por encima de las policies que fallaban. El proyecto hizo lo primero; la bitácora no registra que se haya medido lo segundo.
11. La deuda de la parte 5: una recompensa que no sabe de directivas
En la parte 5 vimos que el piloto existe para obedecer al estratega, y que el piloto heurístico lo hace: con la misma pista, tarda 112 s por vuelta con “conservar” y agresión baja, y 79 s con “atacar” y agresión alta. La recompensa, en cambio, calcula su velocidad objetivo solo a partir de la curva. Ningún término lee los canales de directiva.
El piloto heurístico sí escala su velocidad objetivo según la directiva, a través de un mapa único
(StrategyDirectiveMap) que también usa el estratega. La propuesta más directa sería que la recompensa
usara ese mismo mapa:
(En ese mapa, la escala de velocidad sale de la agresión, entre 0.86 y 1.16, con un 10% menos si la directiva es “conservar”; el tipo “atacar” cambia sobre todo la línea.) Con eso, la recompensa le diría al agente “con agresión alta, la velocidad correcta es más alta”, y una policy que la optimizara tendría una razón para responder a la directiva.
Es una propuesta, no algo probado, y trae sus propias preguntas: si la escala debería aplicarse también al margen de frenado y a la línea, como hace la heurística; si el agente aprendería a distinguir directivas que en la recompensa solo difieren en la velocidad; y si eso empeoraría la estabilidad del entrenamiento. Pero ilustra el punto de este artículo: el hallazgo de la parte 5 no se arregla con un algoritmo, se arregla diciendo mejor lo que queremos.
12. Un experimento reproducible
Si se retoma el piloto RL sobre el circuito fijo, el experimento natural compara versiones de la recompensa cambiando una sola cosa cada vez:
| Variante | Recompensa | Pregunta |
|---|---|---|
| A. Escasa | solo vuelta completa y terminaciones | ¿puede aprender sin señal densa en este circuito? |
| B. Actual | la de la octava corrida | la referencia: nunca se entrenó en el circuito fijo |
| C. Sin velocidad objetivo | B sin ese término | ¿cuánto aporta la imitación escrita a mano de la sección 8? |
| D. Con directivas | B con la velocidad objetivo escalada por la directiva | ¿aparece la respuesta a la directiva? |
Comparaciones: A contra B, B contra C y B contra D. Para que signifiquen algo:
- Mismo build, mismo circuito, mismo
MaxStep. El bono de vuelta rápida depende de él (sección 5). - Recompilar el player en cada variante. Los pesos de la recompensa se leen de los valores por defecto del código, no de una escena; cambiarlos exige reconstruir el ejecutable de entrenamiento.
- Registrar cada componente de la recompensa por separado. Hoy el proyecto no los registra por separado: TensorBoard solo ve la recompensa total. ML-Agents permite publicar métricas propias en TensorBoard desde el código del agente; sin eso no hay forma de saber qué término está moviendo la curva.
- Varias semillas por variante, con media y dispersión. La tercera corrida ya mostró lo que vale una sola.
- Evaluar con
eval.exe, no con la recompensa. Motivos de fin, fracción de vuelta, freno medio y, para D, tiempo por vuelta con cada directiva forzada. - Medir también al experto con cada recompensa. Si el piloto heurístico no saca más recompensa que una policy que falla, la recompensa está midiendo otra cosa.
| Métrica | A | B | C | D |
|---|---|---|---|---|
| Vueltas completas | ? | ? | ? | ? |
| Fracción de vuelta | ? | ? | ? | ? |
| Freno medio | ? | ? | ? | ? |
| Salidas de pista | ? | ? | ? | ? |
| Diferencia atacar / conservar | ? | ? | ? | ? |
| Recompensa del experto con esa función | ? | ? | ? | ? |
Nada de esto se ejecutó. Las celdas quedan con ”?“.
13. Un flujo de trabajo para diseñar recompensas
Juntando todo, el ciclo que el proyecto habría querido seguir desde el principio:
0. Verificar que el entorno se pueda resolver con un controlador simple
            ↓
1. Escribir el objetivo en palabras
            ↓
2. Traducirlo a eventos medibles y a terminaciones
            ↓
3. Empezar con una recompensa mínima
            ↓
4. Sumar cada término sobre una vuelta: escalas, unidades, signos
            ↓
5. Entrenar, registrando cada componente por separado
            ↓
6. Evaluar con métricas que no sean la recompensa, en varias semillas
            ↓
7. Mirar episodios concretos, no solo curvas
            ↓
8. Cambiar una sola cosa, y volver al paso 4
El paso 0 no suele aparecer en las guías de reward engineering. En Agentic Racing fue el que más tiempo habría ahorrado.
Conclusión
Reward engineering no consiste en repartir puntos positivos y negativos. Consiste en traducir un objetivo que nosotros entendemos a una señal que el agente pueda optimizar, y después comprobar que optimizar esa señal produce lo que queríamos.
La recompensa de Agentic Racing deja varias lecciones concretas:
- los pesos no dicen nada hasta que se suman sobre un episodio completo;
- las unidades (por metro, por segundo, por evento) cambian lo que cada término premia;
- terminar el episodio es una recompensa, y su signo depende de lo que el futuro paga;
- los términos pueden pelearse entre sí, como la trazada con los muros o la lentitud con el frenado;
- una recompensa puede contener imitación escrita a mano sin que nadie la llame así;
- la recompensa no puede ser la única métrica;
- y ninguna recompensa arregla un entorno donde el problema no se puede resolver.
La pregunta que conviene hacerse antes de cada entrenamiento sigue siendo la misma:
¿Qué estamos premiando exactamente, y qué otras cosas podría aprender a hacer el agente para conseguir esa recompensa?
Si llegaste directo a este artículo, las cinco partes anteriores están enlazadas al principio, y Agentic Racing: un piloto que nunca aprendió a manejar cuenta la historia completa del proyecto.
Referencias
- Sutton, R. S. y Barto, A. G. (2018). Reinforcement Learning: An Introduction, 2.ª edición. MIT Press.
- Ng, A. Y., Harada, D. y Russell, S. (1999). Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping. ICML.
- Amodei, D. et al. (2016). Concrete Problems in AI Safety. (Reward hacking como problema de diseño.)
- Schulman, J. et al. (2017). Proximal Policy Optimization Algorithms.
- Ho, J. y Ermon, S. (2016). Generative Adversarial Imitation Learning. NeurIPS.
- Unity Technologies. Unity ML-Agents Toolkit, release de
mlagents1.1.0: la sección “Rewards” dedocs/Learning-Environment-Design-Agents.md(rango de la recompensa por decisión, penalización por paso, usar la heurística para inspeccionar la recompensa). - La recompensa (
unity/Assets/Scripts/Agents/RaceAgent.cs), el evaluador y la bitácora con las ocho corridas están en github.com/alulema/agentic-racing.