Serie: Reinforcement Learning desde cero, con Agentic Racing como laboratorio
- Parte 1 · ¿Cómo aprende un agente? Enseñando a un automóvil a conducir
- Parte 2 · ¿Cómo mejoramos una policy sin destruirla? PPO explicado desde cero
- Parte 3 · ¿Podemos enseñar imitando? Behavioral Cloning explicado desde cero
- Parte 4 · ¿Podemos aprender a comportarnos como un experto? GAIL explicado desde cero
- Parte 5 · ¿Podemos combinar imitación y RL? BC, GAIL y PPO en un mismo sistema
- Parte 6 · ¿Cómo le decimos a un agente qué queremos? Reward engineering explicado desde cero
- Parte 7 · ¿Qué debería poder ver un agente? Observation design explicado desde cero (este artículo)
Dónde nos quedamos
La parte 6 trató de cómo le decimos al agente qué queremos. Esta parte va un paso antes:
¿Qué información debería recibir el agente para poder decidir bien?
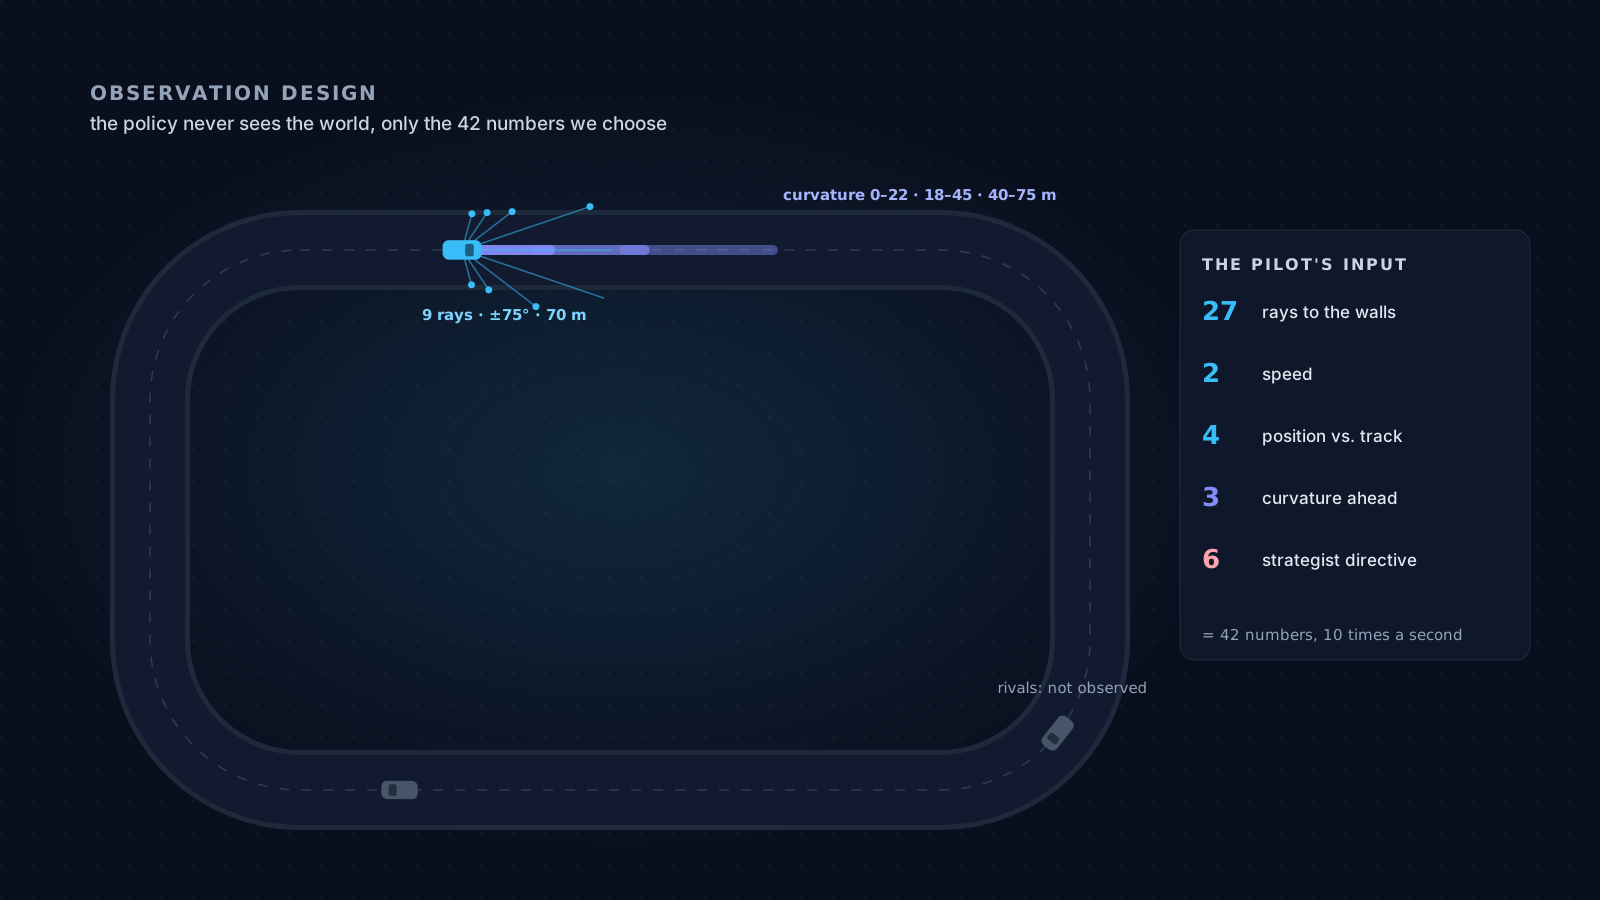
La parte 1 ya presentó la distinción entre estado y observación, y la tabla con los 42 números que recibe el piloto de Agentic Racing. Aquí volvemos a esa tabla con más cuidado: qué significa cada número, cómo está escalado, qué le permite al agente, qué le falta, y qué pasó las veces que el proyecto la cambió.
Como en la parte 6, esta vez hay material real: las observaciones están en el código y tienen historia. La advertencia de siempre también vale: ningún piloto entrenado con estas observaciones completó vueltas de forma consistente, y las propuestas del final no se ejecutaron.
1. El agente no ve el mundo: recibe una observación
En cada paso, el entorno está en un estado , pero el agente recibe una observación que lo describe solo en parte:
es la función que convierte el estado en observación, y la diseñamos nosotros. El simulador de Agentic Racing conoce todo: la posición exacta de cada auto, la geometría completa del circuito, las fuerzas de la física. El piloto recibe 42 números, 10 veces por segundo.
La consecuencia importante es esta: el agente solo puede distinguir las situaciones que su observación distingue. Si dos situaciones que piden acciones distintas producen la misma observación, ninguna policy que dependa solo de ella puede resolver bien las dos.
2. Los 42 números, uno por uno
Así se arma la observación del piloto en el código:
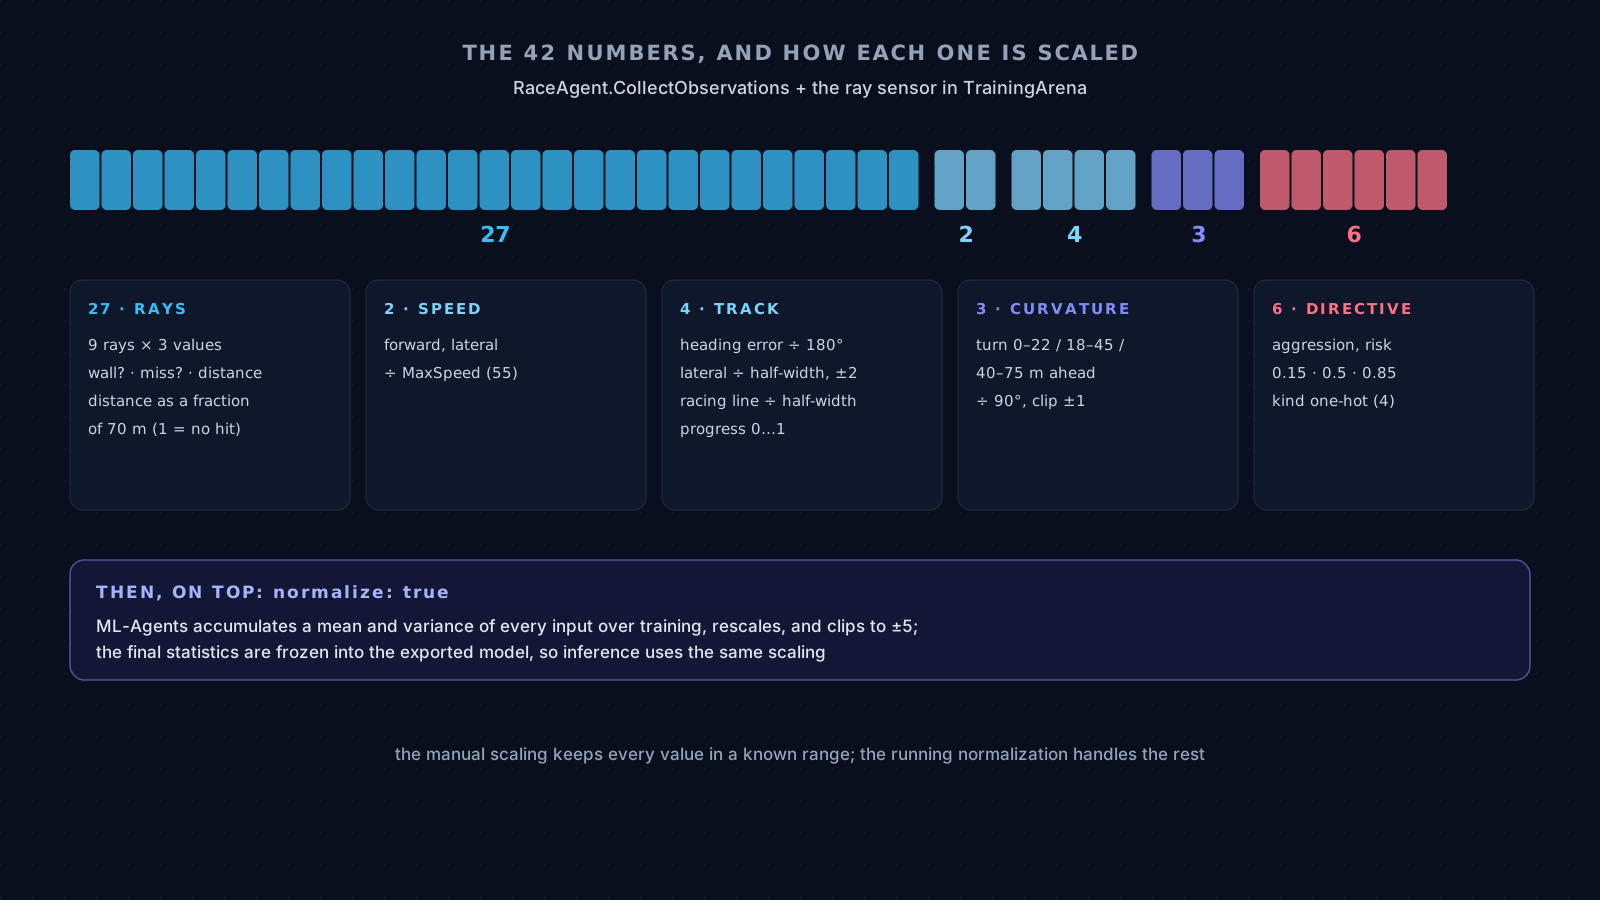
| Grupo | Valores | Qué contiene | Cómo se escala |
|---|---|---|---|
| Rayos | 27 | 9 rayos en abanico de ±75°, de hasta 70 m, que reconocen los muros del borde; por rayo: si lo que tocó es un muro, si no tocó nada, y la distancia | dos valores binarios y la distancia como fracción del largo del rayo (1 si no tocó nada) |
| Velocidad | 2 | hacia adelante y lateral | dividida por la velocidad máxima (55 m/s) |
| Pista | 4 | error de rumbo respecto de la trazada ideal; desplazamiento lateral del auto; desplazamiento de la trazada ideal; progreso en la vuelta | rumbo ÷ 180°; desplazamientos ÷ medio ancho de pista, recortados a ±2; progreso de 0 a 1 |
| Curvatura | 3 | cuánto gira la línea central entre 0–22, 18–45 y 40–75 m por delante | ÷ 90°, recortado a ±1 |
| Directiva | 6 | agresión, tolerancia al riesgo, y el tipo de directiva en one-hot | niveles 0.15, 0.5 o 0.85; one-hot de 4 valores |
Visto con la lista de preguntas que un piloto necesita responder, el diseño cubre casi todo:
| Pregunta | Qué la responde |
|---|---|
| ¿Dónde estoy respecto de la pista? | desplazamiento lateral, rayos |
| ¿Hacia dónde apunto y hacia dónde sigue la pista? | error de rumbo |
| ¿A qué velocidad voy? ¿Estoy derrapando? | velocidad hacia adelante y lateral |
| ¿Qué tan cerrada es la curva que viene? | curvatura por delante, rayos |
| ¿Qué me pide el estratega? | canales de directiva |
| ¿Hay un auto delante? | nada |
La última fila la veremos en la sección 8.
Dos detalles de diseño que vale la pena notar. El tipo de directiva va en one-hot (cuatro valores, uno encendido), que es lo que recomienda la documentación de ML-Agents para variables categóricas: “atacar” no es “el doble de defender”. Y los niveles de agresión y riesgo no son continuos: se sortean entre 0.15, 0.5 y 0.85 porque son los tres niveles que el estratega LLM puede elegir. El comentario del código lo explica: así la policy ve en entrenamiento los mismos valores posibles que verá cuando el LLM escriba esos canales (no con la misma frecuencia: en entrenamiento se sortean al azar, y el LLM no elige al azar). Es una forma de evitar un desajuste entre entrenamiento y uso real antes de que exista.
3. Escalas: dos capas de normalización
La documentación de ML-Agents recomienda normalizar cada observación a o , y la mayoría de los números del piloto lo están por construcción: la velocidad dividida por la máxima, el rumbo por 180°, la curvatura por 90° con un recorte.
Dos detalles merecen nota. Los desplazamientos laterales se recortan a ±2 medios anchos de pista, no a ±1. El código no explica por qué, y en la práctica el recorte casi nunca actúa: los muros están en el borde, y el episodio termina 2 m más allá, a unos 1.33 medios anchos. Y el progreso en la vuelta, que sí está en , salta de 1 a 0 al cruzar la línea de meta: dos puntos vecinos de la pista tienen valores en los extremos opuestos de la escala.
Encima de eso, la configuración de entrenamiento activa normalize: true: ML-Agents acumula una media
y una varianza de cada entrada a lo largo de todo el entrenamiento (incluidos los 27 valores de los
rayos), reescala con ellas antes de la red y recorta el resultado a ±5. Esas estadísticas siguen
cambiando mientras se entrena y quedan congeladas en el modelo exportado, así que la inferencia usa las
finales.
Una advertencia que el proyecto confirma: normalizar bien no compensa información que falta. Las seis primeras corridas tenían observaciones bien escaladas y aun así no veían venir las curvas.
4. Reaccionar o anticipar
Algunas observaciones describen el presente: la velocidad, el desplazamiento lateral, la distancia a los muros. Otras ayudan a anticipar: la curvatura de la pista por delante.
Las seis primeras corridas solo podían anticipar con los rayos, que entonces llegaban a 40 m. A 15 m/s eso son menos de tres segundos para ver una curva, frenar y girar. En la séptima se agregaron las tres observaciones de curvatura y los rayos se alargaron a 70 m:
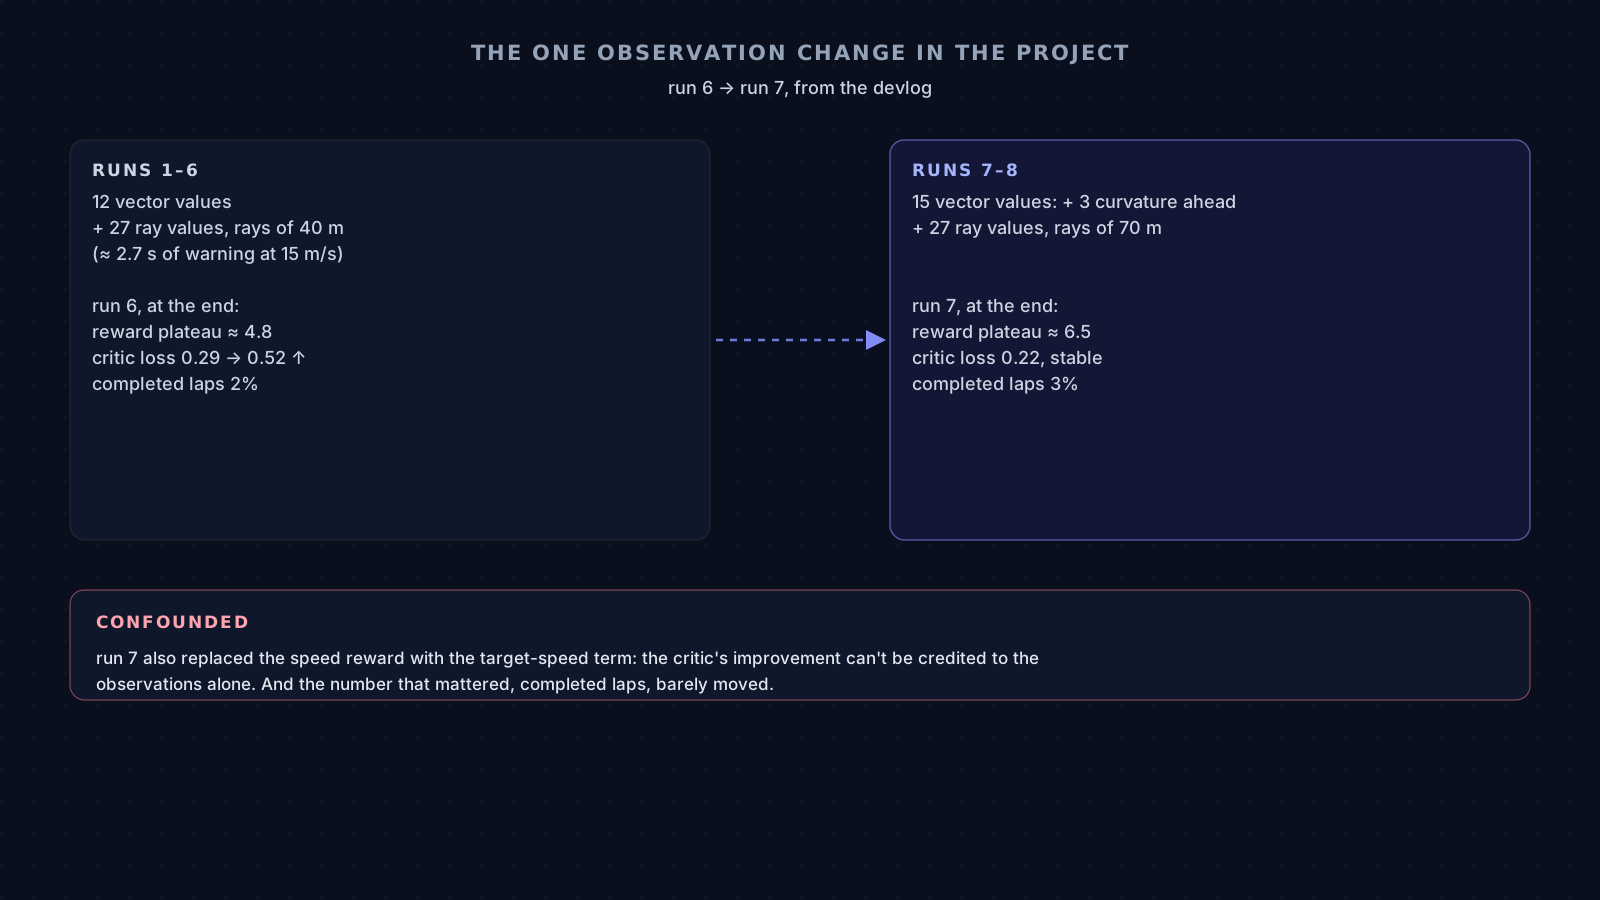
El crítico mejoró de forma visible: su error dejó de crecer y se estabilizó. Pero hay dos lecturas honestas que hacer:
- No se puede atribuir solo a las observaciones. La misma corrida reemplazó la recompensa de velocidad por la velocidad objetivo de la parte 6. Dos cambios a la vez, un solo resultado: es el error de diseño experimental que la sección 9 propone evitar.
- La métrica que importaba casi no se movió. Las vueltas completas pasaron del 2% al 3%. Una mejor observación era necesaria, pero no suficiente; como contamos en la parte 6, buena parte del problema estaba en las pistas procedurales, y en las siete primeras corridas el agarre lateral además frenaba el auto en cada giro.
Una pregunta legítima sobre la anticipación es si la información “existe” de verdad. La curvatura se calcula leyendo la geometría del circuito por delante, que un auto real no tendría sin un mapa. Aquí no es un problema: la policy se usaría en el mismo simulador donde se entrena, y un piloto de carreras conoce el circuito. Pero la pregunta correcta siempre es la misma: ¿esta información estará disponible donde se va a usar la policy?
5. ¿Vector o cámara?
ML-Agents permite observaciones vectoriales (números) y visuales (imágenes de una cámara virtual). Agentic Racing usa solo vectores y rayos: ni cámaras ni texturas renderizadas.
El plan del proyecto partía de observaciones vectoriales y, a partir de ahí, eligió entrenar en CPU, sin GPU: con vectores, una red pequeña y PPO, el cuello de botella es simular Unity, no calcular gradientes. El propio plan anota que pasar a cámaras cambiaría ese cálculo. La documentación de ML-Agents va en la misma dirección: las observaciones visuales suelen ser menos eficientes y más lentas de entrenar, y conviene usarlas solo cuando el problema no se puede resolver con vectores o rayos. Aquí, los rayos y la curvatura ya le daban al piloto resumido lo que una cámara le habría obligado a aprender de los píxeles.
| Objetivo | Punto de partida razonable |
|---|---|
| Validar que el control básico funciona | vector compacto, como el de Agentic Racing |
| Estudiar el efecto de cada señal | vectores con ablaciones controladas |
| Aprender a conducir desde una cámara | imágenes, con variación suficiente de escenarios |
| Transferir a sensores reales | solo lo que esos sensores pueden medir |
6. ¿El agente necesita memoria?
La policy del proyecto es puramente reactiva: decide solo con la observación del instante actual,
. No apila observaciones anteriores (NumStackedVectorObservations = 1) ni usa una
red recurrente (la configuración no tiene bloque de memoria).
Eso tiene una consecuencia que ya vimos en las partes 3 y 4. El experto, el piloto heurístico, sí tiene memoria: temporizadores que cuentan cuánto tiempo lleva lento contra un muro, una ventana de reversa para despegarse, y un volante filtrado que depende del comando anterior. Cuando el experto da reversa porque su temporizador cuenta más de un segundo lento contra un muro, la observación del agente en ese instante puede ser casi igual a la de otro momento en que el experto acelera. Para una policy sin memoria, son la misma situación con dos respuestas distintas.
En términos formales, el problema del piloto es parcialmente observable (un POMDP): una sola observación no identifica todo lo que importa. Hay tres formas de atacarlo, de menor a mayor complejidad:
- Agregar la variable que falta, si existe. Por ejemplo, el comando de volante anterior.
- Apilar observaciones recientes. ML-Agents lo permite con una opción para el vector y otra para el sensor de rayos; la documentación lo describe como “memoria limitada” sin la complejidad de una red recurrente.
- Una policy recurrente (LSTM), que aprende qué recordar.
Ninguna se probó. Y la memoria tiene un límite: si una señal nunca se observa y no se puede inferir de la historia, ninguna red recurrente puede inventarla.
7. Diseñar para generalizar, no para memorizar
El riesgo clásico es una observación que permita aprender “en esta posición del mundo, gira a la izquierda” en lugar de “cuando la pista gira a la izquierda, gira a la izquierda”. La documentación de ML-Agents lo resume en una regla: codificar posiciones en coordenadas relativas siempre que se pueda.
El piloto del proyecto la sigue casi en todo: no recibe su posición absoluta, y la relación con la pista se mide respecto de la línea central y la trazada ideal. Con una excepción interesante: el progreso en la vuelta, un número de 0 a 1.
El progreso es la fracción de la vuelta recorrida desde la línea de meta, así que siempre fue una posición a lo largo de la pista. Mientras el entrenamiento usaba nueve pistas procedurales distintas, una por arena, “37% de la vuelta” era un lugar distinto en cada pista. Pero en el circuito fijo, donde el proyecto terminó (y que hoy es la pista por defecto de las nueve arenas), ese número es un código de posición único: “37% de la vuelta” es siempre el mismo lugar del mismo circuito. Una policy entrenada ahí podría aprender a girar en el 37% en lugar de girar cuando la pista gira. Funcionaría en ese circuito y fallaría en cualquier otro.
Nadie entrenó en el circuito fijo, así que es un riesgo, no un hallazgo. Pero muestra algo general: que una observación sea relativa o absoluta depende también del entorno de entrenamiento. La misma variable puede ser inocente con nueve pistas y peligrosa con una.
8. Lo que el piloto no ve: los rivales
El demo corre seis autos en la misma pista. El piloto no ve a ninguno.
Los rayos solo detectan los muros del borde, y ninguna de las 15 observaciones restantes describe a otro auto. No es un descuido de una línea: en entrenamiento, cada arena tiene un solo auto, así que no había rivales que observar. El plan del proyecto incluía una fase multiagente con observaciones de los rivales más cercanos; no llegó a hacerse, porque antes el piloto RL se reemplazó por el heurístico.
Y el heurístico tampoco ve rivales. Hay un detalle revelador ahí. Uno de los canales de directiva se llama “tolerancia al riesgo”, y el diseño original lo definía como tolerancia a la proximidad: aceptar huecos más estrechos, ir rueda a rueda. En el código actual, ese canal solo ajusta cuánto se acerca el auto a la línea central o a la trazada ideal. No puede significar “proximidad” porque el piloto no tiene ninguna observación de proximidad. Una directiva solo puede modular lo que el piloto puede percibir.
Los adelantamientos que se ven en el demo, entonces, no son maniobras: salen de diferencias de ritmo entre autos que no saben que los otros existen. Los contactos los resuelve la física, y el director de carrera los registra como incidentes. (En la escena de carrera, de hecho, los autos ni siquiera tienen el sensor de rayos: conduce el piloto heurístico, que no lo usa.)
9. Tres decisores, tres observaciones
En Agentic Racing hay tres “agentes” que toman decisiones, y cada uno ve cosas distintas a propósito:
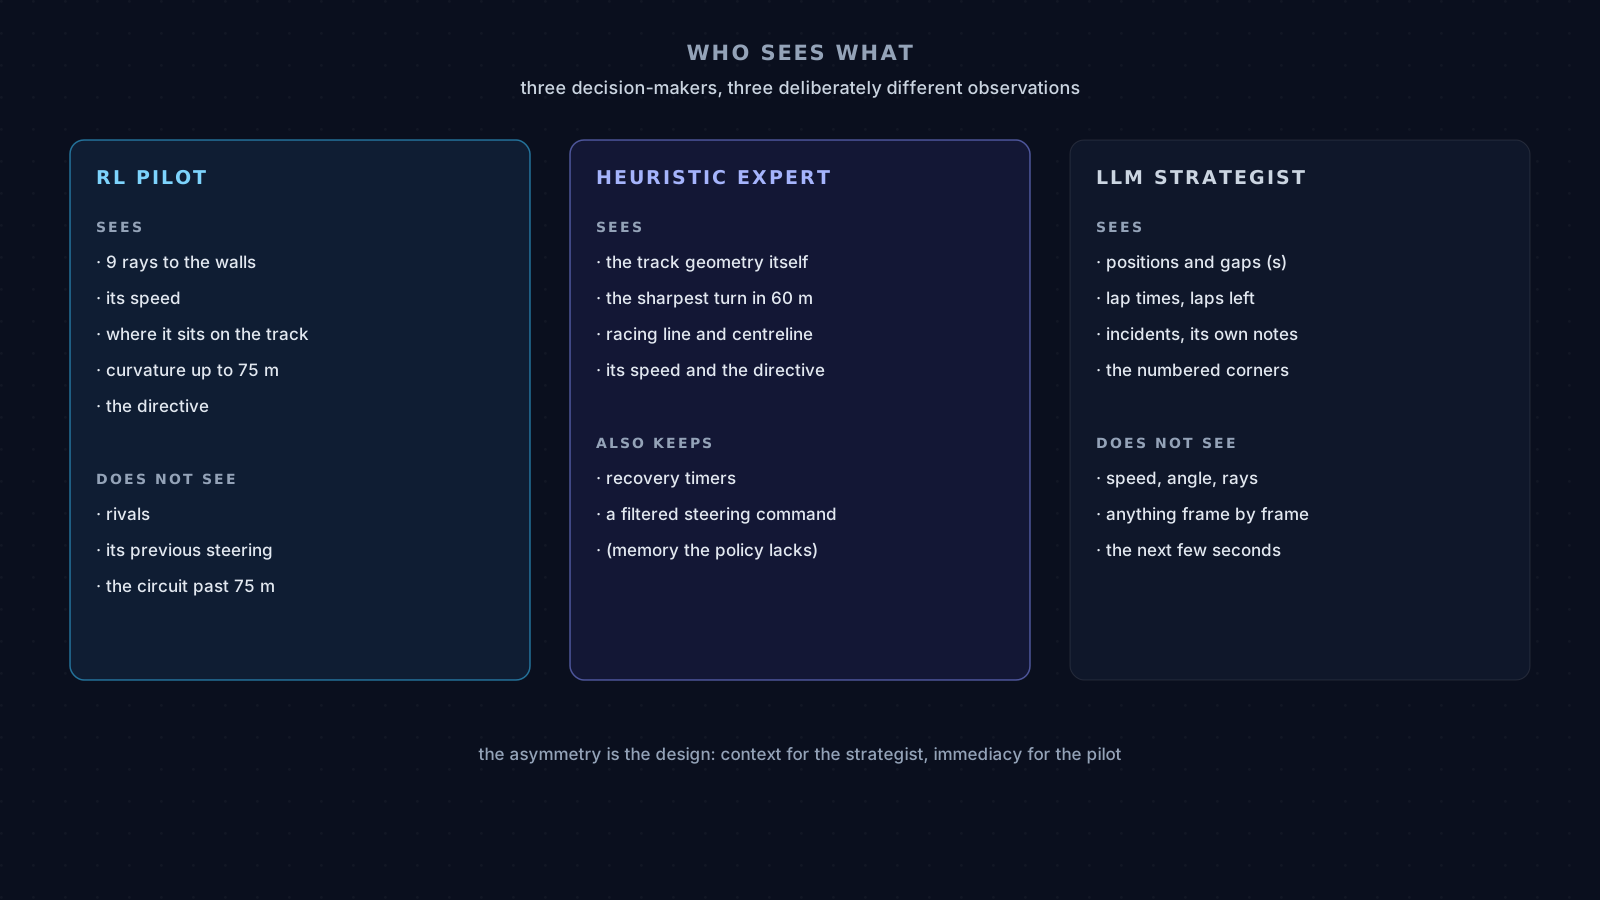
La asimetría entre el piloto y el estratega es la idea central del demo, y está escrita en el plan desde el principio. El estratega ve más contexto (la clasificación, los gaps en segundos, los tiempos de vuelta, las curvas numeradas, su propia bitácora) pero menos inmediatez: no ve velocidad, ángulo ni rayos, y no puede reaccionar a lo que pasa en los próximos segundos. El piloto es lo contrario. El código respeta esa frontera: la telemetría que se le envía al LLM describe a los rivales solo con lo observable desde fuera (posición, gap, último tiempo de vuelta, tendencia).
Eso también es observation design, en otro nivel: decidir qué ve cada parte de un sistema es decidir qué problema resuelve cada una.
El experto, por su parte, tiene información privilegiada: lee la geometría de la pista directamente y recuerda cosas que la policy no ve. La información privilegiada está bien para un profesor que genera demostraciones, pero hay que saber que existe: lo que el profesor usa y el alumno no ve es justo lo que el alumno no podrá copiar (parte 3).
10. Bugs de observación: cuando el agente recibe ceros
Antes de la primera corrida de entrenamiento, el proyecto pasó por dos bugs que no tenían nada que ver con el diseño de las observaciones, sino con su tubería:
- Un desajuste de forma. ML-Agents negocia con Python el tamaño de cada observación al conectarse. Por el orden en que se armaban los componentes del auto, el tamaño acordado solo incluía el vector de 12 valores, pero en ejecución llegaban también los 27 de los rayos. Resultado: una excepción de “esperaba (12,) y recibí (27,)”.
- Observaciones vacías. Arreglado eso, una corrida de prueba entera llenó el log de avisos de “menos observaciones de las esperadas, se rellenan con ceros”, unos dos millones: el vector de 12 valores llegaba vacío en casi cada paso, y el auto ni siquiera actuaba. La observación vacía era un síntoma de que toda la tubería de decisión estaba mal armada.
Los dos se arreglaron cambiando cómo y en qué orden se arman los componentes del auto, y la primera corrida arrancó con el log limpio. La lección es práctica: hay que verificar que la observación que llega a la red es la que creemos que mandamos. Un relleno con ceros no detiene el entrenamiento; solo lo arruina en silencio.
11. Observaciones e imitación
Las observaciones también condicionan BC y GAIL (partes 3 y 4). Las demostraciones del grabador del proyecto guardan exactamente las mismas 42 observaciones que recibe la policy, así que no hay desajuste de unidades ni de preprocesamiento entre experto y alumno. El problema es otro, y ya lo vimos: el experto decide con información que no está en esas 42 observaciones. BC no puede copiar una decisión que depende de algo que no ve, y el discriminador de GAIL no puede exigirlo.
12. Un experimento reproducible
Si se retoma el piloto RL en el circuito fijo, el experimento natural cambia una sola cosa cada vez sobre la observación actual:
| Variante | Cambio | Pregunta |
|---|---|---|
| A. Base | las 42 observaciones actuales | la referencia: nunca se entrenó en el circuito fijo |
| B. Sin progreso | quitar el progreso en la vuelta | ¿la policy lo usaba como código de posición? |
| C. Sin curvatura | quitar las 3 de curvatura | ¿cuánto aportan, ahora sin la recompensa mezclada? |
| D. Con el volante anterior | agregar el último comando de dirección | ¿reduce la diferencia con el experto? |
| E. Apiladas | 3 observaciones apiladas | ¿hay situaciones que solo se distinguen en el tiempo? |
| F. Con rivales | posición y velocidad relativa de los autos más cercanos | ¿aparecen maniobras de adelantamiento? (exige entrenar con varios autos por arena) |
Requisitos para que la comparación signifique algo:
- Mismo build, misma recompensa, mismo presupuesto de pasos. La séptima corrida mostró lo que pasa si no.
- Varias semillas por variante, con media y dispersión.
- Evaluar con
eval.exe, no con la recompensa (parte 6): motivos de fin de episodio, fracción de vuelta, freno medio. - Una prueba fuera del circuito fijo para la variante B: las pistas procedurales siguen en el código, detrás de una opción que hay que desactivar y recompilar, y son la forma de saber si la policy aprendió a conducir o aprendió el circuito.
- Verificar la tubería en cada cambio: que el tamaño negociado coincida y que el log no tenga rellenos con ceros.
| Métrica | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| Vueltas completas | ? | ? | ? | ? | ? | ? |
| Fracción de vuelta | ? | ? | ? | ? | ? | ? |
| Freno medio | ? | ? | ? | ? | ? | ? |
| Resultado en pistas no vistas | ? | ? | ? | ? | ? | ? |
Nada de esto se ejecutó.
13. ¿Cómo sabemos si una observación es buena?
No hay una puntuación universal, pero sí cinco preguntas, cada una con su respuesta en el proyecto:
| Prueba | Pregunta | En Agentic Racing |
|---|---|---|
| Suficiencia | ¿hay situaciones distintas que se ven igual? | sí: las que dependen de la memoria del experto, y cualquier situación con rivales |
| Utilidad | ¿agregar la señal mejora de forma repetible? | no se sabe: el único cambio se mezcló con otro |
| Robustez | ¿funciona con otras pistas y arranques? | no se probó; el progreso en la vuelta es un riesgo en el circuito fijo |
| Disponibilidad | ¿la señal existe donde se usará la policy? | sí: todo se calcula en el mismo simulador |
| Costo | ¿vale lo que cuesta producirla? | barata: 42 números y 9 rayos, sin cámaras |
Conclusión
Diseñar la observación es decidir, en parte, qué problema resuelve el agente. El piloto de Agentic Racing resuelve un problema concreto: conducir viendo muros a 70 metros, su propia velocidad, cómo se curva la pista hasta 75 metros y lo que le pide el estratega. No resuelve el problema de correr contra otros autos, porque no puede verlos.
Las lecciones que deja el proyecto:
- las escalas importan, pero normalizar no reemplaza la información que falta;
- anticipar exige observar el futuro cercano, y hay que preguntarse si esa información existirá donde se use la policy;
- una policy sin memoria no puede copiar a un experto que sí la tiene;
- la misma variable puede ser relativa con muchas pistas y un código de posición con una sola;
- una directiva solo puede modular lo que el piloto puede percibir;
- cambiar la observación y la recompensa a la vez impide saber qué funcionó;
- y hay que verificar que lo que llega a la red es lo que creemos que mandamos.
No se trata de que el agente vea todo. Se trata de que vea lo necesario para la conducta que buscamos, con información que realmente tendrá.
Si llegaste directo a este artículo, las seis partes anteriores están enlazadas al principio, y Agentic Racing: un piloto que nunca aprendió a manejar cuenta la historia completa del proyecto.
Referencias
- Sutton, R. S. y Barto, A. G. (2018). Reinforcement Learning: An Introduction, 2.ª edición. MIT Press.
- Kaelbling, L. P., Littman, M. L. y Cassandra, A. R. (1998). Planning and Acting in Partially Observable Stochastic Domains. Artificial Intelligence, 101(1–2), 99–134.
- Schulman, J. et al. (2017). Proximal Policy Optimization Algorithms.
- Ho, J. y Ermon, S. (2016). Generative Adversarial Imitation Learning. NeurIPS.
- Unity Technologies. Unity ML-Agents Toolkit, release de
mlagents1.1.0: la sección de observaciones dedocs/Learning-Environment-Design-Agents.md(normalización, apilado, one-hot, coordenadas relativas, rayos) ynetwork_settings(normalize,memory) endocs/Training-Configuration-File.md. - Las observaciones (
RaceAgent.CollectObservationsenunity/Assets/Scripts/Agents/RaceAgent.cs), el sensor de rayos (TrainingArena.cs), la telemetría del estratega (Strategy/RaceTelemetry.cs) y la bitácora están en github.com/alulema/agentic-racing.